Hướng dẫn nhập môn lập trình CUDA
Đi qua mô hình lập trình CUDA, hệ thống phân cấp bộ nhớ và các tối ưu toán tử phổ biến để bạn triển khai và tinh chỉnh kernel AI hiệu quả
CUDA là cầu nối giữa thuật toán AI và phần cứng GPU. Nó biến toán học mức cao thành lệnh máy mà GPU chạy được hiệu quả nhất có thể. Hướng dẫn này bắt đầu từ mô hình lập trình và hệ thống phân cấp bộ nhớ, đi qua Reduce / GEMM / Softmax như ba toán tử kinh điển, rồi tới kernel Attention kiểu FlashAttention và trình biên dịch Triton. Ghép lại, đó là nền CUDA mà hầu hết kỹ sư AI Infra cần.
Mục lục
- 1. Cấu hình môi trường
- 2. Mô hình lập trình CUDA
- 3. Mô hình bộ nhớ
- 4. Khái niệm then chốt
- 5. Chương trình hoàn chỉnh đầu tiên: cộng vector
- 6. Toán tử phổ biến: triển khai và tối ưu
- 7. Toán tử Attention
- 8. Trình biên dịch AI
- 9. Công cụ profiling
- 10. Chủ đề nâng cao: ghép các ý lại
- 11. Danh sách tự kiểm
- Tài liệu tham khảo
1. Cấu hình môi trường
1.1 Yêu cầu phần cứng
- GPU NVIDIA (Compute Capability >= 7.0, Volta trở lên)
- Khuyến nghị ít nhất 8GB VRAM để phát triển và debug toán tử
Compute Capability là gì? Đó là “phiên bản khả năng” của NVIDIA cho GPU: thế hệ PTX nào và tính năng phần cứng nào nó hỗ trợ. Ví dụ
sm_90là Hopper (H100),sm_100là Blackwell (B200). Biết số này giúp đọc cờ-arch=, và giải thích vì sao cùng một binary có thể không chạy trên card cũ hơn.
1.2 Cài phần mềm
Cài CUDA Toolkit
# Ubuntu 22.04
wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2204/x86_64/cuda-keyring_1.1-1_all.deb
sudo dpkg -i cuda-keyring_1.1-1_all.deb
sudo apt-get update
sudo apt-get install cuda-toolkit-12-3

# Set environment variables (add to ~/.bashrc or ~/.zshrc)
export PATH=/usr/local/cuda/bin:$PATH
export LD_LIBRARY_PATH=/usr/local/cuda/lib64:$LD_LIBRARY_PATH
Kiểm tra cài đặt
nvcc --version          # CUDA compiler version
nvidia-smi              # GPU info and driver version
1.3 Cơ bản về biên dịch
Source CUDA dùng đuôi .cu và biên dịch bằng nvcc:
# Basic compile
nvcc hello.cu -o hello

# Target a GPU architecture (recommended)
nvcc -arch=sm_80 hello.cu -o hello    # A100
nvcc -arch=sm_90 hello.cu -o hello    # H100

# Print register and shared-memory usage (essential when tuning)
nvcc -Xptxas -v hello.cu -o hello
Sau biên dịch chuyện gì xảy ra? Trình biên dịch GPU không phát machine code trong một bước. Nó trước hết sinh PTX (ISA / IR ảo), rồi JIT biên dịch thành SASS (streaming assembler, lệnh thật cho thế hệ GPU đó) trên GPU đích hoặc khi driver cài đặt. Đó là vì sao một source CUDA có thể chạy sau này trên GPU vật lý mới: miễn phần cứng mới hỗ trợ phiên bản PTX đó, driver JIT ra SASS khớp. Một khi thấy vậy, các cờ kiểu -arch=sm_90 mới có nghĩa: chúng bảo trình biên dịch “sinh code cho phần cứng lớp H100.”
2. Mô hình lập trình CUDA
2.1 Kernel
Kernel là hàm chạy trên GPU. Bạn khai báo bằng __global__ và launch bằng <<<gridDim, blockDim>>> để đặt hình dạng song song:
// Declare a kernel
__global__ void myKernel(float* data, int n) {
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (idx < n) {
        data[idx] *= 2.0f;
    }
}

// Launch: 128 Blocks, 256 threads per Block
myKernel<<<128, 256>>>(data, n);
CUDA có ba qualifier hàm:
| Qualifier | Chạy ở đâu | Ai gọi được | Ghi chú |
|---|---|---|---|
__global__ | GPU | CPU (hoặc GPU) | Kernel; launch công việc song song trên GPU |
__device__ | GPU | GPU | Hàm device; chỉ gọi từ kernel hoặc hàm device khác |
__host__ | CPU | CPU | Hàm CPU thường (mặc định; có thể bỏ) |
Bạn có thể kết hợp __host__ và __device__ để trình biên dịch sinh cả bản CPU lẫn GPU.
Thuật ngữ: Kernel, Grid và CTA. Ở mức PTX/SASS, một thread block (Block) là Cooperative Thread Array (CTA). Nhiều Block tạo thành Grid, tập đầy đủ các thread do một lần launch kernel tạo ra. Grid trải trên cả GPU, nên kernel là đơn vị song song lớn nhất bạn điều khiển với tư cách lập trình viên.
Trên phần cứng, một Block được lập lịch lên một Streaming Multiprocessor (SM). Số SM bạn có quyết định bao nhiêu Block chạy đồng thời. Thread trong cùng Block hợp tác chặt (shared memory, barrier sync). Thread ở Block khác chỉ hợp tác gián tiếp qua global memory và atomic, và thứ tự của chúng không xác định, nên khi viết kernel bạn không được giả định Block nào chạy trước.
2.2 Hệ phân cấp Grid / Block / Thread
CUDA tổ chức thread theo ba cấp. Hệ phân cấp đó là trái tim của lập trình song song ở đây. Hãy nghĩ “trường / lớp / học sinh”: Grid là trường, Block là lớp, Thread là học sinh. Mỗi học sinh làm việc riêng, nhưng bạn cùng lớp nói chuyện qua “bảng đen” (Shared Memory).
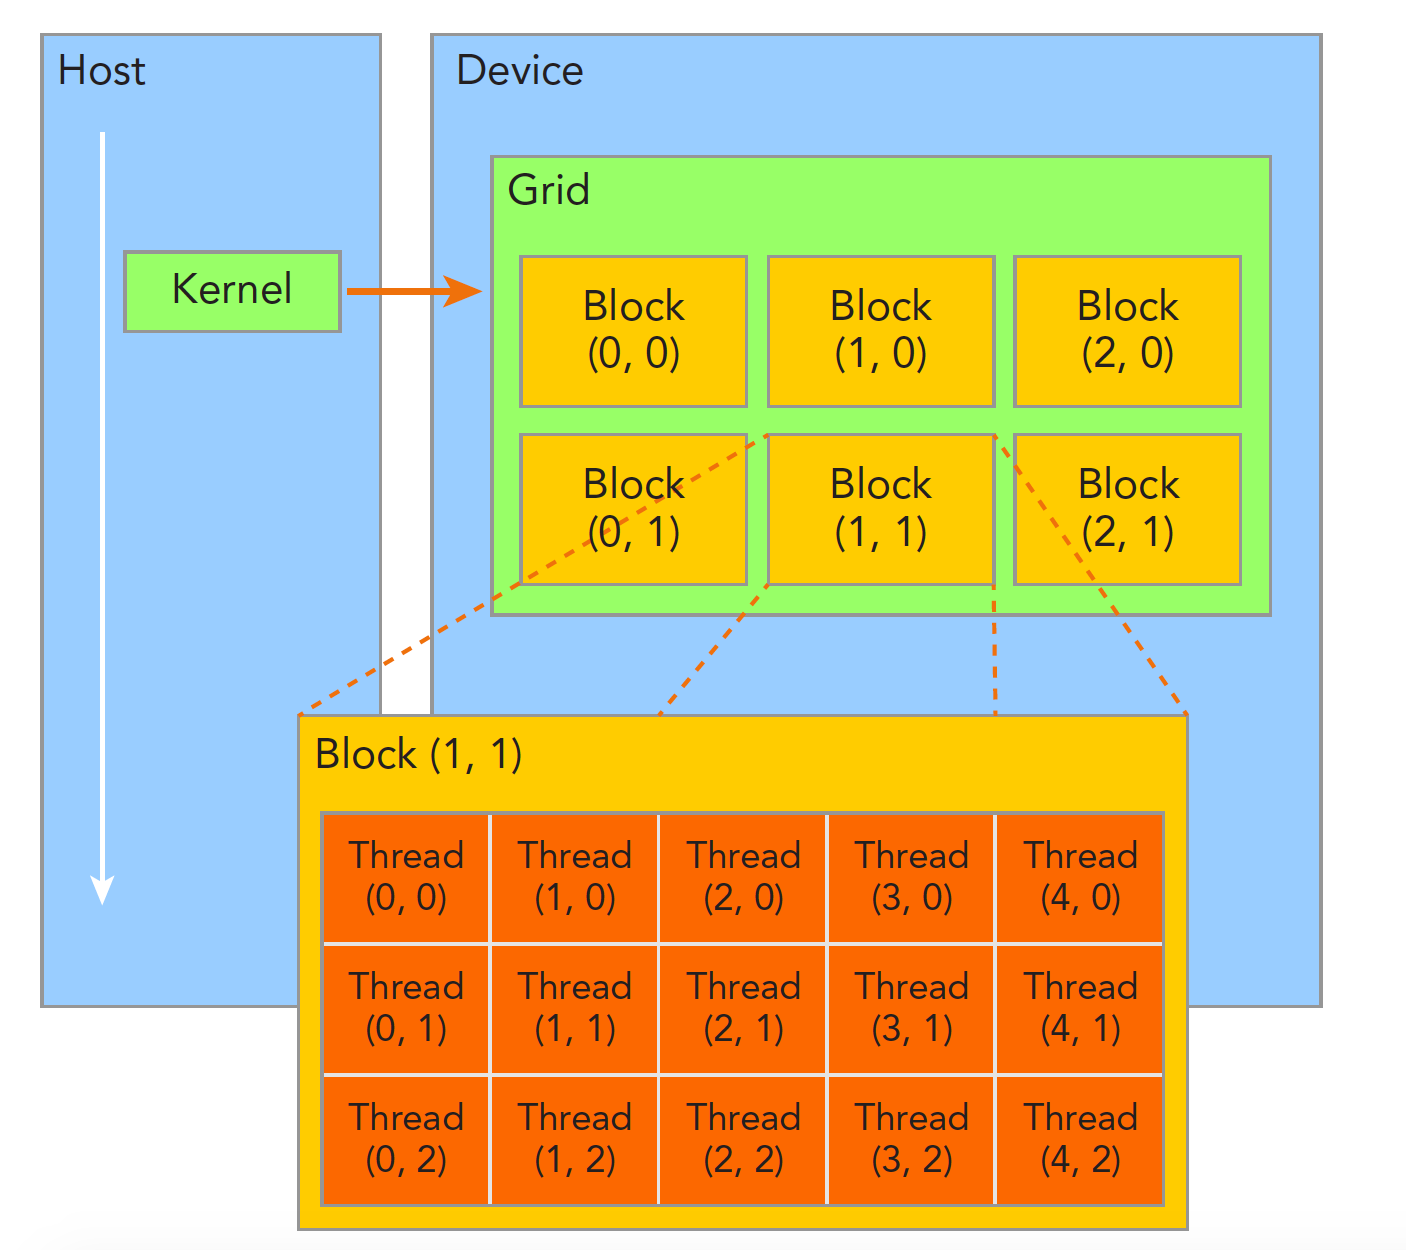
Chiều và chỉ số
Grid và Block đều hỗ trợ 1D, 2D và 3D. Chỉ số thread toàn cục trông như sau:
// 1D (most common)
int idx = blockIdx.x * blockDim.x + threadIdx.x;

// 2D (common for matrix work)
int row = blockIdx.y * blockDim.y + threadIdx.y;
int col = blockIdx.x * blockDim.x + threadIdx.x;

// dim3 for 2D launch geometry
dim3 blockDim(16, 16);     // 16x16 = 256 threads per Block
dim3 gridDim(
    (width + 15) / 16,     // Blocks in x
    (height + 15) / 16     // Blocks in y
);
kernel<<<gridDim, blockDim>>>(data, width, height);
Giới hạn cứng
| Tham số | Giới hạn |
|---|---|
| Thread mỗi Block | tối đa 1024 |
| Block mỗi chiều Grid | tối đa 2^31 - 1 (x), 65535 (y, z) |
| Thread active mỗi SM | tối đa 2048 (64 Warp) |
| Block active mỗi SM | tối đa 32 |
Heuristic kích thước Block
- 256: mặc định tốt cho hầu hết trường hợp (8 Warp)
- 128: công việc nặng bộ nhớ khi bạn muốn nhiều Block đồng thời hơn
- 512-1024: công việc nặng compute; để ý áp lực register và shared memory
- Luôn là bội của 32: khớp kích thước Warp và tránh lane ngồi không
Các giới hạn này đến từ cách công việc đáp xuống phần cứng. Thread chạy trên CUDA Core (ALU vô hướng) hoặc Tensor Core (đơn vị ma trận) của SM. Một khi Block được lập lịch lên SM, nó tiêu thụ register file, shared memory / L1 data cache, và slot Warp của SM đó. Kích thước Block xấu có thể khiến SM chỉ chứa được vài Block dù logic đúng, và bạn mất occupancy song song.
Hình dung SM như một “hộp CPU nhỏ”: vài CUDA Core, vài Tensor Core, một register file, một L1 data cache (một phần có thể map thành shared memory), và vài Warp scheduler. Mỗi chu kỳ một scheduler chọn một Warp sẵn sàng và phát một lệnh. Khi Warp stall vì bộ nhớ, scheduler chuyển sang Warp khác. Giữ nhiều Warp đang bay để che latency là một trong những khác biệt thiết kế lớn nhất giữa GPU và CPU.
2.3 Quản lý bộ nhớ
CUDA làm tường minh bộ nhớ Host (CPU) và Device (GPU):
float* d_data;  // d_ prefix means device memory

// 1. Allocate GPU memory
cudaMalloc(&d_data, n * sizeof(float));

// 2. CPU → GPU copy
cudaMemcpy(d_data, h_data, n * sizeof(float), cudaMemcpyHostToDevice);

// 3. Run kernel
myKernel<<<gridDim, blockDim>>>(d_data, n);

// 4. GPU → CPU copy
cudaMemcpy(h_data, d_data, n * sizeof(float), cudaMemcpyDeviceToHost);

// 5. Free GPU memory
cudaFree(d_data);
Copy bất đồng bộ và Stream
Mặc định cudaMemcpy là đồng bộ (chặn CPU). Stream cho phép chồng copy bất đồng bộ với compute:
cudaStream_t stream;
cudaStreamCreate(&stream);

// Async copy (CPU does not block)
cudaMemcpyAsync(d_data, h_data, size, cudaMemcpyHostToDevice, stream);

// Launch kernel on the same stream (waits for the copy to finish)
myKernel<<<gridDim, blockDim, 0, stream>>>(d_data, n);

// Async copy results back
cudaMemcpyAsync(h_data, d_data, size, cudaMemcpyDeviceToHost, stream);

// Wait for everything in the stream
cudaStreamSynchronize(stream);
cudaStreamDestroy(stream);
Với copy bất đồng bộ, bộ nhớ Host phải là pinned memory. Không thì tốc độ truyền giảm mạnh:
float* h_pinned;
cudaMallocHost(&h_pinned, size);  // allocate pinned memory; transfers ~2-3x faster
// ... use it ...
cudaFreeHost(h_pinned);            // free pinned memory
2.4 Xử lý lỗi
Lời gọi CUDA API có thể thất bại. Code production phải kiểm tra lỗi:
#define CUDA_CHECK(call) do { \
    cudaError_t err = call; \
    if (err != cudaSuccess) { \
        fprintf(stderr, "CUDA error at %s:%d: %s\n", \
                __FILE__, __LINE__, cudaGetErrorString(err)); \
        exit(EXIT_FAILURE); \
    } \
} while(0)

// Usage
CUDA_CHECK(cudaMalloc(&d_data, size));
CUDA_CHECK(cudaMemcpy(d_data, h_data, size, cudaMemcpyHostToDevice));

// After a kernel launch
myKernel<<<gridDim, blockDim>>>(d_data, n);
CUDA_CHECK(cudaGetLastError());           // launch-parameter errors
CUDA_CHECK(cudaDeviceSynchronize());      // execution errors
3. Mô hình bộ nhớ
Hệ phân cấp bộ nhớ của CUDA là lõi của công việc hiệu năng. “Pattern truy cập quyết định tốc độ” là trực giác chính cần giữ.
3.1 Tổng quan hệ phân cấp lưu trữ
Registers                       ← fastest; private per thread
  │  ~20 TB/s, ~0 cycle
  ▼
Shared Memory                   ← programmable on-chip cache; shared in a Block
  │  ~20 TB/s, ~20-30 cycles
  ▼
L1 / L2 Cache                   ← hardware-managed caches
  │  L2: ~12 TB/s, ~200 cycles
  ▼
Global Memory (HBM)             ← "VRAM"; visible to all threads
  │  ~3.35 TB/s (H100), ~400-600 cycles
  ▼
Host / CPU Memory               ← needs PCIe transfers
     ~64 GB/s (PCIe 5.0)
Hai điểm từ hình đó đáng nhớ:
- Càng cao trong stack càng nhanh và càng nhỏ (và càng đắt): register riêng tư và nhanh nhất; shared memory nằm on-chip và theo phạm vi Block; global memory nằm trong HBM, mọi Block tới được, latency cao nhất.
- Programmable vs tự động: register, shared memory và global memory thường được quản lý tường minh; L1/L2 chủ yếu tự động, dù một phần L1 data cache trong cùng có thể “mượn” làm shared memory. Sự tách đó trung tâm với tối ưu GEMM, FlashAttention và các kernel tương tự.
Về thuật ngữ, L1 data cache của SM là SRAM và chậm hơn register khoảng một bậc độ lớn; global memory là DRAM: dung lượng lớn, latency dài. GPU nhanh không vì không có latency bộ nhớ, mà vì chúng giữ đủ Warp sẵn sàng để chuyển và che latency đó.
3.2 Register
Register là lưu trữ nhanh nhất. Biến cục bộ trong kernel mặc định nằm ở register:
__global__ void kernel(float* data, int n) {
    // a, b, result all live in registers
    float a = data[threadIdx.x];
    float b = a * 2.0f;
    float result = a + b;
    data[threadIdx.x] = result;
}
Lưu ý:
- Mỗi SM có ngân sách register cố định (H100: 65536 register 32-bit mỗi SM)
- Nhiều register mỗi thread nghĩa là ít thread đồng thời hơn trên SM (Occupancy thấp hơn)
- Tràn spill sang Local Memory (thực ra là HBM), và tốc độ sụp
Kiểm tra mức dùng register:
nvcc -Xptxas -v kernel.cu
# Output: ptxas info: Used 32 registers, 0 bytes smem
# "stack frame" or "spill" means overflow
3.3 Shared Memory
Shared memory là cache on-chip do lập trình viên điều khiển: “bảng đen” cho các thread trong một Block. Thứ một thread ghi, các thread khác trong Block đó thấy được, và đọc/ghi nhanh hơn nhiều so với global memory. Pattern thường gặp là cache dữ liệu nạp từ global memory để các thread trong Block tái sử dụng.
__global__ void sharedMemDemo(float* input, float* output, int n) {
    // Statically allocate shared memory
    __shared__ float smem[256];

    int idx = blockIdx.x * blockDim.x + threadIdx.x;

    // 1. Load from global memory into shared memory
    if (idx < n) {
        smem[threadIdx.x] = input[idx];
    }

    // 2. Sync: wait until every thread has loaded
    __syncthreads();

    // 3. Read shared memory (including a neighbor; very fast)
    if (idx < n && threadIdx.x > 0) {
        output[idx] = smem[threadIdx.x] + smem[threadIdx.x - 1];
    }
}
Shared memory động — kích thước chọn lúc launch:
extern __shared__ float dynamic_smem[];

kernel<<<gridDim, blockDim, sharedMemBytes>>>(args);
3.4 Global Memory / HBM
Global memory là “VRAM”: dung lượng lớn nhất, chậm nhất. Con trỏ từ cudaMalloc và tham số con trỏ của kernel trỏ vào đây.
Coalesced Access là quy tắc vàng cho global memory: 32 thread trong một Warp nên chạm địa chỉ liên tiếp để phần cứng gộp chúng thành vài transaction bộ nhớ. Hãy nghĩ người lấy đồ trên băng chuyền theo thứ tự: một vòng là xong. Nếu ai cũng lấy offset ngẫu nhiên, băng chuyền phải đi đi lại lại nhiều lần.
// Good: coalesced — neighboring threads hit neighboring addresses
float val = data[threadIdx.x];        // one 128B transaction

// Bad: strided — neighboring threads hit spaced addresses
float val = data[threadIdx.x * stride]; // many transactions; wasted bandwidth

// Bad: random — cannot coalesce
float val = data[random_index[threadIdx.x]];
Tối ưu layout — AoS sang SoA:
// AoS (Array of Structures) — unfriendly to GPUs
struct Particle { float x, y, z, w; };
Particle particles[N];
// Reading all x: particles[0].x, particles[1].x, ... stride 16B

// SoA (Structure of Arrays) — GPU-friendly
struct Particles {
    float x[N];  // all x values contiguous
    float y[N];
    float z[N];
    float w[N];
};
// Reading all x: contiguous, perfectly coalesced
3.5 Constant Memory
Tốt nhất khi mọi thread đọc cùng một giá trị (broadcast), với cache riêng:
__constant__ float coefficients[256];  // max 64KB

// Write from the CPU
cudaMemcpyToSymbol(coefficients, h_coeffs, 256 * sizeof(float));

// Read on the GPU (fastest when all threads hit the same address)
float c = coefficients[idx];
3.6 Tóm tắt mô hình bộ nhớ
| Lưu trữ | Vị trí | Phạm vi | Tốc độ | Dung lượng | Điều khiển bởi lập trình viên |
|---|---|---|---|---|---|
| Registers | On-chip | Mỗi thread | Nhanh nhất | ~255 mỗi thread | Cấp phát tự động |
| Shared Memory | On-chip | Chia sẻ trong Block | Rất nhanh | ~228KB mỗi SM | Thủ công |
| L1/L2 Cache | On-chip | Tự động | Nhanh | L2 ~50MB | Tự động (có thể hint) |
| Global Memory | HBM | Mọi thread | Chậm | 80-192GB | Thủ công |
| Constant Memory | HBM + cache | Mọi thread (chỉ đọc) | Nhanh khi broadcast | 64KB | Thủ công |
4. Khái niệm then chốt
4.1 Warp
Warp là đơn vị lập lịch nhỏ nhất trên GPU: 32 thread liên tiếp. Thread trong một Warp thực thi cùng một lệnh cùng lúc (SIMT). Hãy nghĩ 32 người lính đi đều bước: nếu một số rẽ trái và một số rẽ phải, một nhóm xong trước trong khi nhóm kia chờ, và bạn mất khoảng nửa throughput.
Block (256 threads)
├── Warp 0: Thread 0-31
├── Warp 1: Thread 32-63
├── Warp 2: Thread 64-95
├── ...
└── Warp 7: Thread 224-255
Warp Divergence
Khi thread trong một Warp đi các nhánh if/else khác nhau, cả hai nhánh chạy tuần tự và hiệu năng gần như giảm một nửa:
// Bad: half the Warp takes if, half takes else
if (threadIdx.x < 16) {
    doA();  // threads 0-15 run; 16-31 wait
} else {
    doB();  // threads 16-31 run; 0-15 wait
}

// Good: whole Warp takes the same branch
if (threadIdx.x / 32 < someValue) {  // branch at Warp granularity
    doA();  // whole Warp executes
}
Primitive cấp Warp
Thread trong một Warp có thể trao đổi dữ liệu trực tiếp, không cần shared memory:
// Warp Shuffle: exchange register values between threads
float val = __shfl_down_sync(0xFFFFFFFF, myVal, delta);
// thread i gets the value from thread i+delta

float val = __shfl_xor_sync(0xFFFFFFFF, myVal, mask);
// thread i gets the value from thread i^mask (butterfly exchange)

// Warp-level reduce (Volta+)
float sum = __reduce_add_sync(0xFFFFFFFF, myVal);
// one instruction sums within the Warp
Warp vừa là chi tiết phần cứng vừa là đòn bẩy hiệu năng. Nói chặt, Warp không thuộc hệ phân cấp thread của mô hình lập trình CUDA (Thread → Block → Grid); nó là cách GPU hiện thực mô hình đó. Hơi giống cache line của CPU: correctness vẫn phải đúng dù sao, nhưng muốn nhanh thì phải hợp tác với nó.
Về phần cứng, mỗi SM có vài Warp scheduler. Mỗi chu kỳ chúng chọn một Warp sẵn sàng và phát một lệnh. Throughput GPU không đến từ việc làm một thread thông minh; nó đến từ nuôi đủ nhiều Warp để khi một Warp stall vì bộ nhớ thì Warp khác chạy được. Đó là latency hiding. Để nó hoạt động bạn cần đủ Warp active trên SM, nên Block quá nhỏ, dùng register quá nặng, hoặc shared memory quá lớn khiến GPU “không còn gì để làm.”
4.2 Bank Conflict
Shared memory được chia thành 32 Bank, mỗi bank rộng 4 byte. Nếu các thread khác nhau trong cùng Warp chạm địa chỉ khác nhau trong cùng một Bank, bạn gặp Bank Conflict và các truy cập bị serialize. Hình dung 32 Bank như 32 quầy giao dịch: nếu nhiều thread xếp hàng một quầy, chúng phải chờ; lý tưởng mỗi thread tới một quầy khác và tất cả xong cùng lúc.
__shared__ float smem[32][32];

// No Bank Conflict: each thread hits a different Bank
float val = smem[0][threadIdx.x];  // thread i → Bank i

// 32-way Bank Conflict: every thread hits the same Bank
float val = smem[threadIdx.x][0];  // column access; all hit Bank 0

// Classic fix: padding
__shared__ float smem[32][33];     // extra column shifts the Banks
float val = smem[threadIdx.x][0];  // now thread i → Bank i; no conflict
Phát hiện Bank Conflict
ncu --metrics l1tex__data_bank_conflicts_pipe_lsu_mem_shared_op_ld.sum ./app
# 0 means no Bank Conflict
Thêm một ghi chú thuật ngữ: shared memory được tổ chức thành 32 Bank mỗi bank 4 byte; các word 4-byte liên tiếp map sang các Bank kế tiếp. Vậy “truy cập liên tiếp” nghĩa là coalescing ở global memory và không Bank Conflict ở shared memory; truy cập stride dồn thread vào cùng Bank và serialize chúng. AoS → SoA là thực hành layout để tránh stride đó.
4.3 Occupancy
Occupancy = Warp active / Warp tối đa mỗi SM. Nó đo bạn đang dùng bao nhiêu dung lượng song song của GPU.
Ba yếu tố đẩy Occupancy:
| Yếu tố | Ảnh hưởng | Hướng tinh chỉnh |
|---|---|---|
| Register mỗi thread | Nhiều register → ít thread mỗi SM | Ít biến cục bộ hơn; kiểm soát unrolling |
| Shared memory mỗi Block | Nhiều smem → ít Block mỗi SM | Cấp phát cẩn thận; tránh lãng phí |
| Kích thước Block | Quá nhỏ hoặc quá lớn đều hại | 256 là điểm khởi đầu phổ biến |
// Let the runtime suggest a Block size
int minGridSize, blockSize;
cudaOccupancyMaxPotentialBlockSize(&minGridSize, &blockSize, myKernel, 0, 0);
printf("Optimal block size: %d\n", blockSize);
Quan trọng: Occupancy cao hơn không phải lúc nào cũng tốt hơn. Với kernel nặng Tensor Core, Occupancy 25-50% đã có thể đạt peak. Trước hết đảm bảo không có register spill; rồi mới nghĩ tới Occupancy.
Vì sao không phải “cao hơn luôn tốt hơn”? Việc của Occupancy là “đủ Warp active để che latency.” Một khi bạn đã phủ thời gian chờ bộ nhớ, thêm Warp chỉ tranh không gian register mỗi thread, thu hẹp shared memory mỗi Block, hoặc tăng áp lực sync và cache. GEMM hiệu năng cao đôi khi chạy Occupancy thấp miễn Tensor Core vẫn được nuôi đủ. Mục tiêu thật là tận dụng cao tài nguyên khan (compute hoặc băng thông bộ nhớ), không phải Occupancy vì chính nó.
4.4 Đơn vị phần cứng: SM / CUDA Core / Tensor Core
Phần này ghép các mảnh phần cứng đã nhắc trước. Với công việc AI Infra, giữ ít nhất mô hình tinh thần này:
| Thuật ngữ | Vai trò | Trực giác |
|---|---|---|
| SM (Streaming Multiprocessor) | “Hộp lõi” của GPU; giống core CPU, nhưng chứa nhiều Warp cùng lúc thay vì dự đoán nhánh phức tạp | H100 có 132 SM |
| CUDA Core | ALU vô hướng trong SM; integer, FP32/FP64, v.v. | ”Đơn vị compute thường” |
| Tensor Core | Đơn vị nhân-cộng ma trận chuyên dụng; một lệnh phủ một tile MMA lớn | Nguồn FLOPs AI hiện đại chính |
| Warp Scheduler | Mỗi chu kỳ chọn một Warp và phát lệnh | ”Mỗi chu kỳ, chọn một Warp để làm việc” |
| Register File | Hồ register nhanh cho mọi thread trên SM | Bộ hạn Occupancy then chốt |
| L1 data cache / Shared Memory | SRAM on-chip riêng cho SM; shared memory do lập trình viên quản lý | Vùng staging cho GEMM và FlashAttention |
Ví dụ: một SM H100 thường có 128 CUDA Core FP32, 4 Tensor Core, 4 Warp Scheduler, và có thể chứa tới 64 Warp (2048 thread đồng thời). FLOPs Tensor Core thường gấp hàng chục đến hàng trăm lần FLOPs CUDA Core, nên kernel AI hiện đại cố gắng nuôi phép nhân ma trận vào Tensor Core thay vì nghiền chúng trên CUDA Core thường.
4.5 Trần hiệu năng: arithmetic intensity và Roofline
Câu hỏi thường gặp khi viết kernel là “sao chậm vậy?” Hầu hết lúc câu trả lời là memory-bound hoặc compute-bound.
- Memory-bound: giới hạn là tốc độ dữ liệu từ VRAM vào SM (băng thông bộ nhớ).
- Compute-bound: giới hạn là throughput số học của CUDA Core hoặc Tensor Core.
Để phân biệt, dùng ý Roofline đơn giản: ước lượng “bao nhiêu phép số học bạn làm trên mỗi byte di chuyển.” Tỷ lệ đó là arithmetic intensity. Intensity cao nghiêng về compute-bound; thấp nghiêng về memory-bound.
Elementwise add / ReLU đọc một float và làm một hoặc hai phép, nên intensity rất nhỏ và thường memory-bound. Đó là vì sao fusion giúp nhiều: nó gộp vài bước memory-bound và bỏ traffic HBM trung gian. Nhân ma trận là O(N³) compute / O(N²) memory, nên intensity tăng theo N và tự khớp GPU; với Tiling để cắt chuyến đi global memory bạn có thể tiến gần trần compute.
Trong Nsight Compute, xem Compute (SM) Throughput và Memory Throughput để biết bạn đang dưới trần nào.
Để có cảm giác cụ thể, bảng dưới liệt kê “ridge point” (intensity nơi bound đổi từ memory sang compute) cho BF16 Tensor Core trên vài GPU datacenter:
| Hệ thống | Băng thông số học (TFLOPs/s) | Băng thông bộ nhớ (TB/s) | Ridge point (FLOPs/byte) |
|---|---|---|---|
| A100 80GB SXM / HBM2e | ~312 | ~2 | ~156 |
| H100 SXM / HBM3 | ~989 | ~3.35 | ~295 |
| B200 / HBM3e | ~2250 | ~8 | ~281 |
Trực giác: trên A100 bạn cần khoảng “156 FLOPs mỗi byte di chuyển” trước khi hy vọng chạm trần compute. Hầu hết ops elementwise không bao giờ tới gần, nên chúng đụng tường bộ nhớ trước.
5. Chương trình hoàn chỉnh đầu tiên: cộng vector
Ghép các mảnh thành một chương trình cộng vector đầy đủ:
#include <stdio.h>
#include <cuda_runtime.h>

#define CUDA_CHECK(call) do { \
    cudaError_t err = call; \
    if (err != cudaSuccess) { \
        fprintf(stderr, "CUDA error at %s:%d: %s\n", \
                __FILE__, __LINE__, cudaGetErrorString(err)); \
        exit(EXIT_FAILURE); \
    } \
} while(0)

// Kernel: vector add
__global__ void vectorAdd(const float* a, const float* b, float* c, int n) {
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (idx < n) {
        c[idx] = a[idx] + b[idx];
    }
}

int main() {
    const int N = 1 << 20;  // 1M elements
    size_t bytes = N * sizeof(float);

    // Host allocation and init
    float* h_a = (float*)malloc(bytes);
    float* h_b = (float*)malloc(bytes);
    float* h_c = (float*)malloc(bytes);
    for (int i = 0; i < N; i++) {
        h_a[i] = 1.0f;
        h_b[i] = 2.0f;
    }

    // Device allocation
    float *d_a, *d_b, *d_c;
    CUDA_CHECK(cudaMalloc(&d_a, bytes));
    CUDA_CHECK(cudaMalloc(&d_b, bytes));
    CUDA_CHECK(cudaMalloc(&d_c, bytes));

    // Host → Device
    CUDA_CHECK(cudaMemcpy(d_a, h_a, bytes, cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_b, h_b, bytes, cudaMemcpyHostToDevice));

    // Grid / Block dims
    int blockSize = 256;
    int gridSize = (N + blockSize - 1) / blockSize;

    // Launch
    vectorAdd<<<gridSize, blockSize>>>(d_a, d_b, d_c, N);
    CUDA_CHECK(cudaGetLastError());

    // Device → Host
    CUDA_CHECK(cudaMemcpy(h_c, d_c, bytes, cudaMemcpyDeviceToHost));

    // Verify
    for (int i = 0; i < N; i++) {
        if (h_c[i] != 3.0f) {
            printf("Error at index %d: %f\n", i, h_c[i]);
            break;
        }
    }
    printf("Vector addition completed successfully!\n");

    // Free
    free(h_a); free(h_b); free(h_c);
    cudaFree(d_a); cudaFree(d_b); cudaFree(d_c);
    return 0;
}
Build và chạy:
nvcc -arch=sm_80 vector_add.cu -o vector_add && ./vector_add
6. Toán tử phổ biến: triển khai và tối ưu
Thành thạo ba toán tử kinh điển này là bài tập CUDA bắt buộc. Chúng phủ reduction, nhân ma trận và normalization.
6.1 Reduce (parallel reduction)
Reduce gộp một tập giá trị thành một (sum, max, v.v.). Đó là cách tốt để vào tư duy song song CUDA.
Ý tưởng cơ bản: tree reduction
Hình dung 1024 người, mỗi người cầm một số. Ghép đôi và cộng; mỗi vòng số lượng giảm một nửa — 10 vòng là có tổng. Trên GPU, thread trong một Block hợp tác làm tương tự:
Initial: [1, 2, 3, 4, 5, 6, 7, 8]
Round 1 (step=4): tid 0~3 each add tid+4 → [6, 8, 10, 12, ...]
Round 2 (step=2): tid 0~1 each add tid+2 → [16, 20, ...]
Round 3 (step=1): tid 0 adds tid+1       → [36, ...]
Triển khai naive
// Tree reduce: stride starts at blockDim/2 and shrinks so low-numbered threads stay contiguous
__global__ void reduce_base(float* input, float* output, int n) {
    extern __shared__ float smem[];
    int tid = threadIdx.x;
    int gid = blockIdx.x * blockDim.x + threadIdx.x;

    // Load global memory into shared memory
    smem[tid] = (gid < n) ? input[gid] : 0.0f;
    __syncthreads();

    // Large-to-small stride: within a Warp, threads are either all working or all idle
    for (int step = blockDim.x / 2; step > 0; step >>= 1) {
        if (tid < step) {
            smem[tid] += smem[tid + step];
        }
        __syncthreads();
    }

    // Write each Block's result back to global memory
    if (tid == 0) output[blockIdx.x] = smem[0];
}
💡 Đi từ lớn xuống nhỏ (không phải nhỏ lên lớn) quan trọng: ID thread đang active giữ liền kề, nên bạn tránh Warp Divergence kiểu “nửa làm việc, nửa ngồi không” trong một Warp, và scheduler vẫn hiệu quả.
Tối ưu 1: unroll Warp cuối
Khi step <= 32, chỉ còn một Warp (32 thread). Thread trong Warp vốn đã lockstep dưới SIMT, nên __syncthreads() không cần. Unroll các vòng cuối đó bỏ chi phí barrier thừa:
__device__ void warpReduce(volatile float* smem, int tid) {
    smem[tid] += smem[tid + 32];
    smem[tid] += smem[tid + 16];
    smem[tid] += smem[tid +  8];
    smem[tid] += smem[tid +  4];
    smem[tid] += smem[tid +  2];
    smem[tid] += smem[tid +  1];
}
__shfl_down_sync(mask, val, delta)cho phép mỗi thread đọc giá trị register từlane_id + deltatrực tiếp. Nhanh hơn Shared Memory (không tính địa chỉ, không Bank Conflict, latency thấp hơn).
Tối ưu 2: nhiều phần tử mỗi thread
Ở bản cơ sở mỗi thread nạp một phần tử. Nếu mỗi thread cộng hai phần tử trong pha nạp, bạn xử lý gấp đôi dữ liệu mà không tăng số Block, và nâng mức dùng thread:
__global__ void reduce_opt(float* input, float* output, int n) {
    extern __shared__ float smem[];
    int tid = threadIdx.x;
    int gid = blockIdx.x * (blockDim.x * 2) + threadIdx.x;

    // Each thread loads and accumulates 2 elements
    float val = 0.0f;
    if (gid < n)              val += input[gid];
    if (gid + blockDim.x < n) val += input[gid + blockDim.x];
    smem[tid] = val;
    __syncthreads();

    // Tree reduce (step > 32)
    for (int step = blockDim.x / 2; step > 32; step >>= 1) {
        if (tid < step) smem[tid] += smem[tid + step];
        __syncthreads();
    }

    // Last Warp reduces with Shuffle
    if (tid < 32) {
        warpReduce(smem, tid);
    }

    if (tid == 0) {
        output[blockIdx.x] = smem[0];
    }
}
📌 Reduce là op Memory-Bound kinh điển (arithmetic intensity chỉ 0.25 FLOP/Byte). Trọng tâm tối ưu là mức dùng băng thông bộ nhớ. Với mẹo nâng cao hơn (nạp vector hóa
float4, Grid Stride Loop, template unrolling, v.v.) xem Tối ưu toán tử CUDA Reduce.
6.2 GEMM (nhân ma trận)
GEMM (General Matrix Multiply) là lõi compute của mô hình lớn — linear layer và Attention bên dưới đều là nhân ma trận.
Triển khai naive
// C = A * B, A: MxK, B: KxN, C: MxN
__global__ void gemmNaive(float* A, float* B, float* C,
                           int M, int N, int K) {
    int row = blockIdx.y * blockDim.y + threadIdx.y;
    int col = blockIdx.x * blockDim.x + threadIdx.x;

    if (row < M && col < N) {
        float sum = 0.0f;
        for (int k = 0; k < K; k++) {
            sum += A[row * K + k] * B[k * N + col];
        }
        C[row * N + col] = sum;
    }
}
Vấn đề: mỗi thread độc lập đọc một hàng của A và một cột của B từ global memory, trùng lặp rất lớn.
Tối ưu 1: Shared Memory Tiling
Ý tưởng: cắt ma trận lớn thành Tile, nạp một Tile vào Shared Memory, và để mọi thread trong Block tái sử dụng. Như chuyển nhà khi đồ không vừa một chuyến: bạn mang một đợt lên bàn, sắp xếp ở đó, và tránh mỗi lần lại đi kho chậm.
#define TILE_SIZE 32

__global__ void gemmTiled(float* A, float* B, float* C,
                           int M, int N, int K) {
    __shared__ float As[TILE_SIZE][TILE_SIZE];
    __shared__ float Bs[TILE_SIZE][TILE_SIZE];

    int row = blockIdx.y * TILE_SIZE + threadIdx.y;
    int col = blockIdx.x * TILE_SIZE + threadIdx.x;
    float sum = 0.0f;

    // Iterate tiles along K
    for (int t = 0; t < (K + TILE_SIZE - 1) / TILE_SIZE; t++) {
        // Cooperative load of the Tile into shared memory
        int aCol = t * TILE_SIZE + threadIdx.x;
        int bRow = t * TILE_SIZE + threadIdx.y;

        As[threadIdx.y][threadIdx.x] = (row < M && aCol < K)
            ? A[row * K + aCol] : 0.0f;
        Bs[threadIdx.y][threadIdx.x] = (bRow < K && col < N)
            ? B[bRow * N + col] : 0.0f;

        __syncthreads();

        // Compute from shared memory (no global-memory traffic here)
        for (int k = 0; k < TILE_SIZE; k++) {
            sum += As[threadIdx.y][k] * Bs[k][threadIdx.x];
        }

        __syncthreads();
    }

    if (row < M && col < N) {
        C[row * N + col] = sum;
    }
}
Vì sao tiling hiệu quả:
- Không tiling: mỗi phần tử đọc từ HBM K lần; tổng traffic = MNK
- Có tiling: mỗi Tile đọc từ HBM một lần và tái sử dụng TILE_SIZE lần trong Shared Memory
- Mức tái sử dụng cải thiện TILE_SIZE×
Hướng tối ưu tiếp:
| Kỹ thuật | Hiệu ứng | Ghi chú |
|---|---|---|
Nạp vector hóa (float4) | Dùng băng thông HBM tốt hơn | Một lệnh nạp 16 byte |
| Register tiling | Mỗi thread tính vài output | Ít truy cập Shared Memory hơn |
| Double Buffering | Chồng nạp và compute | Prefetch Tile kế trong khi tính Tile hiện tại |
| Tensor Core (WMMA/CUTLASS) | Tăng theo bậc độ lớn | Nhân ma trận phần cứng |
Làm sao lập trình Tensor Core? Trong CUDA C++ bạn có thể dùng WMMA intrinsic (
wmma::mma_sync) hoặc gọi cuBLAS/CUTLASS. Trình biên dịch biến nhân-cộng ma trận thành SASS kiểuHMMA, thực thi hợp tác bởi cả một Warp. CUDA Core thường giỏi việc vô hướng; Tensor Core chỉ làm MMA. Vậy GEMM hiệu năng cao hiện đại chủ yếu là: cắt GEMM thành nhiều Tile, nuôi mỗi Tile vào Tensor Core, và dùng register tiling cộng double buffering để Tensor Core không bao giờ ngồi không.
Trên Hopper / Blackwell (H100/B200), hạt thực thi lớn từ một Warp thành Warpgroup (4 Warp, 128 thread), và TMA (Tensor Memory Accelerator) xử lý di chuyển dữ liệu bất đồng bộ. Hãy nghĩ TMA như một DMA mover: nó copy Tile lớn từ global memory vào layout shared-memory / register để kernel không cần mỗi Warp tự phát đống load chậm. Pipeline WGMMA và Ping-Pong của FlashAttention-3 chính là các mảnh này ghép trong một toán tử thật. Khi đọc FA3, “bất đồng bộ” là “TMA đang chuyển + Tensor Core đang tính + một Tile khác đã đang nạp” chồng lên nhau.
Trong production bạn thường gọi cuBLAS (BLAS tinh chỉnh cao của NVIDIA) hoặc CUTLASS (thư viện template tùy biến được):
#include <cublas_v2.h>

cublasHandle_t handle;
cublasCreate(&handle);

float alpha = 1.0f, beta = 0.0f;
// C = alpha * A * B + beta * C
cublasSgemm(handle, CUBLAS_OP_N, CUBLAS_OP_N,
            N, M, K, &alpha, d_B, N, d_A, K, &beta, d_C, N);

cublasDestroy(handle);
6.3 Softmax
Softmax nằm ở trung tâm Attention. Softmax hiệu quả phải xử lý ổn định số và parallel reduction.
Công thức
Trừ max(x) giữ toán ổn định và tránh exp overflow.
Triển khai naive (hai lượt)
__global__ void softmaxNaive(float* input, float* output, int N) {
    // Assume one Block handles one row
    __shared__ float smem[256];
    int tid = threadIdx.x;

    // 1. Find max (Reduce)
    float maxVal = -FLT_MAX;
    for (int i = tid; i < N; i += blockDim.x) {
        maxVal = fmaxf(maxVal, input[i]);
    }
    smem[tid] = maxVal;
    __syncthreads();
    // ... tree reduce for global max ...

    float globalMax = smem[0];
    __syncthreads();

    // 2. Sum of exp (Reduce)
    float sumExp = 0.0f;
    for (int i = tid; i < N; i += blockDim.x) {
        sumExp += expf(input[i] - globalMax);
    }
    smem[tid] = sumExp;
    __syncthreads();
    // ... tree reduce for sum ...

    float globalSum = smem[0];
    __syncthreads();

    // 3. Softmax
    for (int i = tid; i < N; i += blockDim.x) {
        output[i] = expf(input[i] - globalMax) / globalSum;
    }
}
Online Softmax (một lượt)
Online Normalizer Calculation của NVIDIA giữ max và sum trong một lượt, cắt một lần đọc global memory đầy đủ:
// Core idea: update max and sum online
float m = -FLT_MAX;  // current max
float d = 0.0f;       // current sum(exp(x - m))

for (int i = tid; i < N; i += blockDim.x) {
    float x = input[i];
    float m_new = fmaxf(m, x);
    // Key: rescale the old sum with a correction factor
    d = d * expf(m - m_new) + expf(x - m_new);
    m = m_new;
}
// Final: softmax(x_i) = exp(x_i - m) / d
Mẹo này là một trong những nền tảng toán của FlashAttention.
6.4 Kernel Fusion
Kernel fusion gộp vài op nhỏ thành một kernel để kết quả trung gian không bao giờ quay lại global memory. Như rửa rau một lần thay vì xả trước mỗi món — mỗi lần ghi+đọc HBM là thêm một chuyến tới bồn dành cho “di chuyển,” không phải nấu.
Unfused:
kernel1: A = input + bias     → write HBM
kernel2: B = ReLU(A)          → read A from HBM, write B to HBM
kernel3: output = LayerNorm(B) → read B from HBM

Fused:
fused_kernel: output = LayerNorm(ReLU(input + bias))
  → read input once; intermediates stay in registers / shared memory
Với op elementwise memory-bound (ReLU, Add, LayerNorm), fusion có thể cho tăng tốc vài lần vì nút thắt là traffic HBM, không phải số học.
7. Toán tử Attention
Attention là op lõi của Transformer và nguồn lớn của cả compute lẫn bộ nhớ trong mô hình lớn. Hiểu tối ưu kernel Attention là tài liệu AI Infra bắt buộc.
7.1 Vấn đề của Attention chuẩn
Attention chuẩn:
Pipeline phải lưu toàn bộ ma trận QK^T (seq_len × seq_len). Với chuỗi dài ma trận đó rất lớn. Với seq_len = 8192 và batch = 32:
QK^T size = 32 * 128 * 8192 * 8192 * 2 bytes (FP16) ≈ 128 GB
Đã vượt một card 80GB. Dù VRAM đủ, đưa ma trận đó qua lại giữa HBM và SRAM vẫn giết tốc độ.
7.2 FlashAttention
Ý tưởng lõi của FlashAttention: dùng Tiling để QK^T đầy đủ không bao giờ sống trong HBM, và giữ trung gian trong Shared Memory.
Standard Attention:
  Q, K → QK^T (write HBM) → softmax (read/write HBM) → × V → output
  ↑ O(N^2) intermediates in HBM; heavy traffic

FlashAttention:
  Tile Q → each tile attends over all K, V tiles → stitch with Online Softmax
  ↑ intermediates stay in SRAM; never written back to HBM
Kỹ thuật then chốt:
- Tiling: cắt Q, K, V thành tile vừa Shared Memory
- Online Softmax: giữ max và sum toàn cục đúng qua các tile
- Recomputation: ở backward, không lưu ma trận Attention trung gian; tính lại (đổi compute lấy bộ nhớ)
Độ phức tạp IO:
| Phương pháp | Traffic HBM | Bộ nhớ thêm |
|---|---|---|
| Attention chuẩn | O(N^2 * d) | O(N^2) |
| FlashAttention | O(N^2 * d^2 / SRAM_SIZE) | O(N) |
Với setup điển hình d=128, SRAM=192KB, FlashAttention cắt traffic HBM khoảng ~8×.
7.3 FlashAttention V2
V2 tinh chỉnh thêm chiến lược song song trên nền V1:
- Forward: song song theo chiều sequence (không chỉ batch/head), giúp chuỗi dài
- Backward: giảm tỷ lệ công việc không-matmul để Tensor Core bận hơn
- Kích thước Block: Block size khác nhau cho Q vs K/V để khớp phần cứng tốt hơn
Đo được V2 nhanh hơn V1 khoảng ~2×, đạt 50-73% peak A100.
7.4 FlashAttention-3
Tinh chỉnh thêm cho Hopper (H100):
- TMA (Tensor Memory Accelerator): copy bất đồng bộ tăng tốc phần cứng các Tensor lớn từ global sang shared memory, để Warp bớt nạp thủ công
- WGMMA: nhân-cộng ma trận cấp Warpgroup (4 Warp) để 128 thread nuôi Tensor Core trên tile GEMM lớn
- Ping-Pong pipeline: chồng producer-consumer giữa di chuyển dữ liệu và compute
Nếu các tên này còn trừu tượng, tạm bỏ chi tiết lệnh. TL;DR: sau Hopper, kernel hiệu năng cao chạy “chuyển Tile” và “tính Tile” như hai pipeline song song. TMA chuyển, WGMMA tính, và Ping-Pong / double buffering xen kẽ chúng. Đó là latency hiding tiếp tục vào kỷ Tensor Core.
7.5 Flash-Decoding
FlashAttention chủ yếu tối ưu Prefill (Q lớn). Ở Decode, Q là một token và nút thắt đổi.
Ý tưởng Flash-Decoding: cắt KV Cache theo chiều sequence, để nhiều Block tính Attention song song, rồi reduce các kết quả từng phần.
Standard Decode Attention:
  1 Block walks the whole KV Cache → not enough parallelism

Flash-Decoding:
  Block 0: Q × K[0:L/4]^T → partial_output_0
  Block 1: Q × K[L/4:L/2]^T → partial_output_1
  Block 2: Q × K[L/2:3L/4]^T → partial_output_2
  Block 3: Q × K[3L/4:L]^T → partial_output_3
  → reduce / merge partial outputs
7.6 FlashInfer
FlashInfer là engine Attention tùy biến được, hướng Serving:
- PagedAttention (KV Cache phân trang kiểu vLLM)
- Layout KV composable (contiguous, paged, blocked)
- Quant hóa KV Cache (FP8, INT4)
- API Prefill và Decode thống nhất
7.7 PagedAttention
PagedAttention của vLLM đưa phân trang bộ nhớ ảo kiểu OS vào quản lý KV Cache:
- KV Cache không còn cần bộ nhớ liền kề; được cắt thành “page” kích thước cố định
- Page được cấp phát và giải phóng theo nhu cầu, loại bỏ fragmentation
- Các request khác nhau có thể chia sẻ cùng page KV Cache (ví dụ system prompt dùng chung)
8. Trình biên dịch AI
Kernel CUDA viết tay khó viết và khó debug hơn. Trình biên dịch AI đang hạ thanh chắn cho lập trình GPU hiệu quả.
8.1 Triton
Triton là ngôn ngữ GPU mã nguồn mở của OpenAI. Bạn viết kernel bằng cú pháp Python; trình biên dịch xử lý coalescing, quản lý shared memory, lập lịch Warp và các chi tiết mức thấp khác.
Triton vs CUDA: lấy cộng vector làm ví dụ
import triton
import triton.language as tl
import torch

@triton.jit
def add_kernel(
    x_ptr, y_ptr, output_ptr,
    n_elements,
    BLOCK_SIZE: tl.constexpr,
):
    # Element range for this Block
    pid = tl.program_id(0)
    offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
    mask = offsets < n_elements

    # Load, compute, store
    x = tl.load(x_ptr + offsets, mask=mask)
    y = tl.load(y_ptr + offsets, mask=mask)
    output = x + y
    tl.store(output_ptr + offsets, output, mask=mask)

# Call site
def add(x: torch.Tensor, y: torch.Tensor):
    output = torch.empty_like(x)
    n = x.numel()
    grid = lambda meta: (triton.cdiv(n, meta['BLOCK_SIZE']),)
    add_kernel[grid](x, y, output, n, BLOCK_SIZE=1024)
    return output

# Usage
x = torch.randn(1000000, device='cuda')
y = torch.randn(1000000, device='cuda')
result = add(x, y)
Softmax trong Triton
@triton.jit
def softmax_kernel(
    input_ptr, output_ptr,
    n_cols,
    input_row_stride, output_row_stride,
    BLOCK_SIZE: tl.constexpr,
):
    row_idx = tl.program_id(0)
    row_start = row_idx * input_row_stride
    col_offsets = tl.arange(0, BLOCK_SIZE)
    mask = col_offsets < n_cols

    # Load one row
    row = tl.load(input_ptr + row_start + col_offsets, mask=mask, other=-float('inf'))

    # Numerically stable softmax
    row_max = tl.max(row, axis=0)
    numerator = tl.exp(row - row_max)
    denominator = tl.sum(numerator, axis=0)
    result = numerator / denominator

    # Store
    tl.store(output_ptr + row_idx * output_row_stride + col_offsets, result, mask=mask)
Ưu điểm Triton:
- Cú pháp Python; đường cong học dịu hơn
- Trình biên dịch xử lý coalescing, Tiling shared memory, lập lịch Warp
- Hiệu năng có thể đạt 80-95% CUDA viết tay
- Bản FlashAttention gốc dùng Triton
8.2 torch.compile
PyTorch 2.x thêm torch.compile, có thể biên dịch code PyTorch thành code GPU hiệu quả tự động:
import torch

@torch.compile
def fused_gelu(x):
    return x * 0.5 * (1.0 + torch.tanh(0.7978845608 * (x + 0.044715 * x ** 3)))

# First call triggers compile; later calls reuse the compiled result
output = fused_gelu(input_tensor)
Chuỗi backend torch.compile:
PyTorch code → TorchDynamo (graph capture) → TorchInductor (codegen) → Triton kernel
Graph Break: khi torch.compile gặp thứ nó không biên dịch được (side effect Python, control flow động), nó “cắt” graph và làm yếu tối ưu. Để kiểm tra:
TORCH_LOGS="graph_breaks" python your_script.py
8.3 TVM / XLA
| Trình biên dịch | Đặc điểm lõi | Phù hợp với |
|---|---|---|
| TVM (Apache) | Trình biên dịch tensor portable; tự tìm config | Tinh chỉnh inference đa phần cứng |
| XLA (Google) | JIT cho JAX/TensorFlow | Hệ sinh thái JAX; TPU |
| Triton (OpenAI) | Lập trình GPU kiểu Python | Phát triển toán tử tùy chỉnh |
| TorchInductor | Trình biên dịch gốc của PyTorch | Tối ưu cả graph trong PyTorch |
9. Công cụ profiling
Làm kernel chạy được chỉ là bước một. Biết nút thắt nằm đâu mới khiến tối ưu có ích.
9.1 Nsight Compute (cấp kernel)
# Detailed analysis of a chosen kernel
ncu --set full -o profile ./your_app

# Specific metrics
ncu --metrics \
    sm__throughput.avg.pct_of_peak_sustained_active,\
    dram__throughput.avg.pct_of_peak_sustained_active \
    ./your_app
Metric lõi:
| Metric | Ý nghĩa | Mục tiêu |
|---|---|---|
| Compute (SM) Throughput | Mức dùng đơn vị compute | >70% khi compute-bound |
| Memory Throughput | Mức dùng băng thông HBM | >70% khi memory-bound |
| Achieved Occupancy | Tỷ lệ Warp active | >25% (cao hơn không luôn tốt hơn) |
| Warp Execution Efficiency | Branch divergence | >85% |
| L2 Hit Rate | Tỷ lệ hit cache L2 | >70% |
| Shared Memory Bank Conflicts | Số bank conflict | 0 |
Ngoài các phần trăm mức cao đó, Nsight Compute còn hiện thống kê phần cứng như Dispatched Warps, Warp Stall và Pipe Utilization. Đằng sau chúng là vài trạng thái glossary:
- Warp Execution State / Stall: một Warp không phát được lệnh tiếp vì latency bộ nhớ, phụ thuộc dữ liệu, chờ sync, v.v., nên bị stall.
- Issue Efficiency: bao nhiêu chu kỳ thực sự phát lệnh cho một Warp; phần còn lại scheduler “nhìn quanh và không thấy Warp sẵn sàng.”
- Pipe Utilization: các pipeline số học, Tensor Core và đơn vị load/store được dùng đầy đến mức nào. CUDA Core cao mà Tensor Core ngồi không thường nghĩa là kernel chưa nuôi matmul vào đúng phần cứng.
Những thứ này nằm cùng bức tranh với Occupancy và latency hiding: Occupancy là bạn có bao nhiêu Warp; stall là chúng có sẵn sàng không. Nếu nhiều Warp chờ dữ liệu, Issue Efficiency giảm.
9.2 Nsight Systems (cấp hệ thống)
nsys profile -o timeline ./your_app
Dùng cho timeline toàn cục:
- Khoảng trống CPU giữa các kernel (launch overhead)
- Copy có chồng với compute không
- Nhiều Stream có thực sự chạy đồng thời không
- Nút thắt ở Host hay Device
9.3 Output trình biên dịch
# Register and shared-memory usage
nvcc -Xptxas -v kernel.cu

# PTX IR
nvcc --ptx kernel.cu

# SASS (final machine code)
cuobjdump -sass kernel
9.4 Đọc lớp dưới: PTX / SASS / Compute Capability
Mục 1.3 đã phác chuỗi biên dịch. Đây là các thuật ngữ lại để source, disassembly và output profiler sau này bớt khó đọc.
- PTX (Parallel Thread Execution): IR ISA ảo sau khi biên dịch CUDA C++. Không phải machine code cho một GPU cụ thể; nó mô tả máy ảo “parallel thread.” GPU mới có thể JIT qua driver thành SASS cho phần cứng đó.
- SASS (Streaming ASSembler): assembly mà GPU NVIDIA thực thi thật, gắn với kiến trúc SM (ví dụ
sm_90cho Hopper). Tinh chỉnh hàng ngày nhìn nó để xác nhận trình biên dịch sinh pattern register / bộ nhớ như bạn kỳ vọng. - Compute Capability: phiên bản khả năng của GPU (ví dụ
7.0,9.0,10.0), quyết định tính năng PTX và lệnh phần cứng nào nó hỗ trợ. Viết-arch=sm_90nghĩa là “sinh code cho target compute-capability đó.”
Ví dụ cụ thể: SASS kiểu HMMA.1688.F32 là nhân-cộng ma trận Tensor Core. Cả một Warp thực thi một lệnh và hoàn thành nhiều nhân-cộng cùng lúc. Thấy nó xuất hiện xác nhận kernel của bạn thực sự nuôi Tensor Core.
10. Chủ đề nâng cao: ghép các ý lại
Đến đây bạn đã có chuỗi “phần cứng → thread → bộ nhớ → mô hình hiệu năng.” Từ góc thực hành, xem lại các hướng thường biến ý tưởng GPU Glossary thành tốc độ:
- Muốn biết kernel có nhanh không, trước hết hỏi memory-bound hay compute-bound: xem SM Throughput và Memory Throughput trong Nsight Compute, rồi quyết định tinh chỉnh pattern truy cập (coalescing, Tiling, shared memory) hay mật độ compute (Tensor Core, register tiling, unrolling).
- Tối ưu không phải một metric: kích thước Block ảnh hưởng Occupancy; Occupancy ảnh hưởng latency hiding; shared memory ảnh hưởng bao nhiêu Block vừa mỗi SM; mức dùng register phản hồi vào số thread. Đó là một đồ thị tài nguyên rối, không phải các núm độc lập.
- Hai đường chính cho kernel hiệu năng cao hiện đại: (1) Tile lớn + shared memory để cắt traffic global memory (Arithmetic Intensity), và (2) nuôi matmul vào Tensor Core trong khi giữ đủ Warp sẵn sàng chuyển khi dữ liệu muộn (latency hiding).
- Đi tiếp đâu: GEMM có register tiling, Double Buffering, Tensor Core; Attention có tiling FlashAttention, Online Softmax, TMA/WGMMA. Trong các case study nâng cao đó bạn sẽ gặp lại cùng các mảnh từ hướng dẫn này — hệ phân cấp thread, hệ phân cấp bộ nhớ, Warp, Bank Conflict, latency hiding và arithmetic intensity.
11. Danh sách tự kiểm
Sau hướng dẫn này bạn nên:
- Giải thích hệ phân cấp Grid → Block → Thread và chọn kích thước Block cho một kích thước dữ liệu cho trước
- Phân biệt năm loại bộ nhớ GPU (Registers, Local, Shared, Global, Constant) và nêu phạm vi cũng như vòng đời của từng loại
- Giải thích Warp, Coalesced Access và Bank Conflict
- Giải thích SM, CUDA Core, Tensor Core, Warp Scheduler và register file mỗi thứ làm gì
- Giải thích latency hiding bằng lời của bạn và liên hệ với Occupancy
- Quyết định một kernel là memory-bound hay compute-bound, và arithmetic intensity / Roofline nghĩa là gì
- Phân biệt PTX, SASS và Compute Capability, và giải thích
-arch= - Viết một kernel CUDA cơ bản (ví dụ cộng vector) và build/chạy bằng nvcc
- Tự viết một kernel Reduce đúng và áp dụng ít nhất hai tối ưu (Warp Shuffle + tích lũy nhiều phần tử)
- Triển khai Tiled GEMM và giải thích vì sao Tiling cắt traffic global memory
- Viết luồng thuật toán Online Softmax và vì sao nó hơn Naive Softmax
- Giải thích ý tưởng lõi của FlashAttention (Tiling + Online Softmax + không lưu ma trận trung gian)
- Viết một kernel Triton đơn giản (cộng vector hoặc Softmax) và so với PyTorch
- Profile kernel của bạn bằng Nsight Compute và quyết định memory-bound vs compute-bound
Tài liệu tham khảo
- NVIDIA CUDA C++ Programming Guide
- NVIDIA CUDA C++ Best Practices Guide
- GPU Glossary bản tiếng Trung (gpu-glossary-zh)
- Nsight Compute Documentation
- Nsight Systems User Guide
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
- FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision
- Flash-Decoding for long-context inference - Stanford CRFM
- FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving
- FlashInfer - GitHub
- vLLM: Efficient Memory Management for Large Language Model Serving with PagedAttention
- Online normalizer calculation for softmax
- Triton: An Intermediate Language and Compiler for Tiled Neural Network Computations
- Triton Tutorials
- CUTLASS - GitHub
- Meng Yuan: series minh họa FlashAttention V1/V2
- Fang Jiarui: hiểu triển khai CUDA của PagedAttention
- Meng Yuan: từ zero tới tối ưu CUDA GEMM