3.2 Toàn cảnh Transformer và hiện thực code
Từ Encoder-Decoder gốc đến Decoder-only, kèm hiện thực Transformer đầy đủ bằng PyTorch từ zero
Trước khi tháo từng linh kiện Transformer, hãy đứng xa nhìn cả “cỗ máy”. Bài này bắt đầu từ kiến trúc Encoder-Decoder của paper 2017, phân tích cấu trúc nội bộ và luồng dữ liệu của Encoder/Decoder, rồi lần theo ba nhánh tiến hóa (Encoder-only, Encoder-Decoder, Decoder-only), tập trung vào lựa chọn mainstream của LLM hiện nay — Decoder-only — và cuối cùng hiện thực Encoder-Decoder Transformer đầy đủ bằng PyTorch để lý thuyết khớp với code.
📑 Mục lục
- 1. Vì sao cần nhìn toàn cảnh trước
- 2. Transformer gốc: Encoder-Decoder
- 3. Cấu trúc nội bộ Encoder
- 4. Cấu trúc nội bộ Decoder
- 5. Tiến hóa kiến trúc: ba ngã rẽ
- 6. Decoder-only: cấu trúc end-to-end của LLM hiện nay
- 7. Đọc cấu trúc mô hình thật từ config
- 8. So sánh đặc tính kỹ thuật của ba kiến trúc
- 9. Hiện thực PyTorch: dựng Transformer từ zero
- Tóm tắt
- Checklist tự kiểm
- Tài liệu tham khảo
1. Vì sao cần nhìn toàn cảnh trước
Sai lầm phổ biến nhất khi học Transformer là lao thẳng vào chi tiết matmul của Self-Attention rồi “chỉ thấy cây không thấy rừng” — biết tính thế nào, nhưng không nói được mô hình trải qua những bước nào từ nhận một câu đến nhả chữ tiếp theo.
Phép so sánh: lần đầu bước vào một nhà máy lạ, cách hiệu quả không phải mở ngay hộp số của một máy trên dây chuyền, mà đi một vòng xưởng — nguyên liệu vào cửa nào, qua bao nhiêu công đoạn, thành phẩm ra đâu. Có “bản đồ nhà máy” đó, sau này tháo bất kỳ máy nào bạn cũng biết vị trí và nhiệm vụ của nó trên cả dây chuyền.
Bài này chính là bản đồ đó. Đọc xong bạn sẽ rõ:
- Encoder và Decoder trong Transformer gốc mỗi bên làm gì, phối hợp ra sao
- Ba biến thể (Encoder-only, Encoder-Decoder, Decoder-only) mỗi cái cắt gì, giữ gì
- Đường dữ liệu đầy đủ của LLM hiện nay từ token vào đến xác suất ra
- Vai trò từng component trong luồng end-to-end, làm hệ tọa độ cho các bài sâu sau
2. Transformer gốc: Encoder-Decoder
Năm 2017 Vaswani và cộng sự công bố “Attention Is All You Need”: mô hình chuyển chuỗi hoàn toàn dựa trên attention, bỏ hẳn RNN/LSTM đang thống trị. Đó là khởi điểm của Transformer.
2.1 Động cơ thiết kế: sinh ra vì dịch máy
Transformer gốc giải bài sequence-to-sequence (Seq2Seq) — cho một chuỗi vào (ví dụ câu tiếng Anh), sinh chuỗi ra (ví dụ bản dịch tiếng Pháp). Tự nhiên cần hai giai đoạn: trước hiểu input, rồi sinh output. Mô hình tách thành hai nửa đối xứng:
- Encoder (bộ mã hóa): nén chuỗi vào thành một tập “biểu diễn đã hiểu”
- Decoder (bộ giải mã): dựa trên tập đó, sinh dần chuỗi ra
Giống cách người dịch: đọc hết câu tiếng Anh, tạo hiểu biết trong đầu (encode), rồi viết từng từ tiếng Pháp (decode), mỗi từ đều quay lại tham chiếu hiểu biết về nguyên văn.
2.2 Sơ đồ kiến trúc tổng thể
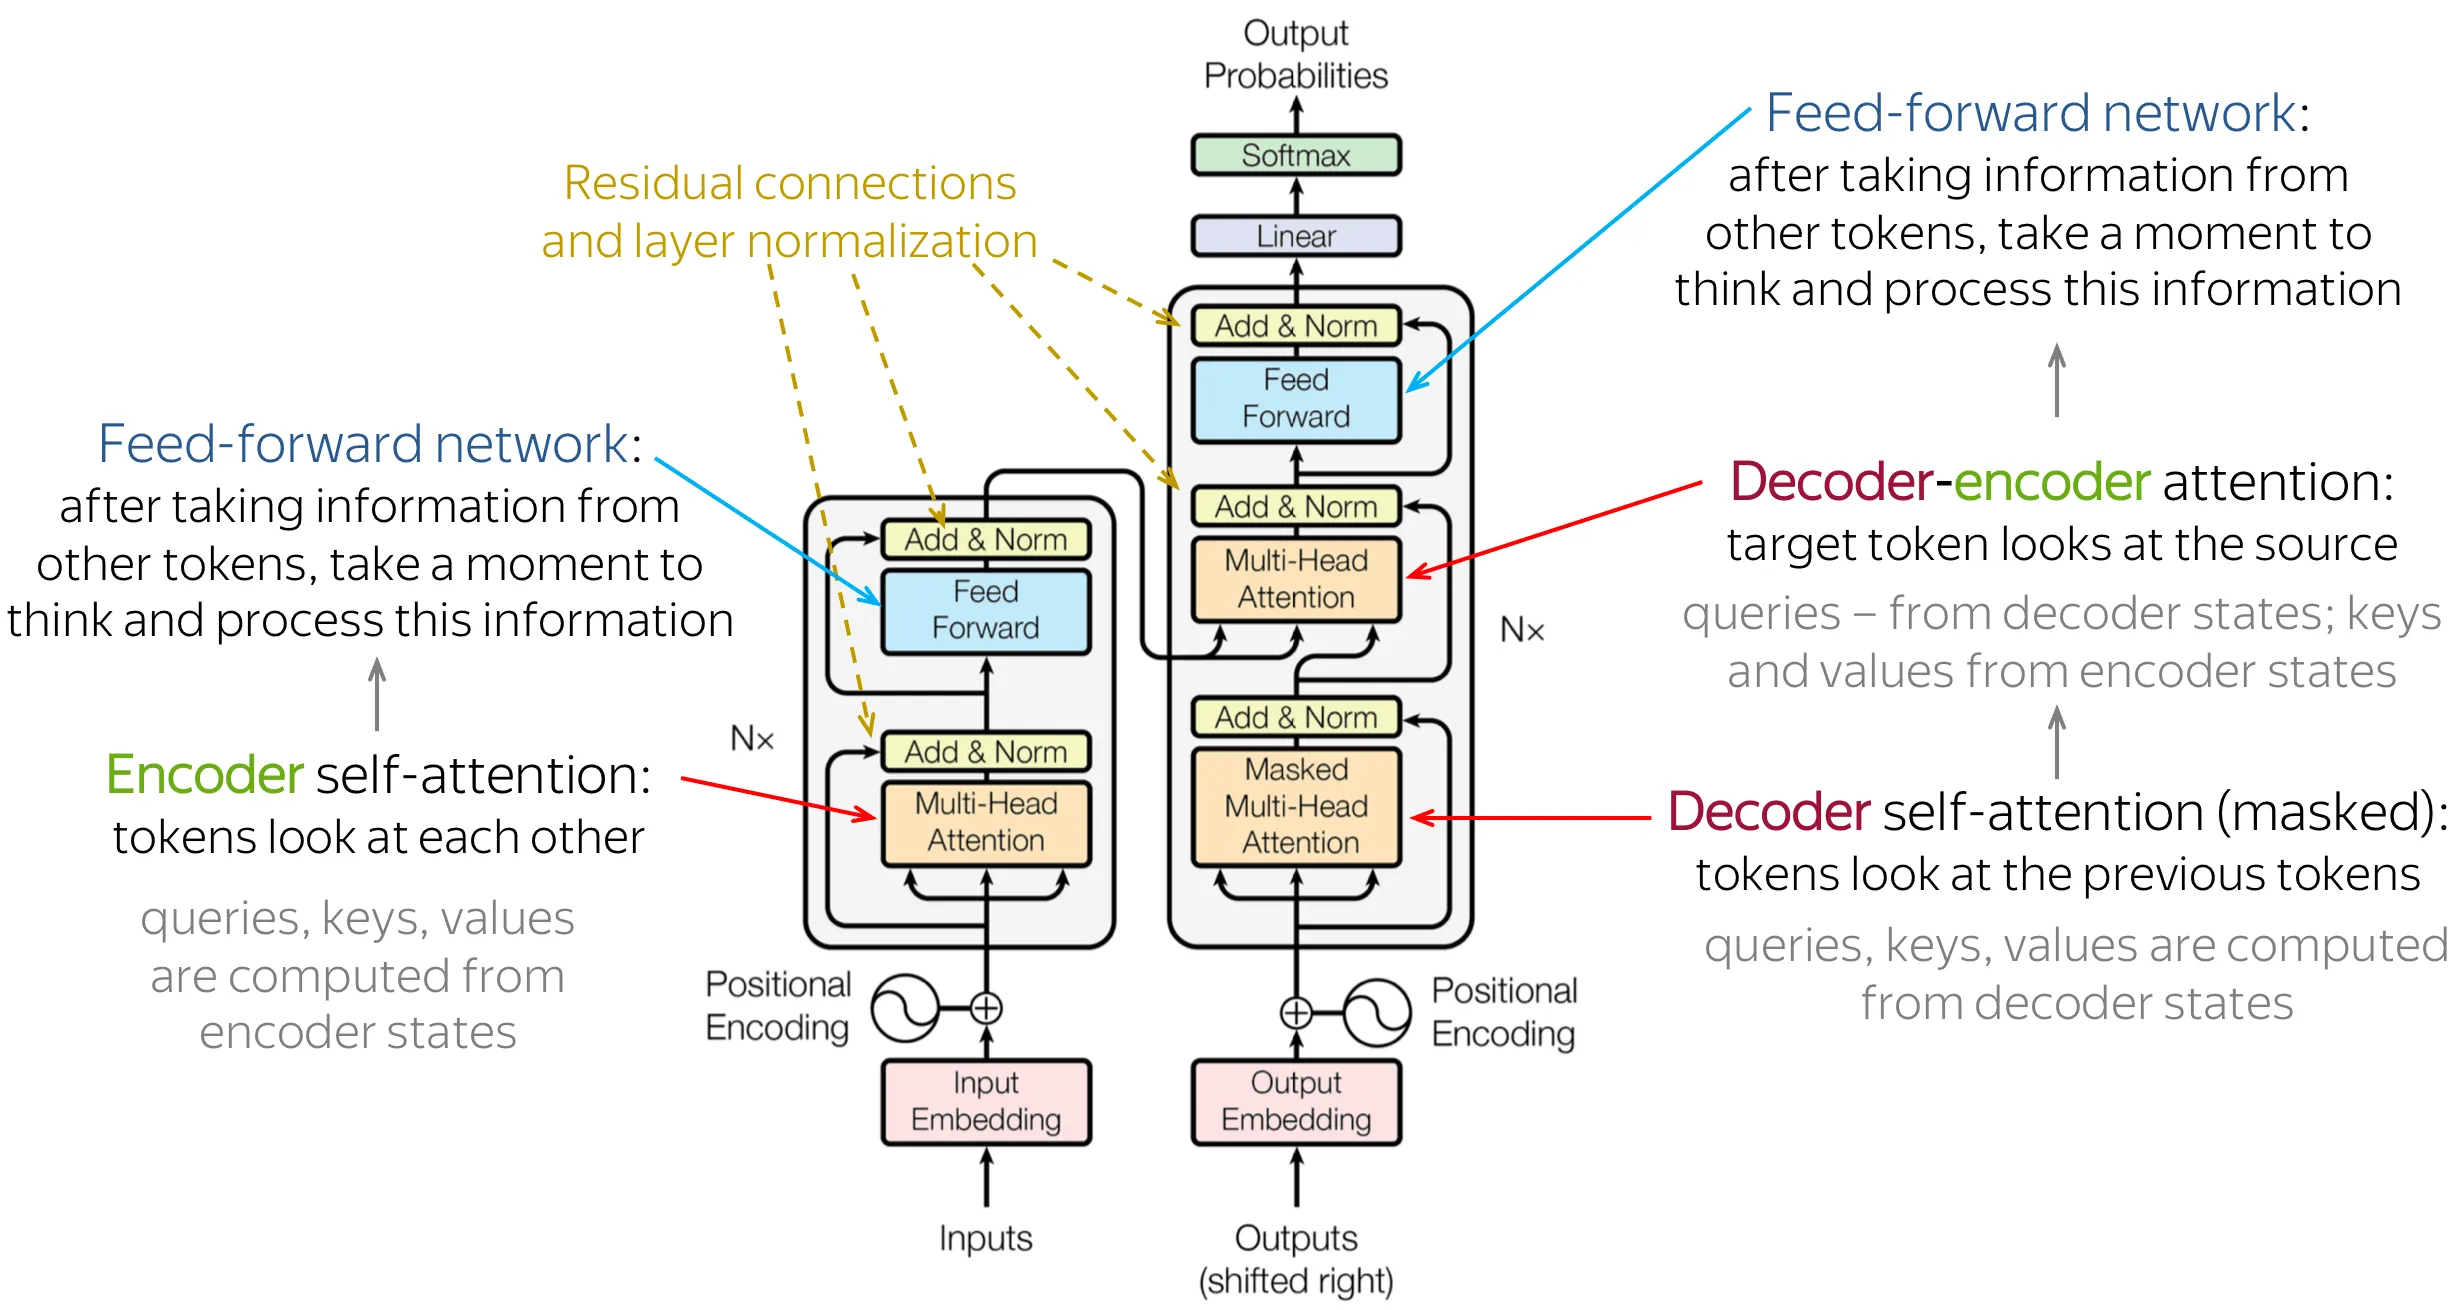
Trong paper gốc, Encoder và Decoder mỗi bên layer, hidden dim , số head , FFN mid dim .
2.3 Phân công của ba cơ chế attention
Transformer gốc dùng ba attention khác nhau. Tính toán nền giống nhau (Scaled Dot-Product Attention), nhưng nguồn Q, K, V khác nhau và vai trò khác nhau:
| Loại attention | Vị trí | Q từ | K, V từ | Vai trò |
|---|---|---|---|---|
| Encoder Self-Attention | Layer Encoder | Chuỗi vào | Chuỗi vào | Token input trao đổi thông tin với nhau |
| Masked Decoder Self-Attention | Layer Decoder | Chuỗi đã sinh | Chuỗi đã sinh | Token đã sinh trao đổi thông tin (không nhìn tương lai) |
| Cross-Attention | Layer Decoder | Chuỗi đã sinh | Output Encoder | Trong lúc sinh “nhìn lại” chuỗi vào |
Theo phép so sánh dịch:
- Encoder Self-Attention như đọc nguyên văn và cân nhắc quan hệ từng từ với các từ khác
- Masked Decoder Self-Attention như xem lại những gì mình đã viết
- Cross-Attention như viết bản dịch mà vẫn đối chiếu nguyên văn
3. Cấu trúc nội bộ Encoder
Nhiệm vụ Encoder là “đọc hiểu” chuỗi vào. Nó nhận chuỗi token và ra chuỗi biểu diễn ngữ cảnh cùng độ dài — vector output mỗi vị trí đã trộn thông tin cả chuỗi vào.
3.1 Xử lý đầu vào
Trước khi vào layer Encoder, input gốc qua hai bước:
Token Embedding: map mỗi token ID thành vector dày chiều qua ma trận embedding học được , với là kích thước vocab.
Positional Encoding: bản thân Attention không có thông tin vị trí (xáo thứ tự token thì kết quả không đổi), nên phải bơm tín hiệu vị trí tường minh. Paper gốc dùng sine/cosine, cộng thẳng vào token embedding:
Input sau xử lý có shape , với là độ dài chuỗi nguồn.
3.2 Luồng dữ liệu trong một Encoder layer
Mỗi Encoder layer gồm hai submodule; mỗi cái bọc residual connection và LayerNorm:
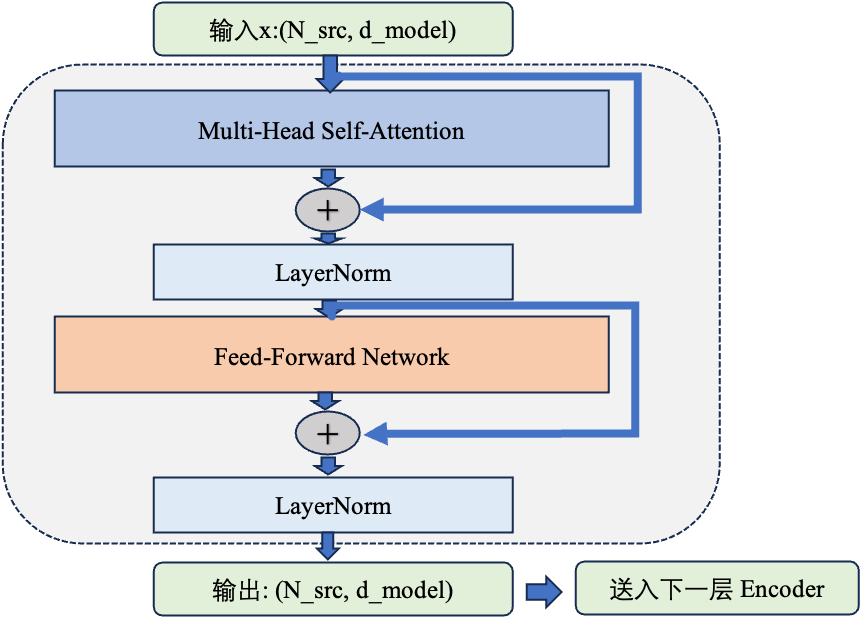
Lưu ý paper gốc dùng Post-Norm (tính sublayer trước, LayerNorm sau): . LLM hiện nay hầu hết chuyển sang Pre-Norm (LayerNorm trước, sublayer sau). Hiểu thiết kế gốc giúp nắm mạch tiến hóa.
3.3 Đặc tính then chốt của Encoder Self-Attention
Self-Attention trong Encoder là hai chiều (bidirectional) — mỗi token có thể attend mọi token khác, cả trước lẫn sau.
Biểu diễn bằng ma trận attention (1 = được attend, shape ):
     t0  t1  t2  t3  t4
t0 [  1   1   1   1   1 ]
t1 [  1   1   1   1   1 ]
t2 [  1   1   1   1   1 ]
t3 [  1   1   1   1   1 ]
t4 [  1   1   1   1   1 ]
Fully connected — không che gì. Ngay từ Encoder layer đầu, token cuối chuỗi vẫn ảnh hưởng trực tiếp biểu diễn token đầu. Sau N layer Encoder, vector output mỗi vị trí thực ra đã tổng hợp thông tin toàn cục của cả chuỗi vào.
3.4 Luồng thông tin qua nhiều layer chồng
Paper gốc chồng 6 Encoder layer. Thiết kế then chốt: mọi layer có cùng chiều I/O (đều ). Các layer chồng như Lego — 6, 12 hay 100 layer, miễn VRAM đủ.
Trực giác về chồng nhiều layer: mỗi layer làm một vòng “trộn và gia công thông tin”. Layer nông có thể học quan hệ từ vựng/cú pháp (cụm nào đi với nhau, từ nào bổ nghĩa từ nào); layer sâu học quan hệ ngữ nghĩa trừu tượng hơn (đồng tham chiếu, suy luận ẩn). Càng nhiều layer, khả năng bắt quan hệ phức tạp càng mạnh, nhưng chi phí tính tăng tuyến tính.
4. Cấu trúc nội bộ Decoder
Nhiệm vụ Decoder là “sinh” chuỗi ra. Nó có thêm một tầng attention so với Encoder — Cross-Attention — để “tra cứu” output của Encoder.
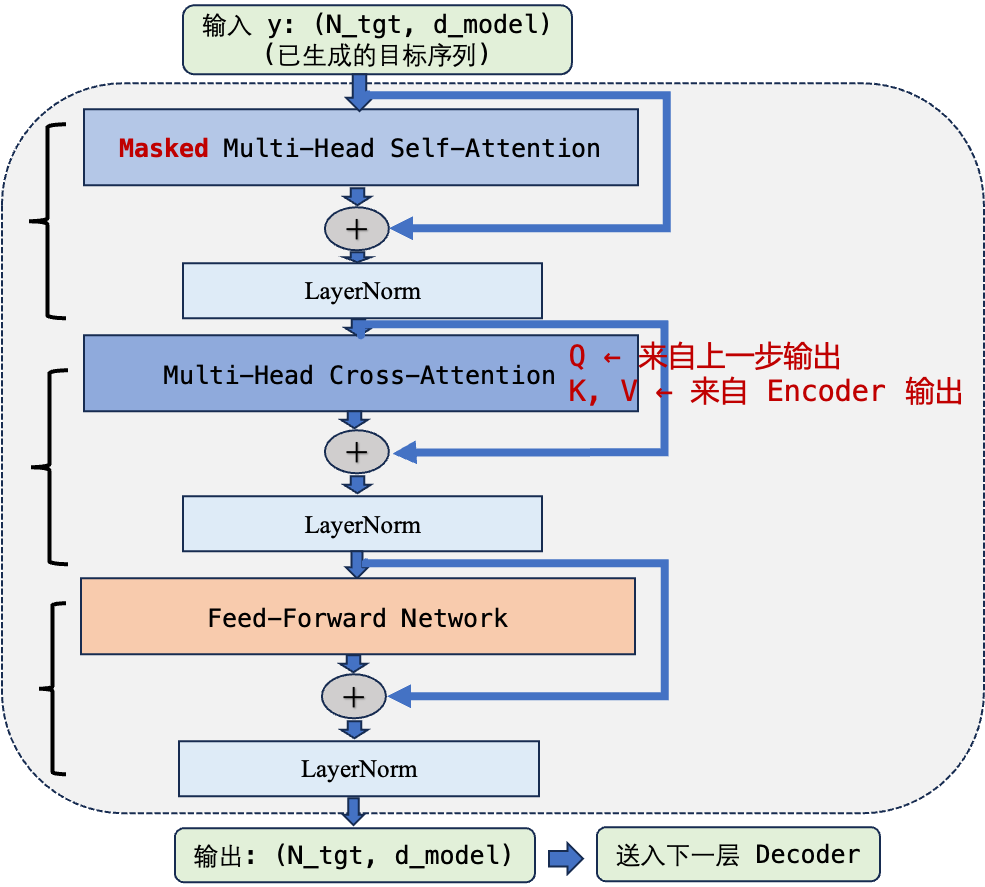
4.1 Luồng dữ liệu trong một Decoder layer
Mỗi Decoder layer gồm ba submodule (thêm Cross-Attention so với Encoder):
4.2 Masked Self-Attention: không được nhìn trước tương lai
Self-Attention của Decoder có Causal Mask, bảo đảm khi sinh token thứ chỉ thấy vị trí đến , không thấy sau .
     t0  t1  t2  t3  t4
t0 [  1   0   0   0   0 ]    chỉ thấy chính mình
t1 [  1   1   0   0   0 ]    thấy t0 và chính mình
t2 [  1   1   1   0   0 ]    thấy t0, t1 và chính mình
t3 [  1   1   1   1   0 ]    thấy tất cả phía trước
t4 [  1   1   1   1   1 ]    thấy toàn bộ
Đó là ma trận tam giác dưới. Hiện thực: cộng mask tam giác trên bằng lên score matrix; sau softmax các vị trí đó về 0.
Vì sao cần mask? Lúc train, để nhanh, cả chuỗi target được đưa vào Decoder tính song song (Teacher Forcing). Không mask thì khi đoán từ thứ 3 mô hình đã thấy từ 4, 5 — như thi mở sách, không học được khả năng dự đoán.
4.3 Cross-Attention: cầu nối Encoder và Decoder
Cross-Attention là cơ chế kết nối then chốt trong Encoder-Decoder. Cách tính giống hệt Self-Attention; khác duy nhất là nguồn Q, K, V:
- Q (Query) từ output layer Decoder hiện tại — “tôi muốn thông tin gì”
- K (Key) và V (Value) từ output Encoder layer cuối — “chuỗi nguồn có gì để tra”
Phân tích shape: nếu độ dài nguồn , độ dài đích :
- Ma trận attention score: — không vuông!
Ở đây không cần causal mask: mọi token Decoder nên attend mọi vị trí Encoder — khi dịch bạn cần thấy cả nguyên văn.
4.4 Vì sao Decoder layer có ba submodule
Xếp ba submodule nối tiếp, phân công rất rõ:
| Submodule | Input | Vai trò | Phép so sánh |
|---|---|---|---|
| Masked Self-Attention | Bản thân chuỗi đích | Các từ đã sinh phối hợp — ngữ pháp và nhất quán | Viết văn rồi đọc lại đoạn đã viết |
| Cross-Attention | Chuỗi đích + chuỗi nguồn | Tham chiếu nguồn khi sinh — trung thành với nguyên văn | Viết bản dịch mà đối chiếu nguyên văn |
| FFN | Token hiện tại | Gia công phi tuyến sâu trên tín hiệu đã gộp | Tiêu hóa rồi diễn đạt bằng lời mình |
Thứ tự luồng thông tin có chủ đích: Self-Attention trước để gộp “ngữ cảnh mình đã có”, Cross-Attention rồi mới bổ sung “thông tin từ input”, cuối cùng FFN “gia công sâu”. Thứ tự này bảo đảm mỗi token khi đoán đã xét cả ngữ cảnh đích trước đó và nguồn.
5. Tiến hóa kiến trúc: ba ngã rẽ
Sau khi Transformer gốc ra đời, cộng đồng nhanh chóng thấy Encoder và Decoder không nhất thiết phải đi đôi. Tùy task có thể chỉ giữ một phần. Ba lộ trình kỹ thuật hình thành.
5.1 Encoder-only: nhánh BERT
Năm 2018 Google phát hành BERT (Bidirectional Encoder Representations from Transformers): chỉ giữ phần Encoder của Transformer, cắt Decoder và Cross-Attention.
Ý tưởng lõi: không làm generation, tập trung “hiểu”. BERT pretrain bằng Masked Language Model (che ngẫu nhiên một số token, bắt mô hình đoán) để có khả năng hiểu ngôn ngữ hai chiều.
Input: "The [MASK] sits on the mat"
      │
      ▼
  Encoder x 12 layers (bidirectional attention)
      │
      ▼
  Mỗi vị trí ra một vector biểu diễn phụ thuộc ngữ cảnh
      │
      ▼
  Vị trí [MASK] → đoán "cat" (pretrain)
  Vị trí [CLS] → nhãn phân loại (fine-tune)
Giữ gì: Self-Attention hai chiều + FFN + residual + LayerNorm Cắt gì: causal mask, Cross-Attention, sinh tự hồi quy
Phù hợp: phân loại văn bản, NER, độ tương đồng câu, trích xuất thông tin — mọi task cần “hiểu” nhưng không cần “sinh”.
5.2 Encoder-Decoder: nhánh T5
Năm 2019 Google phát hành T5 (Text-to-Text Transfer Transformer), giữ nguyên Encoder-Decoder đầy đủ nhưng thống nhất paradigm: mọi task NLP đều thành định dạng text-to-text.
Classification: "classify: The movie is great" → "positive"
Translation:    "translate English to German: Hello" → "Hallo"
Summarization:  "summarize: [long text]" → "[summary]"
T5 cho thấy: chỉ cần thống nhất format I/O, một Encoder-Decoder xử lý gần như mọi task NLP. BART, mBART, UL2 cũng đi theo nhánh này.
Giữ gì: Encoder + Decoder + Cross-Attention đầy đủ Cải gì: format train text-to-text thống nhất
5.3 Decoder-only: nhánh GPT
Năm 2018 OpenAI phát hành GPT (Generative Pre-trained Transformer): chỉ giữ phần Decoder (bỏ Cross-Attention), train thuần bằng “đoán token tiếp theo”.
Input: "The cat sits on"
       │
       ▼
  Decoder x N layers (causal attention)
       │
       ▼
  Output vị trí cuối → đoán "the"
Giữ gì: Causal Self-Attention + FFN + residual + LayerNorm Cắt gì: Encoder, Cross-Attention, attention hai chiều
Từ GPT-1 đến GPT-4, từ LLaMA đến Mistral, Qwen, DeepSeek, nhánh Decoder-only trở thành mainstream tuyệt đối của kỷ nguyên LLM. Mục tiếp theo mổ xẻ cấu trúc đầy đủ của nó.
6. Decoder-only: cấu trúc end-to-end của LLM hiện nay
Decoder-only cắt Encoder và Cross-Attention. Cả mô hình gói trong công thức cực ngắn: token vào → Embedding → N Decoder Block → đoán token tiếp theo.
6.1 Luồng dữ liệu end-to-end
Lấy một lần suy luận LLM thật, theo dõi dữ liệu từ vào đến ra:
User input: "什么是注意力机制"

Step 1: Tokenizer
────────────────────
"什么是注意力机制" → [1234, 567, 89, 2345, 678]  (5 token ID)

Step 2: Token Embedding
────────────────────
[1234, 567, 89, 2345, 678]
    │
    ▼
W_embed: (vocab_size, d_model)   tra bảng lấy vector mỗi token
    │
    ▼
X: (5, d_model)                  5 vector d_model chiều

Step 3: L Decoder Block
────────────────────
┌─ Block 1 ─────────────────────────────────────────────┐
│                                                       │
│  x_norm = RMSNorm(X)                                  │
│  attn_out = MaskedSelfAttention(x_norm)  ← có RoPE    │
│  H = X + attn_out                        ← residual   │
│                                                       │
│  h_norm = RMSNorm(H)                                  │
│  ffn_out = SwiGLU_FFN(h_norm)                         │
│  X = H + ffn_out                         ← residual   │
│                                                       │
└───────────────────────────────────────────────────────┘
    │                          shape luôn (5, d_model)
    ▼
┌─ Block 2 ─────────── ... ───────── Block L ────────────┐
│                                                        │
│  Cấu trúc giống hệt, lặp L lần                         │
│                                                        │
└────────────────────────────────────────────────────────┘
    │
    ▼
X_final: (5, d_model)

Step 4: Final LayerNorm
────────────────────
X_norm = RMSNorm(X_final)        (5, d_model)

Step 5: LM Head
────────────────────
logits = X_norm @ W_lm_head      (5, d_model) × (d_model, vocab_size)
                                 = (5, vocab_size)

Step 6: Lấy vị trí cuối, Softmax → sample
────────────────────
logits[-1]: (vocab_size,)         output tại vị trí token cuối
    │
    ▼
probabilities = Softmax(logits[-1])
    │
    ▼
next_token = Sample(probabilities)  → ví dụ sample được "注"

Step 7: Vòng tự hồi quy
────────────────────
Nối token mới vào cuối input, lặp Step 2–6
"什么是注意力机制" + "注" → "什么是注意力机制注"
Tiếp tục sinh... "意" → "力" → "机" → "制" → "是" → ...
Dạng toán gọn:
6.2 Năm component tháo ra
Tách mô hình Decoder-only thành năm module chức năng từ đầu đến cuối:
(1) Token Embedding
Như từ điển “từ–vector”. Mô hình giữ ma trận ; đưa token ID thì lấy hàng tương ứng.
- LLaMA-2-7B: , , nên có tham số
- So với tổng 6.7B, Embedding chỉ khoảng 2%
(2) Chồng Decoder Block
Đây là “thân” mô hình, chiếm 95%+ tham số và tính toán. Cấu trúc bên trong Block được giải ở bài nhập môn và các bài sâu sau; ở đây nhấn vài tính chất toàn cục:
- Bảo toàn chiều: I/O mỗi Block nghiêm ngặt cùng shape , nên Block chồng tùy ý
- Không chia sẻ tham số: mỗi layer độc lập, không share giữa các layer
- Độ sâu theo số layer: LLaMA-2-7B có 32 layer, LLaMA-2-70B có 80; càng nhiều layer mô hình càng “sâu”, về lý thuyết bắt được pattern phức tạp hơn
(3) Final LayerNorm
Sau Decoder Block cuối còn một lớp chuẩn hóa riêng. Nó ổn định dải số trước khi vào LM Head, tránh drift số trong mạng sâu làm rối phân phối output.
(4) LM Head
Một linear layer đơn giản , map hidden state chiều sang logits kích thước vocab .
Một tối ưu kỹ thuật quan trọng: Weight Tying (chia sẻ trọng số). Một số mô hình (ví dụ GPT-2) để LM Head tái dùng ma trận Token Embedding (sau khi transpose): . Ở quy mô LLaMA-2-7B, điều này tiết kiệm 131M tham số (bản thân LLaMA-2 không share; hai bên độc lập), và về ngữ nghĩa cũng hợp lý — “map vector về token” và “map token thành vector” nên là phép nghịch đảo.
(5) Softmax + sampling
Đổi logits thành phân phối xác suất, rồi chọn token tiếp theo theo chiến lược (Greedy, Top-k, Top-p, Temperature, …). Chiến lược ảnh hưởng mạnh chất lượng và độ đa dạng — Temperature cao thì ngẫu nhiên hơn, thấp thì xác định hơn.
6.3 So sánh cấu trúc với Encoder-Decoder gốc
Đặt hai kiến trúc cạnh nhau để thấy Decoder-only đã đơn giản hóa gì:
| Component | Encoder-Decoder | Decoder-only |
|---|---|---|
| Token Embedding | Encoder và Decoder mỗi bên một | Chỉ một |
| Positional Encoding | Cộng vào (Sinusoidal) | Xoay (RoPE, áp lúc Attention) |
| Self-Attention | Encoder: hai chiều / Decoder: nhân quả | Chỉ Self-Attention có causal mask |
| Cross-Attention | Có (mọi layer Decoder) | Không |
| FFN | Cả Encoder và Decoder | Mỗi layer một |
| Vị trí LayerNorm | Post-Norm | Pre-Norm (phần lớn LLM) |
| Cách chuẩn hóa | LayerNorm | RMSNorm (phần lớn LLM) |
| Output head | Linear + Softmax | Linear + Softmax (có thể Weight Tying) |
7. Đọc cấu trúc mô hình thật từ config
Đã hiểu kiến trúc, hãy nhìn config vài mô hình mã nguồn mở thật và khớp cấu trúc trừu tượng với số cụ thể.
7.1 Họ LLaMA-2
| Mục config | 7B | 13B | 70B |
|---|---|---|---|
| (hidden dim) | 4096 | 5120 | 8192 |
| (số layer) | 32 | 40 | 80 |
| (số attention head) | 32 | 40 | 64 |
| (dim mỗi head) | 128 | 128 | 128 |
| (FFN mid dim) | 11008 | 13824 | 28672 |
| vocab_size | 32000 | 32000 | 32000 |
| Tổng tham số | 6.7B | 13B | 70B |
| Positional encoding | RoPE | RoPE | RoPE |
| Normalization | RMSNorm | RMSNorm | RMSNorm |
| FFN activation | SwiGLU | SwiGLU | SwiGLU |
| Số KV head | 32 (MHA) | 40 (MHA) | 8 (GQA) |
Điểm khác then chốt ở 70B: nó dùng GQA (Grouped-Query Attention), chỉ 8 KV head (không phải 64), nghĩa là mỗi 8 Q head share một nhóm KV, giảm mạnh chi phí KV Cache lúc inference.
7.2 Suy ngược cấu trúc từ config
Có file config là dựng lại được compute graph. Với LLaMA-2-7B, bung từng layer:
Input: token_ids (batch, seq_len)
  │
  ▼
Token Embedding: (32000, 4096)          ← 131M params
  │
  ▼
═══════════ Decoder Block × 32 layers ═══════════
  Mỗi layer gồm:
  ├─ RMSNorm_1: (4096,)                ← 4K params
  ├─ W_Q: (4096, 4096)                 ← 16.8M params
  ├─ W_K: (4096, 4096)                 ← 16.8M params
  ├─ W_V: (4096, 4096)                 ← 16.8M params
  ├─ W_O: (4096, 4096)                 ← 16.8M params
  ├─ RMSNorm_2: (4096,)                ← 4K params
  ├─ W_gate: (4096, 11008)             ← 45.1M params
  ├─ W_up:   (4096, 11008)             ← 45.1M params
  └─ W_down: (11008, 4096)             ← 45.1M params

  Tổng mỗi layer: ~201M params
  Tổng 32 layer: ~6,432M params
═══════════════════════════════════════════════
  │
  ▼
Final RMSNorm: (4096,)                  ← 4K params
  │
  ▼
LM Head: (4096, 32000)                  ← 131M params (độc lập, không share với Embedding)
  │
  ▼
Output: logits (batch, seq_len, 32000)
Phân bố tham số: 32 Decoder Block chiếm 6,432M / 6,738M 95.5% tham số. “Trí tuệ” của mô hình gần như toàn bộ nằm trong các ma trận weight của Block.
7.3 Quan hệ quy mô với số layer / độ rộng
Phóng to mô hình có hai chiều — sâu hơn (tăng ) và rộng hơn (tăng ). Công thức tham số thô:
Trong đó là tham số một Decoder Block (4 ma trận Attention + 3 ma trận SwiGLU ≈ ), là Embedding + LM Head (họ LLaMA không share; nếu tie embedding như GPT-2, Gemma thì chỉ tính một ).
Từ bảng có thể thấy quy luật:
- 7B → 13B: layer 32 → 40 (+25%), width 4096 → 5120 (+25%), tham số khoảng gấp đôi
- 13B → 70B: layer 40 → 80 (+100%), width 5120 → 8192 (+60%), tham số tăng 5.4 lần
Tham số theo width là bậc hai, theo depth là tuyến tính, nên mở rộng ảnh hưởng tăng tham số mạnh hơn đào sâu.
Liên hệ AI Infra: quan hệ bậc hai này đụng trực tiếp kế hoạch VRAM và chiến lược song song. Width gấp đôi nghĩa là tham số mỗi layer gấp bốn; một card có thể không chứa nổi một layer — lúc đó cần Tensor Parallelism để cắt trong layer. Số layer gấp đôi thì dùng Pipeline Parallelism cắt giữa các layer. Deploy thực tế thường cần kết hợp cả hai.
8. So sánh đặc tính kỹ thuật của ba kiến trúc
Từ góc kỹ sư AI Infra, ba kiến trúc khác nhau rõ về thiết kế hệ thống.
8.1 So sánh đặc tính tính toán
| Chiều | Encoder-only | Encoder-Decoder | Decoder-only |
|---|---|---|---|
| Độ phức tạp attention | , N = độ dài input | Encoder: + Cross: + Decoder: | , N = tổng độ dài chuỗi |
| Chế độ inference | Một lần forward (không tự hồi quy) | Sinh tự hồi quy (phần Decoder) | Sinh tự hồi quy |
| KV Cache | Không cần (không sinh) | Encoder KV + Decoder KV | Một bộ Decoder KV |
| Latency điển hình | Cấp millisecond (phân loại) | Cao hơn (hai component) | Phụ thuộc độ dài sinh |
8.2 Khác biệt chiến lược song song
| Cách song song | Encoder-Decoder | Decoder-only |
|---|---|---|
| Tensor parallelism (TP) | Encoder và Decoder cần cắt riêng; KV của Cross-Attention từ Encoder, pattern giao tiếp phức tạp hơn | Mỗi layer cùng cấu trúc, cách cắt thống nhất, giao tiếp đơn giản |
| Pipeline parallelism (PP) | Phải quyết Encoder/Decoder mỗi bên bao nhiêu stage; cân bằng tải khó hơn | Mọi layer giống nhau, cắt đều là được |
| Sequence parallelism (SP) | Hai bên có thể khác độ dài, phải xử lý riêng | Chỉ một chiều chuỗi, xử lý thống nhất |
8.3 Vì sao Decoder-only thân thiện nhất với kỹ thuật
Ngoài hiệu quả mô hình, Decoder-only thành mainstream LLM còn vì lý do kỹ thuật sâu:
Tính thống nhất kiến trúc. Cả mô hình chỉ một kiểu Block chồng đi chồng lại, nghĩa là:
- CUDA kernel chỉ cần tối ưu một bộ (cùng Attention kernel, cùng FFN kernel tái dùng L lần)
- Chiến lược song song thiết kế một lần (không cần schedule riêng Encoder/Decoder)
- Phân tích hiệu năng và định vị bottleneck đơn giản hơn (đặc tính bất kỳ layer nào đại diện mọi layer)
Quản lý KV Cache đơn giản. Chỉ một bộ KV Cache; các kỹ thuật kiểu PagedAttention áp trực tiếp, không phải xử lý hai bộ cache Encoder output và Decoder KV.
Đường Scaling rõ. Muốn mô hình lớn hơn? Tăng số layer, tăng width, tăng số head — ba núm vặn, hiệu ứng dự đoán được. Không phải đau đầu tỷ lệ Encoder/Decoder.
Tỷ lệ dùng dữ liệu train cao. Mục tiêu “đoán token tiếp theo” nghĩa là mọi token đều sinh tín hiệu train (loss); utilization gần 100%. Encoder-Decoder chỉ sinh loss ở phần Decoder; gradient Encoder toàn nhờ backprop từ loss Decoder.
9. Hiện thực PyTorch: dựng Transformer từ zero
Lý thuyết xong rồi, cách kiểm tốt nhất là tự viết. Chương này dùng PyTorch dựng Encoder-Decoder Transformer đầy đủ từ zero; mỗi module khớp với sơ đồ cấu trúc ở trên.
Import phụ thuộc:
import numpy as np
import torch
import torch.nn as nn
9.1 Cơ chế mask: hiện thực ba loại Mask
Mask là chỗ hiện thực dễ sai nhất. Có đúng ba loại, khớp ba attention ở mục 2.
Length Mask của Encoder: các mẫu trong cùng batch được pad cùng độ dài; phải che trọng số Attention ở vị trí padding. Cách làm: điền score tương ứng bằng -1e4, qua softmax trọng số gần 0.
def get_len_mask(b: int, max_len: int, feat_lens: torch.Tensor, device: torch.device) -> torch.Tensor:
    """Sinh length mask cho self-attention của Encoder.
    Returns: shape (b, max_len, max_len); True nghĩa là vị trí cần che
    """
    attn_mask = torch.ones((b, max_len, max_len), device=device)
    for i in range(b):
        attn_mask[i, :, :feat_lens[i]] = 0
    return attn_mask.to(torch.bool)
Causal Mask của Decoder: lúc train cả chuỗi target vào song song, nhưng dự đoán vị trí chỉ được thấy đến , dùng mask tam giác trên để ép.
def get_subsequent_mask(b: int, max_len: int, device: torch.device) -> torch.Tensor:
    """Sinh causal mask cho self-attention của Decoder (ma trận tam giác trên).
    Returns: shape (b, max_len, max_len); True nghĩa là vị trí tương lai (cần che)
    """
    return torch.triu(torch.ones((b, max_len, max_len), device=device), diagonal=1).to(torch.bool)
torch.triu(..., diagonal=1) giữ tam giác trên nghiêm (); hàng chỉ attend được cột đến .
Mask Cross-Attention Encoder-Decoder: trong Cross-Attention mỗi tầng Decoder, K/V đến từ Encoder; phải che phần padding trong output Encoder.
def get_enc_dec_mask(
    b: int,
    max_feat_len: int,
    feat_lens: torch.Tensor,
    max_label_len: int,
    device: torch.device,
) -> torch.Tensor:
    """Sinh mask Cross-Attention Encoder-Decoder.
    Returns: shape (b, max_label_len, max_feat_len); True nghĩa là vị trí padding của Encoder
    """
    attn_mask = torch.zeros((b, max_label_len, max_feat_len), device=device)
    for i in range(b):
        attn_mask[i, :, feat_lens[i]:] = 1
    return attn_mask.to(torch.bool)
So sánh ba Mask:
| Loại Mask | Dùng ở đâu | Shape | Mục đích |
|---|---|---|---|
| Length Mask | Self-attention Encoder | (b, enc_len, enc_len) | Che padding Encoder |
| Causal Mask | Self-attention Decoder | (b, dec_len, dec_len) | Không nhìn token tương lai |
| Cross-Attn Mask | Cross-Attention Decoder | (b, dec_len, enc_len) | Che padding Encoder |
⚠️ Lưu ý: bài này dùng masked_fill_(mask, -1e4), True nghĩa là cần che. scaled_dot_product_attention của PyTorch 2.0 với mask bool cùng nghĩa (True cũng là che); nếu truyền mask float thì cộng thẳng vào scores (số âm lớn đóng vai trò che).
9.2 Multi-Head Attention
Khớp công thức Scaled Dot-Product Attention ở mục 3:
Hiện thực bốn bước: chiếu tuyến tính → tách multi-head → Scaled Dot-Product Attention → gộp output.
class MultiHeadAttention(nn.Module):
    def __init__(self, d_k, d_v, d_model, num_heads, p=0.):
        """
        Args:
            d_k: chiều Key/Query mỗi attention head
            d_v: chiều Value mỗi attention head
            d_model: tổng chiều vào/ra
            num_heads: số attention head
        """
        super(MultiHeadAttention, self).__init__()
        self.d_k = d_k
        self.d_v = d_v
        self.d_model = d_model
        self.num_heads = num_heads
        self.dropout = nn.Dropout(p)

        # Bốn chiếu tuyến tính: Q, K, V và chiếu đầu ra
        self.W_Q = nn.Linear(d_model, d_k * num_heads)
        self.W_K = nn.Linear(d_model, d_k * num_heads)
        self.W_V = nn.Linear(d_model, d_v * num_heads)
        self.W_out = nn.Linear(d_v * num_heads, d_model)

        # Khởi tạo trọng số (theo hướng He-initialization)
        nn.init.normal_(self.W_Q.weight, mean=0, std=np.sqrt(2.0 / (d_model + d_k)))
        nn.init.normal_(self.W_K.weight, mean=0, std=np.sqrt(2.0 / (d_model + d_k)))
        nn.init.normal_(self.W_V.weight, mean=0, std=np.sqrt(2.0 / (d_model + d_v)))
        nn.init.normal_(self.W_out.weight, mean=0, std=np.sqrt(2.0 / (d_model + d_v)))

    def forward(self, Q, K, V, attn_mask):
        """
        Args:
            Q: (batch, q_len, d_model)
            K: (batch, k_len, d_model)
            V: (batch, v_len, d_model)  lưu ý k_len == v_len
            attn_mask: (batch, q_len, k_len) hoặc None
        Returns:
            output: (batch, q_len, d_model)
        """
        N = Q.size(0)
        q_len, k_len = Q.size(1), K.size(1)
        d_k, d_v, num_heads = self.d_k, self.d_v, self.num_heads

        # Bước 1: chiếu tuyến tính + tách multi-head
        # (N, q_len, d_model) -> (N, num_heads, q_len, d_k)
        Q = self.W_Q(Q).view(N, -1, num_heads, d_k).transpose(1, 2)
        K = self.W_K(K).view(N, -1, num_heads, d_k).transpose(1, 2)
        V = self.W_V(V).view(N, -1, num_heads, d_v).transpose(1, 2)

        # Bước 2: broadcast Mask lên chiều head
        if attn_mask is not None:
            assert attn_mask.size() == (N, q_len, k_len)
            attn_mask = attn_mask.unsqueeze(1).repeat(1, num_heads, 1, 1).bool()

        # Bước 3: Scaled Dot-Product Attention
        scores = torch.matmul(Q, K.transpose(-1, -2)) / np.sqrt(d_k)
        if attn_mask is not None:
            scores.masked_fill_(attn_mask, -1e4)
        attns = torch.softmax(scores, dim=-1)
        attns = self.dropout(attns)

        # Bước 4: tổng có trọng số + gộp multi-head + chiếu đầu ra
        output = torch.matmul(attns, V)
        output = output.transpose(1, 2).contiguous().reshape(N, -1, d_v * num_heads)
        output = self.W_out(output)
        return output
💡 Gợi ý: cấu hình chuẩn paper là , , , lúc đó , chiều vào/ra khớp nhau.
9.3 Mã hóa vị trí sine/cosine
Khớp thiết kế Positional Encoding ở §3.1; hiện thực công thức sine/cosine của paper gốc:
def pos_sinusoid_embedding(seq_len: int, d_model: int) -> torch.Tensor:
    """Sinh ma trận mã hóa vị trí sine/cosine (không học được; đóng băng trọng số).
    Returns: (seq_len, d_model)
    """
    embeddings = torch.zeros((seq_len, d_model))
    for i in range(d_model):
        f = torch.sin if i % 2 == 0 else torch.cos
        embeddings[:, i] = f(
            torch.arange(0, seq_len) / np.power(1e4, 2 * (i // 2) / d_model)
        )
    return embeddings.float()
Trong Encoder/Decoder, nn.Embedding.from_pretrained(..., freeze=True) cố định positional encoding thành tham số không học; lúc dùng index theo vị trí để tra bảng.
9.4 Position-wise FFN
Khớp submodule FFN của tầng Encoder ở §3.2: bản chất là MLP hai tầng áp độc lập cho từng token:
Dùng nn.Linear trên chiều cuối; không cần transpose:
class PoswiseFFN(nn.Module):
    def __init__(self, d_model: int, d_ff: int, p: float = 0.):
        """d_ff thường là 4 * d_model (ví dụ d_model=512 → d_ff=2048)"""
        super(PoswiseFFN, self).__init__()
        self.fc1 = nn.Linear(d_model, d_ff)
        self.fc2 = nn.Linear(d_ff, d_model)
        self.relu = nn.ReLU(inplace=True)
        self.dropout = nn.Dropout(p=p)

    def forward(self, X):
        # X: (N, seq_len, d_model)
        out = self.fc1(X)          # -> (N, seq_len, d_ff)
        out = self.relu(out)
        out = self.fc2(out)        # -> (N, seq_len, d_model)
        return self.dropout(out)
9.5 EncoderLayer và Encoder
EncoderLayer khớp sơ đồ luồng dữ liệu §3.2: Multi-Head Self-Attention + FFN, mỗi sublayer bọc residual và LayerNorm (kiểu Post-Norm).
class EncoderLayer(nn.Module):
    def __init__(self, dim: int, n: int, dff: int, dropout_posffn: float, dropout_attn: float):
        assert dim % n == 0
        super(EncoderLayer, self).__init__()
        hdim = dim // n  # chiều mỗi attention head

        self.norm1 = nn.LayerNorm(dim)
        self.norm2 = nn.LayerNorm(dim)
        self.multi_head_attn = MultiHeadAttention(hdim, hdim, dim, n, dropout_attn)
        self.poswise_ffn = PoswiseFFN(dim, dff, p=dropout_posffn)

    def forward(self, enc_in, attn_mask):
        # Self-Attention: Q=K=V=enc_in (attention hai chiều ở §3.3)
        residual = enc_in
        context = self.multi_head_attn(enc_in, enc_in, enc_in, attn_mask)
        out = self.norm1(residual + context)   # residual + LayerNorm

        # FFN
        residual = out
        out = self.poswise_ffn(out)
        out = self.norm2(residual + out)       # residual + LayerNorm
        return out
Encoder đầy đủ: trước N EncoderLayer cộng positional encoding.
class Encoder(nn.Module):
    def __init__(self, dropout_emb, dropout_posffn, dropout_attn,
                 num_layers, enc_dim, num_heads, dff, tgt_len):
        super(Encoder, self).__init__()
        self.tgt_len = tgt_len
        # Positional encoding sine cố định (freeze=True: không cập nhật gradient)
        self.pos_emb = nn.Embedding.from_pretrained(
            pos_sinusoid_embedding(tgt_len, enc_dim), freeze=True
        )
        self.emb_dropout = nn.Dropout(dropout_emb)
        self.layers = nn.ModuleList(
            [EncoderLayer(enc_dim, num_heads, dff, dropout_posffn, dropout_attn)
             for _ in range(num_layers)]
        )

    def forward(self, X, X_lens, mask=None):
        # X: (batch, seq_len, d_model)
        seq_len = X.size(1)
        out = X + self.pos_emb(torch.arange(seq_len, device=X.device))  # cộng positional encoding
        out = self.emb_dropout(out)
        for layer in self.layers:
            out = layer(out, mask)
        return out
9.6 DecoderLayer và Decoder
DecoderLayer khớp sơ đồ luồng dữ liệu §4.1: ba sublayer — Masked Self-Attention → Cross-Attention → FFN.
class DecoderLayer(nn.Module):
    def __init__(self, dim: int, n: int, dff: int, dropout_posffn: float, dropout_attn: float):
        assert dim % n == 0
        super(DecoderLayer, self).__init__()
        hdim = dim // n

        self.norm1 = nn.LayerNorm(dim)
        self.norm2 = nn.LayerNorm(dim)
        self.norm3 = nn.LayerNorm(dim)
        self.poswise_ffn = PoswiseFFN(dim, dff, p=dropout_posffn)
        self.dec_attn = MultiHeadAttention(hdim, hdim, dim, n, dropout_attn)     # Masked Self-Attn
        self.enc_dec_attn = MultiHeadAttention(hdim, hdim, dim, n, dropout_attn) # Cross-Attn

    def forward(self, dec_in, enc_out, dec_mask, dec_enc_mask):
        """
        dec_in:       (batch, dec_len, d_model)  input tầng Decoder hiện tại
        enc_out:      (batch, enc_len, d_model)  output cuối Encoder
        dec_mask:     Causal Mask (batch, dec_len, dec_len)
        dec_enc_mask: Cross-Attn Mask (batch, dec_len, enc_len)
        """
        # 1. Masked Self-Attention (xem §4.2)
        residual = dec_in
        context = self.dec_attn(dec_in, dec_in, dec_in, dec_mask)
        dec_out = self.norm1(residual + context)

        # 2. Cross-Attention (xem §4.3): Q từ Decoder, K/V từ Encoder
        residual = dec_out
        context = self.enc_dec_attn(dec_out, enc_out, enc_out, dec_enc_mask)
        dec_out = self.norm2(residual + context)

        # 3. FFN
        residual = dec_out
        out = self.poswise_ffn(dec_out)
        dec_out = self.norm3(residual + out)
        return dec_out
Decoder đầy đủ: Word Embedding cho chuỗi target, cộng positional encoding rồi decode từng tầng.
class Decoder(nn.Module):
    def __init__(self, dropout_emb, dropout_posffn, dropout_attn,
                 num_layers, dec_dim, num_heads, dff, tgt_len, tgt_vocab_size):
        super(Decoder, self).__init__()
        # Word Embedding: map token ID sang vector d_model chiều
        self.tgt_emb = nn.Embedding(tgt_vocab_size, dec_dim)
        self.dropout_emb = nn.Dropout(p=dropout_emb)
        # Positional encoding sine cố định
        self.pos_emb = nn.Embedding.from_pretrained(
            pos_sinusoid_embedding(tgt_len, dec_dim), freeze=True
        )
        self.layers = nn.ModuleList(
            [DecoderLayer(dec_dim, num_heads, dff, dropout_posffn, dropout_attn)
             for _ in range(num_layers)]
        )

    def forward(self, labels, enc_out, dec_mask, dec_enc_mask):
        # labels: (batch, dec_len) chuỗi token ID
        tgt_emb = self.tgt_emb(labels)
        pos_emb = self.pos_emb(torch.arange(labels.size(1), device=labels.device))
        dec_out = self.dropout_emb(tgt_emb + pos_emb)
        for layer in self.layers:
            dec_out = layer(dec_out, enc_out, dec_mask, dec_enc_mask)
        return dec_out
9.7 Ghép Transformer đầy đủ
Ghép Frontend (biến đổi đặc trưng đầu vào), Encoder, Decoder và LM Head thành mô hình đầy đủ, khớp sơ đồ kiến trúc tổng thể §2.2:
class Transformer(nn.Module):
    def __init__(self, frontend: nn.Module, encoder: Encoder,
                 decoder: Decoder, dec_out_dim: int, vocab: int):
        """
        frontend:    biến đổi đặc trưng đầu vào (ví dụ linear fbank_dim → d_model)
        dec_out_dim: chiều output Decoder (= d_model)
        vocab:       kích thước vocab target
        """
        super().__init__()
        self.frontend = frontend
        self.encoder = encoder
        self.decoder = decoder
        self.linear = nn.Linear(dec_out_dim, vocab)  # LM Head

    def forward(self, X: torch.Tensor, X_lens: torch.Tensor, labels: torch.Tensor):
        """
        X:      (batch, enc_len, fbank_dim)  chuỗi đặc trưng đầu vào
        X_lens: (batch,)                      độ dài input thật mỗi mẫu
        labels: (batch, dec_len)              chuỗi token ID target
        Returns: logits (batch, dec_len, vocab_size)
        """
        X_lens, labels = X_lens.long(), labels.long()
        b, device = X.size(0), X.device

        # Frontend + Encoder (cấu trúc Encoder ở mục 3)
        out = self.frontend(X)
        max_feat_len = out.size(1)
        enc_mask = get_len_mask(b, max_feat_len, X_lens, device)
        enc_out = self.encoder(out, X_lens, enc_mask)

        # Decoder (cấu trúc Decoder ở mục 4)
        max_label_len = labels.size(1)
        dec_mask = get_subsequent_mask(b, max_label_len, device)
        dec_enc_mask = get_enc_dec_mask(b, max_feat_len, X_lens, max_label_len, device)
        dec_out = self.decoder(labels, enc_out, dec_mask, dec_enc_mask)

        # LM Head
        return self.linear(dec_out)
9.8 Kiểm forward
Dùng dummy data ngẫu nhiên để kiểm cả forward:
if __name__ == "__main__":
    batch_size    = 16
    max_feat_len  = 100    # độ dài input Encoder tối đa
    max_label_len = 50     # độ dài target Decoder tối đa
    fbank_dim     = 80     # chiều đặc trưng đầu vào (ví dụ Fbank 80 chiều)
    hidden_dim    = 512    # d_model
    vocab_size    = 26     # kích thước vocab

    fbank_feature = torch.randn(batch_size, max_feat_len, fbank_dim)
    feat_lens     = torch.randint(1, max_feat_len, (batch_size,))
    labels        = torch.randint(0, vocab_size, (batch_size, max_label_len))

    feature_extractor = nn.Linear(fbank_dim, hidden_dim)
    encoder = Encoder(
        dropout_emb=0.1, dropout_posffn=0.1, dropout_attn=0.,
        num_layers=6, enc_dim=hidden_dim, num_heads=8, dff=2048, tgt_len=2048,
    )
    decoder = Decoder(
        dropout_emb=0.1, dropout_posffn=0.1, dropout_attn=0.,
        num_layers=6, dec_dim=hidden_dim, num_heads=8, dff=2048,
        tgt_len=2048, tgt_vocab_size=vocab_size,
    )
    model = Transformer(feature_extractor, encoder, decoder, hidden_dim, vocab_size)

    logits = model(fbank_feature, feat_lens, labels)
    print(f"logits shape: {logits.shape}")
    # output: logits shape: torch.Size([16, 50, 26])
logits có shape (batch_size, dec_len, vocab_size): phân phối trên vocab ở mỗi bước decode. Gắn cross-entropy loss là train được.
📝 Tóm tắt
Một bảng nhắc lại nội dung cốt lõi:
| Chủ đề | Điểm chính |
|---|---|
| Transformer gốc | Encoder-Decoder, thiết kế cho Seq2Seq (dịch) |
| Ba attention | Encoder Self-Attention (hai chiều), Masked Decoder Self-Attention (nhân quả), Cross-Attention (cross-sequence) |
| Encoder | Attention hai chiều + FFN; biểu diễn ngữ cảnh của input |
| Decoder | Causal Self-Attention + Cross-Attention + FFN; sinh tự hồi quy |
| Ba nhánh tiến hóa | Encoder-only (BERT), Encoder-Decoder (T5), Decoder-only (GPT/LLaMA) |
| Cấu trúc Decoder-only | Embedding → L Decoder Block → Final Norm → LM Head → Softmax |
| Ưu điểm Decoder-only | Mục tiêu train thống nhất, kỹ thuật gọn, Scaling rõ, quản lý KV Cache đơn giản |
| Code | Ba Mask → MultiHeadAttention → PE sine → FFN → EncoderLayer → DecoderLayer → Transformer |
Nhìn toàn cảnh, triết lý thiết kế Transformer gói trong ba câu:
- Attention lo trao đổi thông tin — token truyền thông tin cho nhau
- FFN lo gia công thông tin — biến đổi phi tuyến độc lập từng token
- Residual + normalization giữ train ổn — stack sâu vẫn train được
Ba trụ đó cộng ý tưởng “chồng” (lặp cùng Block N lần) là toàn bộ tinh túy Transformer. Khi đi sâu từng module sau này, hãy quay lại bản đồ này và kiểm vị trí của linh kiện trong cả cỗ máy.
🎯 Checklist tự kiểm
- Vẽ được sơ đồ Encoder-Decoder gốc; đánh dấu vị trí ba attention và nguồn Q/K/V
- Giải thích vai trò và khác biệt của Encoder Self-Attention, Masked Decoder Self-Attention, Cross-Attention
- Nói rõ Encoder-only, Encoder-Decoder, Decoder-only mỗi cái giữ gì và cắt gì từ Transformer gốc
- Mô tả end-to-end inference Decoder-only LLM: token ID → Embedding → N Block → Norm → LM Head → Softmax → sample
- Thuộc năm component Decoder-only (Embedding, stack Block, Final Norm, LM Head, Softmax) và vai trò từng cái
- Cho tham số config (, , vocab_size, …), ước lượng tổng số tham số
- Giải thích Weight Tying nghĩa là gì và vì sao hữu ích về kỹ thuật
- Từ góc kỹ thuật, nêu ít nhất ba lý do Decoder-only thân thiện hơn với AI Infra
- Nêu tên ba Mask, chỗ dùng và shape (
(b, q_len, k_len)) - Giải thích vì sao Causal Mask dùng tam giác trên và
torch.triu(..., diagonal=1)nghĩa là gì - Mô tả bốn bước Multi-Head Attention: chiếu tuyến tính → tách head → Scaled Dot-Product Attention → gộp output
- Viết công thức PE sine và giải thích vì sao Transformer cần vị trí tường minh còn RNN thì không
- Chạy kiểm forward đầy đủ và giải thích ý nghĩa chiều của
logits
📚 Tài liệu tham khảo
- Attention Is All You Need (Vaswani et al., 2017) — Paper Transformer gốc; Encoder-Decoder đầy đủ và PE sine
- BERT: Pre-training of Deep Bidirectional Transformers (Devlin et al., 2018) — Công trình mở đường Encoder-only
- Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer (Raffel et al., 2019) — T5; paradigm Encoder-Decoder thống nhất
- Language Models are Unsupervised Multitask Learners (Radford et al., 2019) — GPT-2; nền tảng Decoder-only
- LLaMA: Open and Efficient Foundation Language Models (Touvron et al., 2023) — Kiến trúc và config LLaMA
- Sequence to Sequence Learning with Neural Networks (Sutskever et al., 2014) — Paper nền tảng Encoder-Decoder
- Are Sixteen Heads Really Better than One? (Michel et al., 2019) — Phân tích thực nghiệm multi-head attention
- The Illustrated Transformer (Jay Alammar) — Intro Transformer bằng hình
- The Annotated Transformer (Harvard NLP) — Paper từng dòng kèm PyTorch
- PyTorch nn.MultiheadAttention — Docs Multi-Head Attention chính thức