🔥 GPU基础知识:从硬件架构到AI计算
系统理解 GPU 硬件架构、CUDA 编程模型、显存层次和计算单元,为深入学习 AI Infra打下坚实基础
GPU 是大模型时代的”发动机”——训练一个千亿参数的 LLM 可能需要数千块 GPU 运行数月,而推理服务的吞吐量和延迟也直接取决于 GPU 的利用效率。对于 AI Infra 工程师来说,理解 GPU 不是选修课,而是所有后续优化(算子、并行、调度)的硬件基础。
本文将从最基本的问题出发——GPU 为什么适合 AI 计算?它内部长什么样?程序是如何在上面运行的?——帮你建立一套完整的 GPU 认知框架。
📑 目录
- 1. CPU vs GPU:为什么深度学习选择了 GPU
- 2. GPU 硬件架构剖析
- 3. 显存层次与带宽
- 4. Tensor Core:AI 加速的核心引擎
- 5. CUDA 编程模型
- 6. GPU 关键性能指标
- 7. 主流 AI GPU 横向对比
- 8. 显存管理:AI Infra 的核心挑战
- 9. 多卡互联:从单机到集群
- 总结
- 自我检验清单
- 参考资料
1. CPU vs GPU:为什么深度学习选择了 GPU
要理解 GPU 的价值,最好的方式是把它和 CPU 放在一起对比。
想象你要批改 10000 份选择题试卷。CPU 的做法是请一位经验丰富的阅卷老师,他速度快、能处理各种复杂题型,但一次只能改一份;GPU 的做法是请 10000 个临时工,每人只会对答案这一件事,但所有人同时开工——1 秒就全部改完了。
这就是 延迟导向(Latency-oriented)与 吞吐导向(Throughput-oriented)的核心区别。
1.1 架构哲学的根本差异
| 📊 对比维度 | CPU | GPU |
|---|---|---|
| 设计目标 | 低延迟处理复杂任务 | 高吞吐处理大量简单任务 |
| 核心数量 | 几个到几十个”大核” | 数千到上万个”小核” |
| 单核能力 | 强(复杂分支预测、乱序执行) | 弱(简单 ALU,按序执行) |
| 缓存占比 | 芯片面积的大部分 | 芯片面积的小部分 |
| 控制逻辑 | 复杂(乱序执行、分支预测器) | 简单(大量核心共享控制单元) |
| 内存带宽 | 较低(DDR5 ~100 GB/s) | 极高(HBM3 ~3 TB/s) |
| 适合任务 | 串行逻辑、操作系统、网络服务 | 矩阵运算、数据并行、图形渲染 |
1.2 深度学习为什么天然适合 GPU
深度学习的计算核心是什么?拆到最底层,就是海量的矩阵乘法和逐元素运算:
- 前向传播:每一层都是 ,本质是矩阵乘法
- 反向传播:计算梯度依然是矩阵乘法()
- Attention 计算:,核心还是矩阵乘法
这些运算有两个关键特征:
- 数据并行度极高:矩阵中每个元素的计算相互独立,天然可以分配给不同的计算核心
- 计算模式规则:不需要复杂的分支判断,所有线程执行相同的指令
这恰好是 GPU 的长项——用成千上万个简单核心同时处理,吞吐量远超 CPU。
💡 提示:一块 H100 GPU 的 FP16 算力约为 989 TFLOPS,而高端服务器 CPU(如 Intel Xeon w9-3595X)的 FP16 算力通常在个位数 TFLOPS 级别。差距在两个数量级以上。
2. GPU 硬件架构剖析
了解了 GPU “为什么快”之后,我们来看看它”内部长什么样”。以 NVIDIA GPU 为例,从外到内可以分为三个层次:
2.1 GPC → TPC → SM 的层级结构
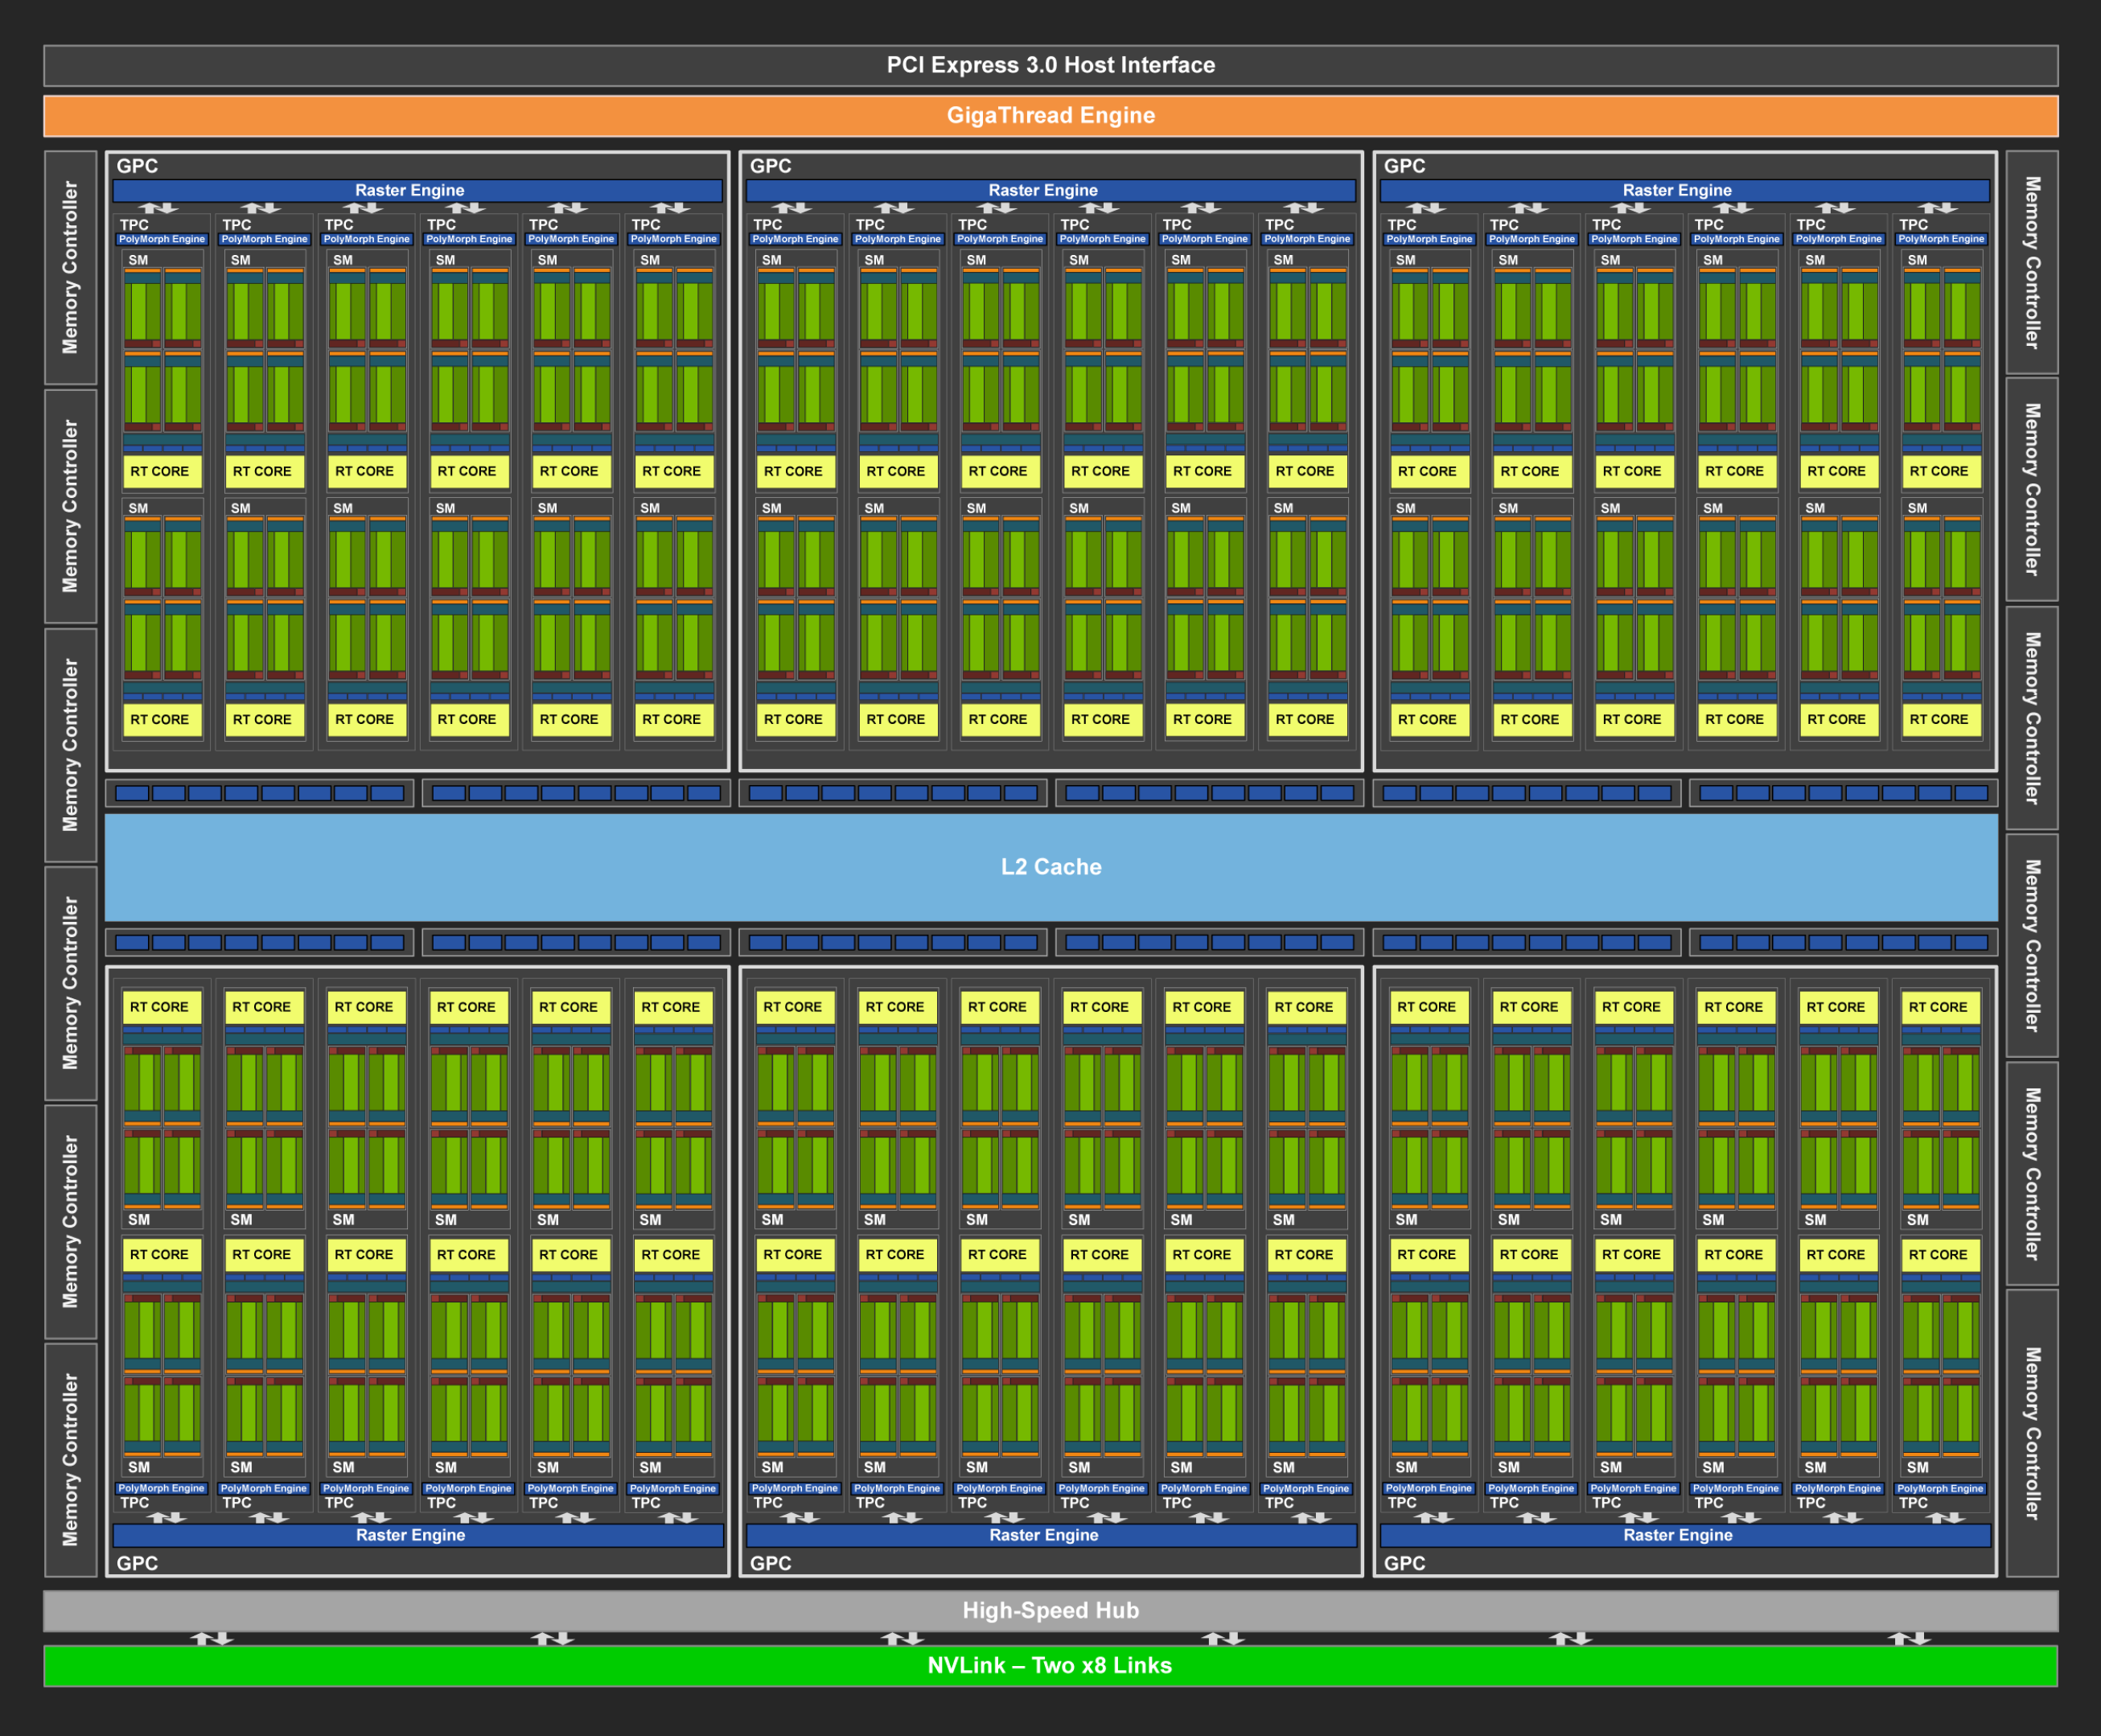
NVIDIA GPU 的计算核心按层级组织,就像一家大公司的组织架构:
GPU 芯片
├── GPC (Graphics Processing Cluster)  ← "事业部"
│   ├── TPC (Texture Processing Cluster)  ← "部门"
│   │   ├── SM (Streaming Multiprocessor)  ← "小组",GPU 的基本调度单元
│   │   │   ├── CUDA Core × N  ← "组员",执行 FP32/INT32 运算
│   │   │   ├── Tensor Core × M  ← "专家",执行矩阵运算
│   │   │   ├── SFU (Special Function Unit)  ← 执行 sin/cos/exp 等
│   │   │   ├── Register File  ← 寄存器堆(速度最快的存储)
│   │   │   ├── Shared Memory  ← 共享内存(SM 内所有线程共享)
│   │   │   └── L1 Cache
│   │   └── SM ...
│   └── TPC ...
├── GPC ...
├── L2 Cache(全局共享)
└── Memory Controller → HBM(显存)
2.2 SM:GPU 的基本调度单元
SM(Streaming Multiprocessor)是理解 GPU 架构的关键,所有的线程调度和执行都发生在 SM 层面。
以 H100 的 SM 为例,每个 SM 内部包含:
| 🔧 组件 | 数量 | 功能 |
|---|---|---|
| CUDA Core(FP32) | 128 | 执行浮点和整数运算 |
| Tensor Core(第四代) | 4 | 执行矩阵乘累加(MMA)运算 |
| Load/Store Unit | 32 | 负责内存读写 |
| SFU | 16 | 执行超越函数(sin、cos、exp 等) |
| Warp Scheduler | 4 | 每周期调度 4 个 Warp |
| Register File | 256 KB | 线程私有寄存器 |
| Shared Memory / L1 Cache | 228 KB(可配置) | SM 内共享的高速存储 |
📌 关键点:SM 是资源分配的最小粒度。当你编写 CUDA Kernel 时,一个 Thread Block 会被调度到一个 SM 上执行。SM 内的寄存器、共享内存等资源由这个 SM 上的所有 Thread Block 共同分配。
2.3 Warp:GPU 执行的最小单位
GPU 不是一个线程一个线程执行的,而是以 Warp(线程束)为单位,32 个线程锁步执行同一条指令。这就像军队齐步走——32 个士兵听同一声号令,迈出同一只脚。
Warp(32 个线程)
├── Thread 0:  执行 add r1, r2, r3
├── Thread 1:  执行 add r1, r2, r3  (同一条指令,不同数据)
├── Thread 2:  执行 add r1, r2, r3
├── ...
└── Thread 31: 执行 add r1, r2, r3
这种执行模式叫做 SIMT(Single Instruction, Multiple Threads),是 NVIDIA 对 SIMD 的扩展。
⚠️ 注意:如果 Warp 内的线程遇到分支(if-else),走不同分支的线程会被 掩码(mask),导致部分线程空转。这就是所谓的 Warp Divergence,是 GPU 编程中需要极力避免的性能杀手。
3. 显存层次与带宽
GPU 的计算再快,如果数据”喂”不上来也白搭。在 AI 工作负载中,显存带宽往往比算力更先成为瓶颈——这就是为什么 AI Infra 领域有句话叫 “Memory is the new compute”。
3.1 GPU 存储层级金字塔
GPU 的存储层级和 CPU 类似,越靠近计算核心速度越快、容量越小。下表以 H100 SXM 为例,带宽为整卡聚合值:
| 📊 层级 | 容量 | 带宽 | 延迟 | 作用域 | 说明 |
|---|---|---|---|---|---|
| Register(寄存器) | 每线程 ~255 个 | — | ~0 cycle | 单线程私有 | 最快,但容量极有限 |
| Shared Memory | 每 SM ~228 KB | ~31 TB/s | ~30 cycle | SM 内所有线程 | 程序员显式管理的”L1 级别”缓存 |
| L1 Cache | 与 Shared Memory 共享 | 与 Shared Memory 合计 ~31 TB/s | ~30 cycle | SM 内 | 硬件自动管理 |
| L2 Cache | 整卡 ~50 MB | ~9.45 TB/s | ~200 cycle | 全局 | 所有 SM 共享 |
| HBM(显存) | 80 GB | 3.35 TB/s | ~600 cycle | 全局 | 主存储,带宽决定吞吐上限 |
带宽数据说明:
- Shared Memory 的 ~31 TB/s 是理论估算,按每 SM 32 个 bank × 4 B/cycle = 128 B/cycle 计算,即 132 SM × 128 B × 1.83 GHz ≈ 31 TB/s,前提是没有 Bank Conflict。
- L1 和 Shared Memory 是同一块物理 SRAM,带宽共享。TileLang 论文给出的 30.92 TB/s 是两者合并的口径,不能当作 L1 单独的带宽。
- L2 的 9.45 TB/s 取自 TileLang 论文附录 D 的 Table 2。不同测试方法得到的 L2 实测值差异较大,这里只作量级参考。
- HBM3 的 3.35 TB/s 是 NVIDIA 官方给出的理论峰值。
3.2 HBM:高带宽显存
传统 GDDR 显存就像一条单车道公路——传输速率有限。HBM(High Bandwidth Memory)则是把几千条车道堆叠在一起,通过硅中介层(Silicon Interposer)直接和 GPU 芯片互联,实现数倍的带宽提升。
| 📊 显存类型 | 代表 GPU | 带宽 | 容量 |
|---|---|---|---|
| GDDR6X | RTX 4090 | 1,008 GB/s | 24 GB |
| HBM2e | A100 | 2,039 GB/s | 80 GB |
| HBM3 | H100 | 3,350 GB/s | 80 GB |
| HBM3e | B200 | 8,000 GB/s | 192 GB |
💡 提示:从 A100 到 B200,显存带宽增长了近 4 倍。这对 LLM 推理意义重大——推理阶段的 decode 是典型的 Memory-bound 任务,带宽每提升 1 倍,理论吞吐量就能接近翻倍。
3.3 Roofline 模型:算力 vs 带宽的平衡点
判断一个计算任务是 Compute-bound(受算力限制)还是 Memory-bound(受带宽限制),可以用 算术强度(Arithmetic Intensity)这个指标:
当算术强度低于 GPU 的 ops:byte 比(即算力 / 带宽)时,任务是 Memory-bound;反之是 Compute-bound。
以 H100 SXM 为例:
- FP16 算力:989 TFLOPS
- HBM3 带宽:3,350 GB/s
- ops:byte 比 = FLOPs/Byte
这意味着:如果你的 Kernel 每从显存读取 1 Byte 数据,需要执行至少 295 次 FP16 浮点运算才能让算力充分跑满。否则 GPU 会”闲着等数据”。
📌 关键点:大多数深度学习算子(尤其是 Attention、LayerNorm、激活函数等)的算术强度远低于 295,这就是为什么 FlashAttention、Kernel Fusion 等优化技术如此重要——它们的核心思路就是减少显存访问、提升算术强度。
4. Tensor Core:AI 加速的核心引擎
CUDA Core 执行标量算术指令;以支持每周期一次 FP32 FMA(fused multiply-add)的执行单元为例,其峰值吞吐量为每周期 2 FLOPs。Tensor Core 则是专门执行矩阵乘累加的单元,每周期可完成多次标量乘加等价运算,具体吞吐量取决于架构、输入精度、累加精度及是否使用结构化稀疏。
4.1 工作原理
Tensor Core 执行的基本操作是 矩阵乘累加(MMA, Matrix Multiply-Accumulate):
其中 、、、 是小尺寸矩阵(具体尺寸取决于精度和架构代次)。
以 PTX 指令 mma.sync.aligned.m16n8k16.row.col.f32.f16.f16.f32 为例, 表示逻辑矩阵尺寸 :
- 矩阵 A:形状 16 × 16,FP16。
- 矩阵 B:形状 16 × 8,FP16。
- 矩阵 C 和 D:形状 16 × 8,FP32,用于累加及输出。
- 一次完整 MMA 的计算量为 FLOPs,按一次标量乘加计 2 FLOPs。
指令形状不等于单个 Tensor Core 每周期的吞吐量。 上述 mma.sync 由整个 Warp 的线程协同执行,4096 FLOPs 是这次 Warp 级操作的总计算量,不能再乘以 32,也不能直接当作单个 Tensor Core 一个周期完成的计算量。PTX 描述的是指令语义;硬件执行吞吐量和指令延迟需要另查目标架构资料,不能仅由 推出。NVIDIA PTX ISA:mma
4.2 精度格式演进
不同精度格式在算力、精度、显存占用之间做了不同的取舍:
| 📊 精度 | 位宽 | 动态范围 | 首次 Tensor Core 支持 | 典型应用 |
|---|---|---|---|---|
| FP32 | 32 bit | 高 | — | 基准精度、loss 累加 |
| TF32 | 19 bit | 同 FP32 | Ampere(A100) | 训练(Ampere 上的默认 FP32 路径) |
| FP16 | 16 bit | 较窄 | Volta(V100) | 混合精度训练(需 loss scaling) |
| BF16 | 16 bit | 同 FP32 | Ampere(A100) | 混合精度训练(推荐,无需 loss scaling) |
| FP8(E4M3/E5M2) | 8 bit | 可选 | Hopper(H100) | 训练 + 推理 |
| INT8 | 8 bit | 整数 | Turing(T4) | 推理量化 |
| FP4 | 4 bit | 极窄 | Blackwell(B200) | 推理量化 |
💡 提示:BF16 和 FP16 都是 16 位,但 BF16 保留了和 FP32 相同的 8 位指数位,因此动态范围更大,训练时更不容易溢出。现代大模型训练几乎都用 BF16 而非 FP16。
4.3 Tensor Core 的算力倍增
不同计算路径的峰值差异很大。以 H100 SXM 为例,下表统一采用稠密(Dense)口径,Tensor Core 行采用 FP32 累加:
| 📊 计算路径 | 理论峰值算力(约) |
|---|---|
| CUDA Core,FP32 FMA | 67 TFLOPS |
| Tensor Core,TF32 输入 | 495 TFLOPS |
| Tensor Core,FP16 / BF16 输入 | 989 TFLOPS |
| Tensor Core,FP8 输入 | 1,979 TFLOPS |
这些是不同精度和执行路径的硬件峰值,不能直接当作应用加速比;尤其 TF32 不具有完整 FP32 的尾数精度。NVIDIA H100 产品页中带星号的 Tensor Core 数值包含稀疏加速,上表将其除以 2 后取近似值。NVIDIA H100 规格及稀疏脚注
📌 关键点:要触发 Tensor Core 加速,矩阵的维度必须满足对齐要求(通常是 8 或 16 的倍数)。在实际工程中,如果模型的 hidden_size 不是 8 的倍数,Tensor Core 可能无法被充分利用。
5. CUDA 编程模型
CUDA 是 NVIDIA 提供的并行计算编程框架,是连接”软件算法”和”硬件执行”的桥梁。即使你日常用 PyTorch 而不直接写 CUDA,理解它的编程模型也有助于理解底层发生了什么。
5.1 线程层级:Grid → Block → Thread
CUDA 程序以 Kernel 为单位在 GPU 上执行。Kernel 的线程按三级层次组织:
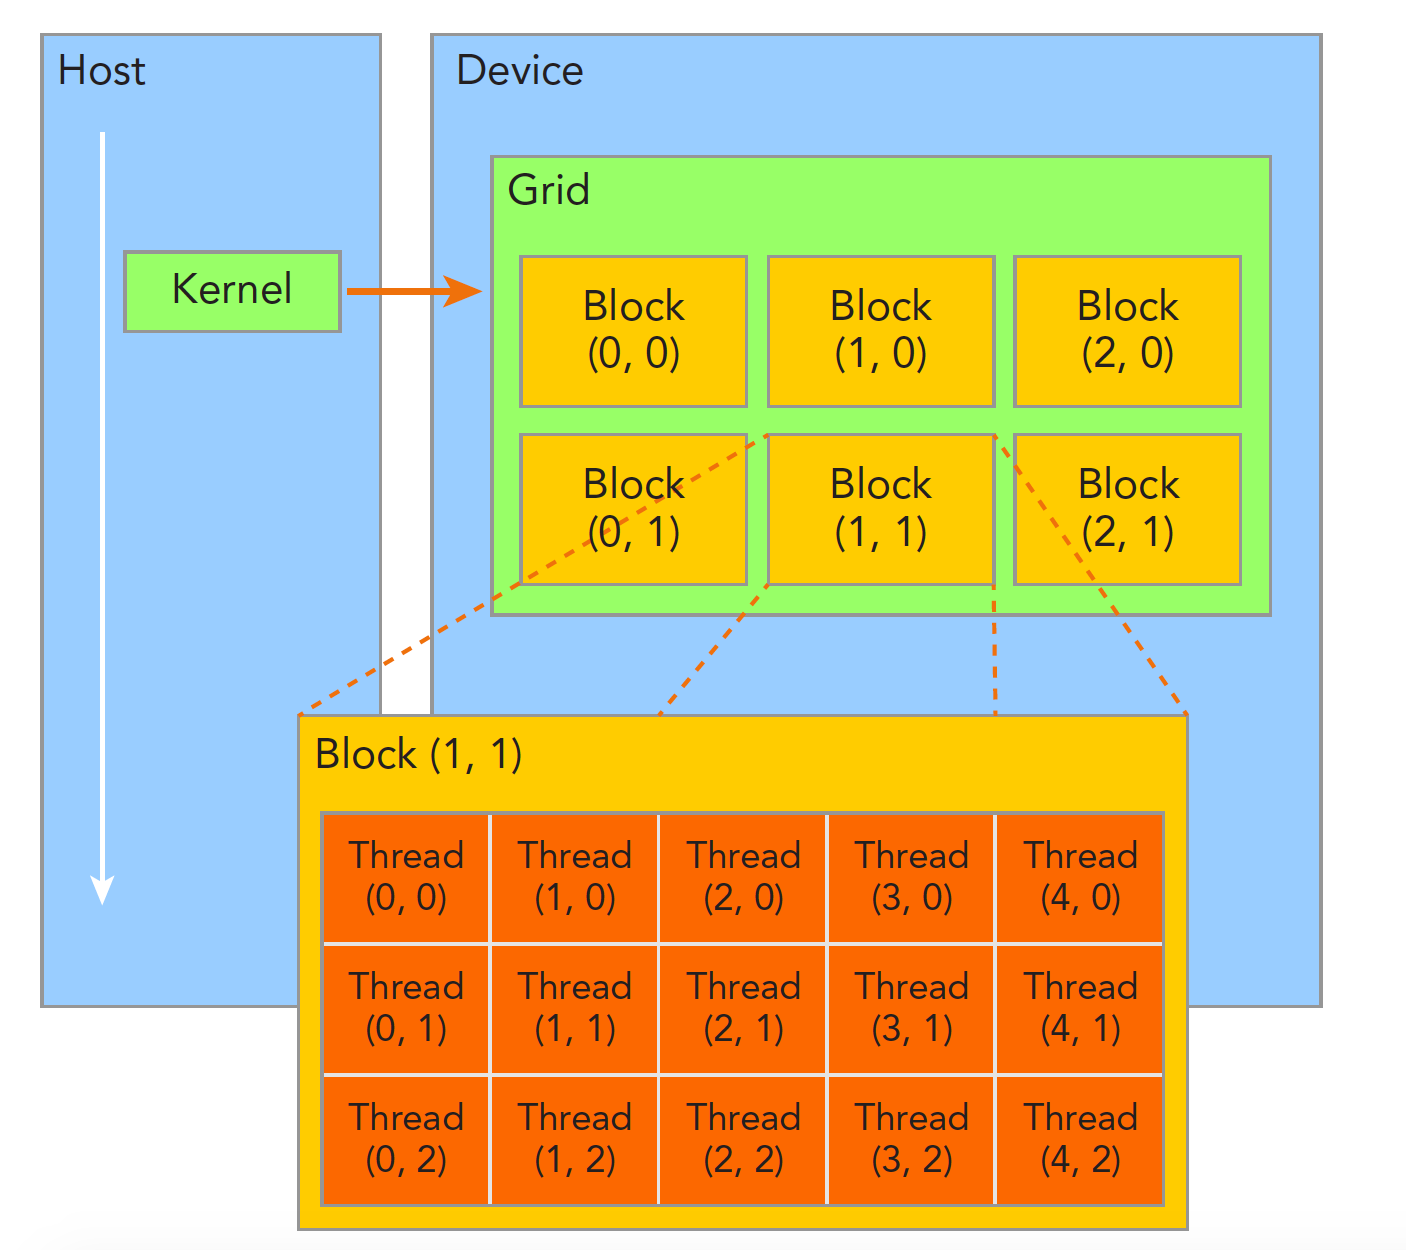
| 📊 层级 | 说明 | 硬件对应 |
|---|---|---|
| Grid | 一次 Kernel 启动的所有线程 | 整个 GPU |
| Block(线程块) | 一组协作的线程(最多 1024 个) | 调度到一个 SM |
| Thread(线程) | 最小执行单元 | CUDA Core |
| Warp(线程束) | 32 个连续线程(隐式分组) | SM 中的 Warp Scheduler |
5.2 一个简单的 CUDA Kernel 示例
下面是一个向量加法的 CUDA Kernel,展示 CUDA 的基本编程范式:
// 向量加法 Kernel:C[i] = A[i] + B[i]
__global__ void vecAdd(float *A, float *B, float *C, int N) {
    // 计算当前线程负责的全局索引
    int idx = blockIdx.x * blockDim.x + threadIdx.x;

    // 边界检查
    if (idx < N) {
        C[idx] = A[idx] + B[idx];
    }
}

// 主机端启动 Kernel
int main() {
    int N = 1000000;
    int threadsPerBlock = 256;
    int blocksPerGrid = (N + threadsPerBlock - 1) / threadsPerBlock;

    // <<<Grid 维度, Block 维度>>>
    vecAdd<<<blocksPerGrid, threadsPerBlock>>>(d_A, d_B, d_C, N);
    return 0;
}
执行流程:📥 Host 分配显存并拷贝数据 → ⚙️ 启动 Kernel,GPU 将 Block 分配到各 SM → 📤 Kernel 执行完毕,结果拷回 Host。
5.3 内存模型与存储对应
CUDA 编程中不同的变量声明对应不同的硬件存储:
| 📊 CUDA 内存类型 | 声明方式 | 硬件位置 | 作用域 | 生命周期 |
|---|---|---|---|---|
| Register | 局部变量 | SM 寄存器堆 | 单线程 | Kernel |
| Local Memory | 溢出的局部变量 | HBM(显存) | 单线程 | Kernel |
| Shared Memory | __shared__ | SM 片上存储 | Block 内 | Kernel |
| Global Memory | __device__ / cudaMalloc | HBM(显存) | 所有线程 | 应用 |
| Constant Memory | __constant__ | HBM + 缓存 | 所有线程 | 应用 |
⚠️ 注意:Local Memory 虽然名字里有”Local”,但实际存储在 HBM 上,访问速度和 Global Memory 一样慢。当寄存器不够用时,编译器会自动将变量溢出到 Local Memory,这叫做 Register Spilling,是需要警惕的性能问题。
5.4 用 PyTorch 感受 GPU 计算
大多数 AI Infra 工程师日常并不直接写 CUDA C,而是通过 PyTorch 等框架间接调用。理解底层 CUDA 有助于写出更高效的 PyTorch 代码:
import torch
import time

# 检查 GPU 信息
if torch.cuda.is_available():
    gpu = torch.cuda.get_device_properties(0)
    print(f"GPU: {gpu.name}")
    print(f"SM 数量: {gpu.multi_processor_count}")
    print(f"显存: {gpu.total_memory / 1024**3:.1f} GB")

# CPU vs GPU 矩阵乘法性能对比
N = 4096
A_cpu = torch.randn(N, N)
B_cpu = torch.randn(N, N)
A_gpu = A_cpu.cuda()
B_gpu = B_cpu.cuda()

# 预热
torch.mm(A_gpu, B_gpu)
torch.cuda.synchronize()

# 计时
start = time.perf_counter()
C_cpu = torch.mm(A_cpu, B_cpu)
cpu_time = time.perf_counter() - start

torch.cuda.synchronize()
start = time.perf_counter()
C_gpu = torch.mm(A_gpu, B_gpu)
torch.cuda.synchronize()
gpu_time = time.perf_counter() - start

print(f"CPU: {cpu_time*1000:.2f} ms | GPU: {gpu_time*1000:.2f} ms | 加速比: {cpu_time/gpu_time:.1f}x")
6. GPU 关键性能指标
评估一块 GPU 的 AI 计算能力,需要关注以下核心指标:
6.1 四大核心指标
| 📊 指标 | 含义 | 为什么重要 |
|---|---|---|
| 算力(TFLOPS) | 每秒浮点运算次数 | 决定 Compute-bound 任务的上限 |
| 显存带宽(GB/s) | 每秒显存读写数据量 | 决定 Memory-bound 任务的上限 |
| 显存容量(GB) | 可存储的数据总量 | 决定能跑多大的模型 |
| 互联带宽(GB/s) | GPU 间通信速度 | 决定多卡并行的扩展效率 |
6.2 算力计算公式
计算理论峰值前,必须明确 GPU 型号、执行路径、输入与累加精度、稠密或稀疏口径、时钟频率。单说“FP16 算力”不足以确定数值,CUDA Core 和 Tensor Core 的 FP16 吞吐量并不相同。
通用公式:计算单元数 × 每单元每周期运算量 × 每秒周期数。
- :该 GPU 实际启用的 SM 数量。
- :每个 SM 中所选类型的计算单元数。
- :指定精度与计算模式下,每个单元每周期可完成的浮点运算数,单位为 FLOPs/(单元·周期)。
- :与该吞吐规格匹配的核心时钟频率,单位为 Hz;结果为 FLOP/s,除以 得到 TFLOPS。这里不使用显存频率,也不能把不适用于该执行路径的最高频率直接代入。
CUDA Core:乘以 2 是 FMA 的计数约定。 一次标量 FMA()计作一次乘法加一次加法,即 2 FLOPs;它并不意味着所有计算单元每周期都只完成 2 FLOPs。若某 FP32 执行单元的峰值为每周期一次标量 FMA,则 ;换成 FP16、FP64 或其他指令时,应重新查该架构的吞吐规格。half2 一条指令可表达两个 FP16 元素的运算,但其每周期执行率仍取决于硬件,不能笼统地用“FP16 Core 数 × 2”推算。CUDA 编程指南:算术指令吞吐量
Tensor Core:必须计入每周期的多次乘加。 设 为单个 Tensor Core 每周期完成的标量 FMA 等价次数,则稠密峰值为:
这里的 是硬件的持续吞吐量,不能用一条 MMA 的 直接替代,也不能由单条指令的延迟简单取倒数得到;流水线允许多条独立操作重叠执行。若资料已给出 FLOPs/周期,则已经包含乘加的 ,不要重复乘。
计算实例:A100 的 FP16 输入、FP32 累加、稠密 Tensor Core 峰值。 NVIDIA 白皮书给出 A100 有 108 个 SM,每个 SM 有 4 个 Tensor Core;每个 Tensor Core 每周期完成 256 次 FP16 乘加,即 FLOPs。取规格表中的 1.41 GHz Boost 频率:
同一 A100 的常规 FP32 路径,每 SM 有 64 个 FP32 CUDA Core,按每单元每周期一次 FMA 计算并换算单位,得到 TFLOPS。两者说明了为何只数“核心数”或只看数据位宽无法比较算力。NVIDIA A100 架构白皮书,第 20、24 页及规格表
稀疏峰值与实测性能要分开。 A100 在满足 2:4 结构化稀疏要求并使用对应稀疏 Tensor Core 指令时,FP16 的稠密等价峰值可达约 624 TFLOPS,是上述稠密峰值的 2 倍。该数字按等价稠密矩阵的运算量计数;普通稠密矩阵或任意分布的零值不会自动获得这一倍增。阅读厂商规格时,应逐项确认是否标注“with sparsity”,不能默认所有 TFLOPS 都包含稀疏加速。NVIDIA Ampere 架构说明
实际吞吐量应按“完成的计算量 / 实测耗时”计算,例如稠密 GEMM 常按 估算,并与相同精度、执行路径和计数口径的峰值比较。矩阵形状、访存、指令混合、并行度及功耗/温度导致的频率变化都会影响利用率,不存在普遍适用的“峰值的 30%~60%”范围;GPU 计算为异步执行,计时还需正确同步或使用 CUDA Events。
7. 主流 AI GPU 横向对比
下面是截至 2025 年主流 NVIDIA AI GPU 的核心参数对比:
| 📊 型号 | 架构 | SM 数 | 显存 | 带宽 | FP16 算力 | FP8 算力 | TDP | 典型用途 |
|---|---|---|---|---|---|---|---|---|
| V100 | Volta | 80 | 32 GB HBM2 | 900 GB/s | 125 TFLOPS | — | 300W | 经典训练卡 |
| A100 SXM | Ampere | 108 | 80 GB HBM2e | 2,039 GB/s | 312 TFLOPS | — | 400W | 训练 + 推理 |
| H100 SXM | Hopper | 132 | 80 GB HBM3 | 3,350 GB/s | 989 TFLOPS | 1,979 TFLOPS | 700W | 大规模训练 |
| H200 | Hopper | 132 | 141 GB HBM3e | 4,800 GB/s | 989 TFLOPS | 1,979 TFLOPS | 700W | 长序列推理 |
| B200 | Blackwell | 160 | 192 GB HBM3e | 8,000 GB/s | 2,250 TFLOPS | 4,500 TFLOPS | 1000W | 下一代旗舰 |
| L40S | Ada | 142 | 48 GB GDDR6 | 864 GB/s | 366 TFLOPS | — | 350W | 推理 / 多媒体 |
⚠️ 注意:同一架构可能有 SXM 和 PCIe 两种封装。SXM 版本通常功耗更高、频率更高、且支持 NVLink 互联,性能显著强于 PCIe 版本。选型时务必确认封装类型。
8. 显存管理:AI Infra 的核心挑战
训练大模型时,显存往往是最先遇到的瓶颈。一个 7B 参数的模型(FP16),仅模型参数就需要约 14 GB 显存;加上优化器状态、梯度、激活值,实际显存占用可达 4~8 倍参数量。
8.1 训练时显存都用在哪里
以 Adam 优化器 + FP16 混合精度训练为例,每个参数需要的显存:
| 📊 组成部分 | 每参数字节 | 说明 |
|---|---|---|
| FP16 参数 | 2 B | 前向 / 反向计算使用 |
| FP32 参数副本 | 4 B | Adam 需要维护 FP32 master weights |
| FP32 梯度 | 4 B | 反向传播产生 |
| Adam 一阶动量(m) | 4 B | 梯度的指数移动平均 |
| Adam 二阶动量(v) | 4 B | 梯度平方的指数移动平均 |
| 合计 | 18 B | — |
一个 7B 模型的固定显存 = GB,这还不算激活值(Activation)。
8.2 常用显存优化策略
面对显存不够用的困境,AI Infra 领域发展出了一系列经典策略:
| 📊 策略 | 原理 | 显存节省 | 代价 |
|---|---|---|---|
| 混合精度训练 | 用 FP16/BF16 做前向反向,FP32 做参数更新 | ~50% 参数显存 | 需要 loss scaling(FP16) |
| 梯度累积 | 用多个 micro-batch 累积梯度,等效大 batch | 减少激活值峰值 | 增加训练步数 |
| 梯度检查点 | 前向时只保留部分激活,反向时重新计算 | 激活显存降至 | 增加约 33% 计算量 |
| ZeRO 优化 | 将优化器状态 / 梯度 / 参数分片到多卡 | 线性降低每卡显存 | 增加通信量 |
| Offloading | 将部分数据卸载到 CPU 内存或 NVMe | 突破单卡显存上限 | PCIe 带宽成为瓶颈 |
💡 提示:这些策略并非互斥,实践中通常组合使用。例如 DeepSpeed ZeRO Stage 2 + 混合精度 + 梯度检查点是训练中大模型(7B~70B)的常见配置。
9. 多卡互联:从单机到集群
当单卡显存和算力无法满足需求时,就需要多卡并行。GPU 之间的互联带宽和拓扑直接决定了并行训练的效率。
9.1 互联技术对比
| 📊 互联技术 | 带宽 | 场景 | 说明 |
|---|---|---|---|
| PCIe 5.0 | 128 GB/s(双向) | 跨卡(通用) | 普遍但带宽较低 |
| NVLink 4.0(Hopper) | 900 GB/s(全双工) | 机内 GPU 互联 | 专用高速互联,H100 使用 |
| NVLink 5.0(Blackwell) | 1,800 GB/s(全双工) | 机内 GPU 互联 | B200 使用 |
| NVSwitch | 连接所有 NVLink | 机内全互联 | 实现 All-to-All 全带宽通信 |
| InfiniBand NDR | 400 Gb/s(50 GB/s) | 跨机互联 | 大规模集群标配 |
9.2 典型多卡拓扑
以 DGX H100(8 卡)为例:
- 8 块 H100 通过 NVSwitch 实现全互联,任意两卡之间 900 GB/s
- 每台机器通过 8 张 ConnectX-7 InfiniBand 网卡与集群相连
- 机内通信 >> 机间通信,这个带宽差异直接影响并行策略的选择
📌 关键点:在设计分布式训练策略时,应该让通信量大的并行维度(如张量并行)放在高带宽的机内 NVLink 上,通信量相对较小的并行维度(如数据并行、流水线并行)放在机间 InfiniBand 上。
# 查看 GPU 拓扑信息
nvidia-smi topo -m

# 查看 NVLink 状态
nvidia-smi nvlink -s
📝 总结
本文从 CPU 与 GPU 的架构差异出发,逐步深入到 GPU 的内部结构,涵盖了以下核心知识点:
- 为什么选择 GPU:深度学习的矩阵运算天然适合 GPU 的大规模并行架构
- 硬件架构:GPC → TPC → SM → CUDA Core / Tensor Core 的层级组织,Warp 是执行的最小调度单位
- 显存层次:Register → Shared Memory → L1/L2 Cache → HBM 的金字塔结构,带宽往往比算力更先成为瓶颈
- Tensor Core:专为矩阵乘累加设计的加速单元,BF16/FP8 等低精度格式持续推动算力增长
- CUDA 编程模型:Grid → Block → Thread 的线程组织,以及存储类型与硬件的对应关系
- 性能评估:算力、带宽、显存容量、互联带宽四大核心指标
- 显存管理:混合精度、梯度累积、梯度检查点、ZeRO 等经典优化策略
- 多卡互联:NVLink、NVSwitch、InfiniBand 构成从机内到集群的通信基础
掌握这些基础知识后,你将具备阅读后续 CUDA 编程、分布式训练、推理优化等进阶文章的硬件认知基础。
🎯 自我检验清单
- 能说出 CPU 和 GPU 在架构设计哲学上的核心区别
- 能画出 GPU 的层级结构(GPC → SM → CUDA Core / Tensor Core)
- 能解释 Warp 的概念以及 Warp Divergence 为什么影响性能
- 能说出 GPU 存储层级(Register → Shared Memory → L2 → HBM)各自的容量和速度量级
- 能用 Roofline 模型判断一个算子是 Compute-bound 还是 Memory-bound
- 能解释 BF16 和 FP16 的区别,以及为什么大模型训练更推荐 BF16
- 能列举 3 种以上显存优化策略及其原理
- 能用
nvidia-smi查看 GPU 状态、拓扑信息 - 能说出 NVLink 和 PCIe 在带宽上的数量级差异
- 能估算一个 7B 参数模型使用 Adam + FP16 混合精度训练时的显存占用
📚 参考资料
- NVIDIA CUDA C++ Programming Guide
- NVIDIA H100 Tensor Core GPU Architecture Whitepaper
- NVIDIA A100 Tensor Core GPU Architecture Whitepaper
- NVIDIA Blackwell Architecture Whitepaper
- Mixed Precision Training - NVIDIA Developer Blog
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models
- Roofline: An Insightful Visual Performance Model