🔥 Kiến trúc Transformer: nhập môn nhanh
Nhìn toàn bộ Transformer từ góc AI Infra: Self-Attention, FFN, positional encoding, và ý nghĩa thực tế của từng module
Transformer là nền tảng chung của kỷ nguyên mô hình lớn. Lớp CUDA tối ưu toán tử của nó, lớp phân tán cắt tham số của nó, lớp suy luận tăng tốc việc sinh của nó. Bài này nhìn từ góc kỹ sư AI Infra: “đối tượng mà mọi tối ưu sau này đều nhắm vào” trông thế nào, vì sao trông vậy, và mỗi module sẽ được nhắc lại ở những tối ưu nào.
📑 Mục lục
- 1. Vì sao kỹ sư AI Infra cần hiểu Transformer
- 2. Toàn cảnh mạng Transformer
- 3. Self-Attention
- 4. Mạng feed-forward (FFN)
- 5. Positional encoding
- 6. LayerNorm và residual connection
- 7. Một Transformer Decoder Block đầy đủ
- 8. Từ Transformer đến LLM: sinh autoregressive
- Tóm tắt
- Danh sách tự kiểm
- Tài liệu tham khảo
1. Vì sao kỹ sư AI Infra cần hiểu Transformer
Nếu bạn đi sâu vào AI Infra — viết CUDA kernel, làm huấn luyện phân tán, hay triển khai suy luận — đối tượng chính của công việc vẫn là một thứ: mô hình Transformer.
Giống kỹ sư ô tô phải hiểu động cơ. Bạn không cần tự thiết kế động cơ (việc của nhà nghiên cứu), nhưng phải biết trục khuỷu ở đâu, piston chạy thế nào, đường dầu đi ra sao. Không thì làm sao biết tối ưu phần nào?
Cụ thể, mỗi lớp công việc AI Infra map thẳng vào một module Transformer:
| Lớp AI Infra | Việc cốt lõi | Module Transformer tương ứng |
|---|---|---|
| Tối ưu toán tử CUDA | FlashAttention, kernel GEMM hiệu quả | Nhân ma trận /PV trong Self-Attention |
| Tối ưu toán tử CUDA | Fused Softmax, Online Softmax | Softmax trong Attention |
| Tối ưu toán tử CUDA | Fusion kernel LayerNorm | Normalization trong mỗi Block |
| Huấn luyện phân tán | Tensor Parallelism | Cắt multi-head trong Attention, cắt ma trận trong FFN |
| Huấn luyện phân tán | Pipeline Parallelism | Xếp chồng nhiều Decoder Block |
| Huấn luyện phân tán | Tối ưu bộ nhớ ZeRO | Lưu trữ và giao tiếp mọi ma trận tham số |
| Triển khai suy luận | Quản lý KV Cache | Ma trận K và V trong Self-Attention |
| Triển khai suy luận | PagedAttention | Phân mảnh KV Cache trong bộ nhớ GPU |
| Triển khai suy luận | Lượng tử hóa (INT4/INT8/FP8) | Mọi ma trận trọng số và KV Cache |
Một dòng chốt: không hiểu Transformer thì không biết mình đang tối ưu cái gì. Mọi kỹ thuật tối ưu bạn gặp sau này đều truy được về một module cụ thể trong bài này.
2. Toàn cảnh mạng Transformer
Trước khi tháo từng module, hãy nhìn Transformer như một bản lắp ráp trước khi tháo động cơ: có những phần nào, chúng nối thế nào.
2.1 Transformer gốc: Encoder-Decoder
Transformer gốc trong paper 2017 “Attention Is All You Need” có hai phần chính:
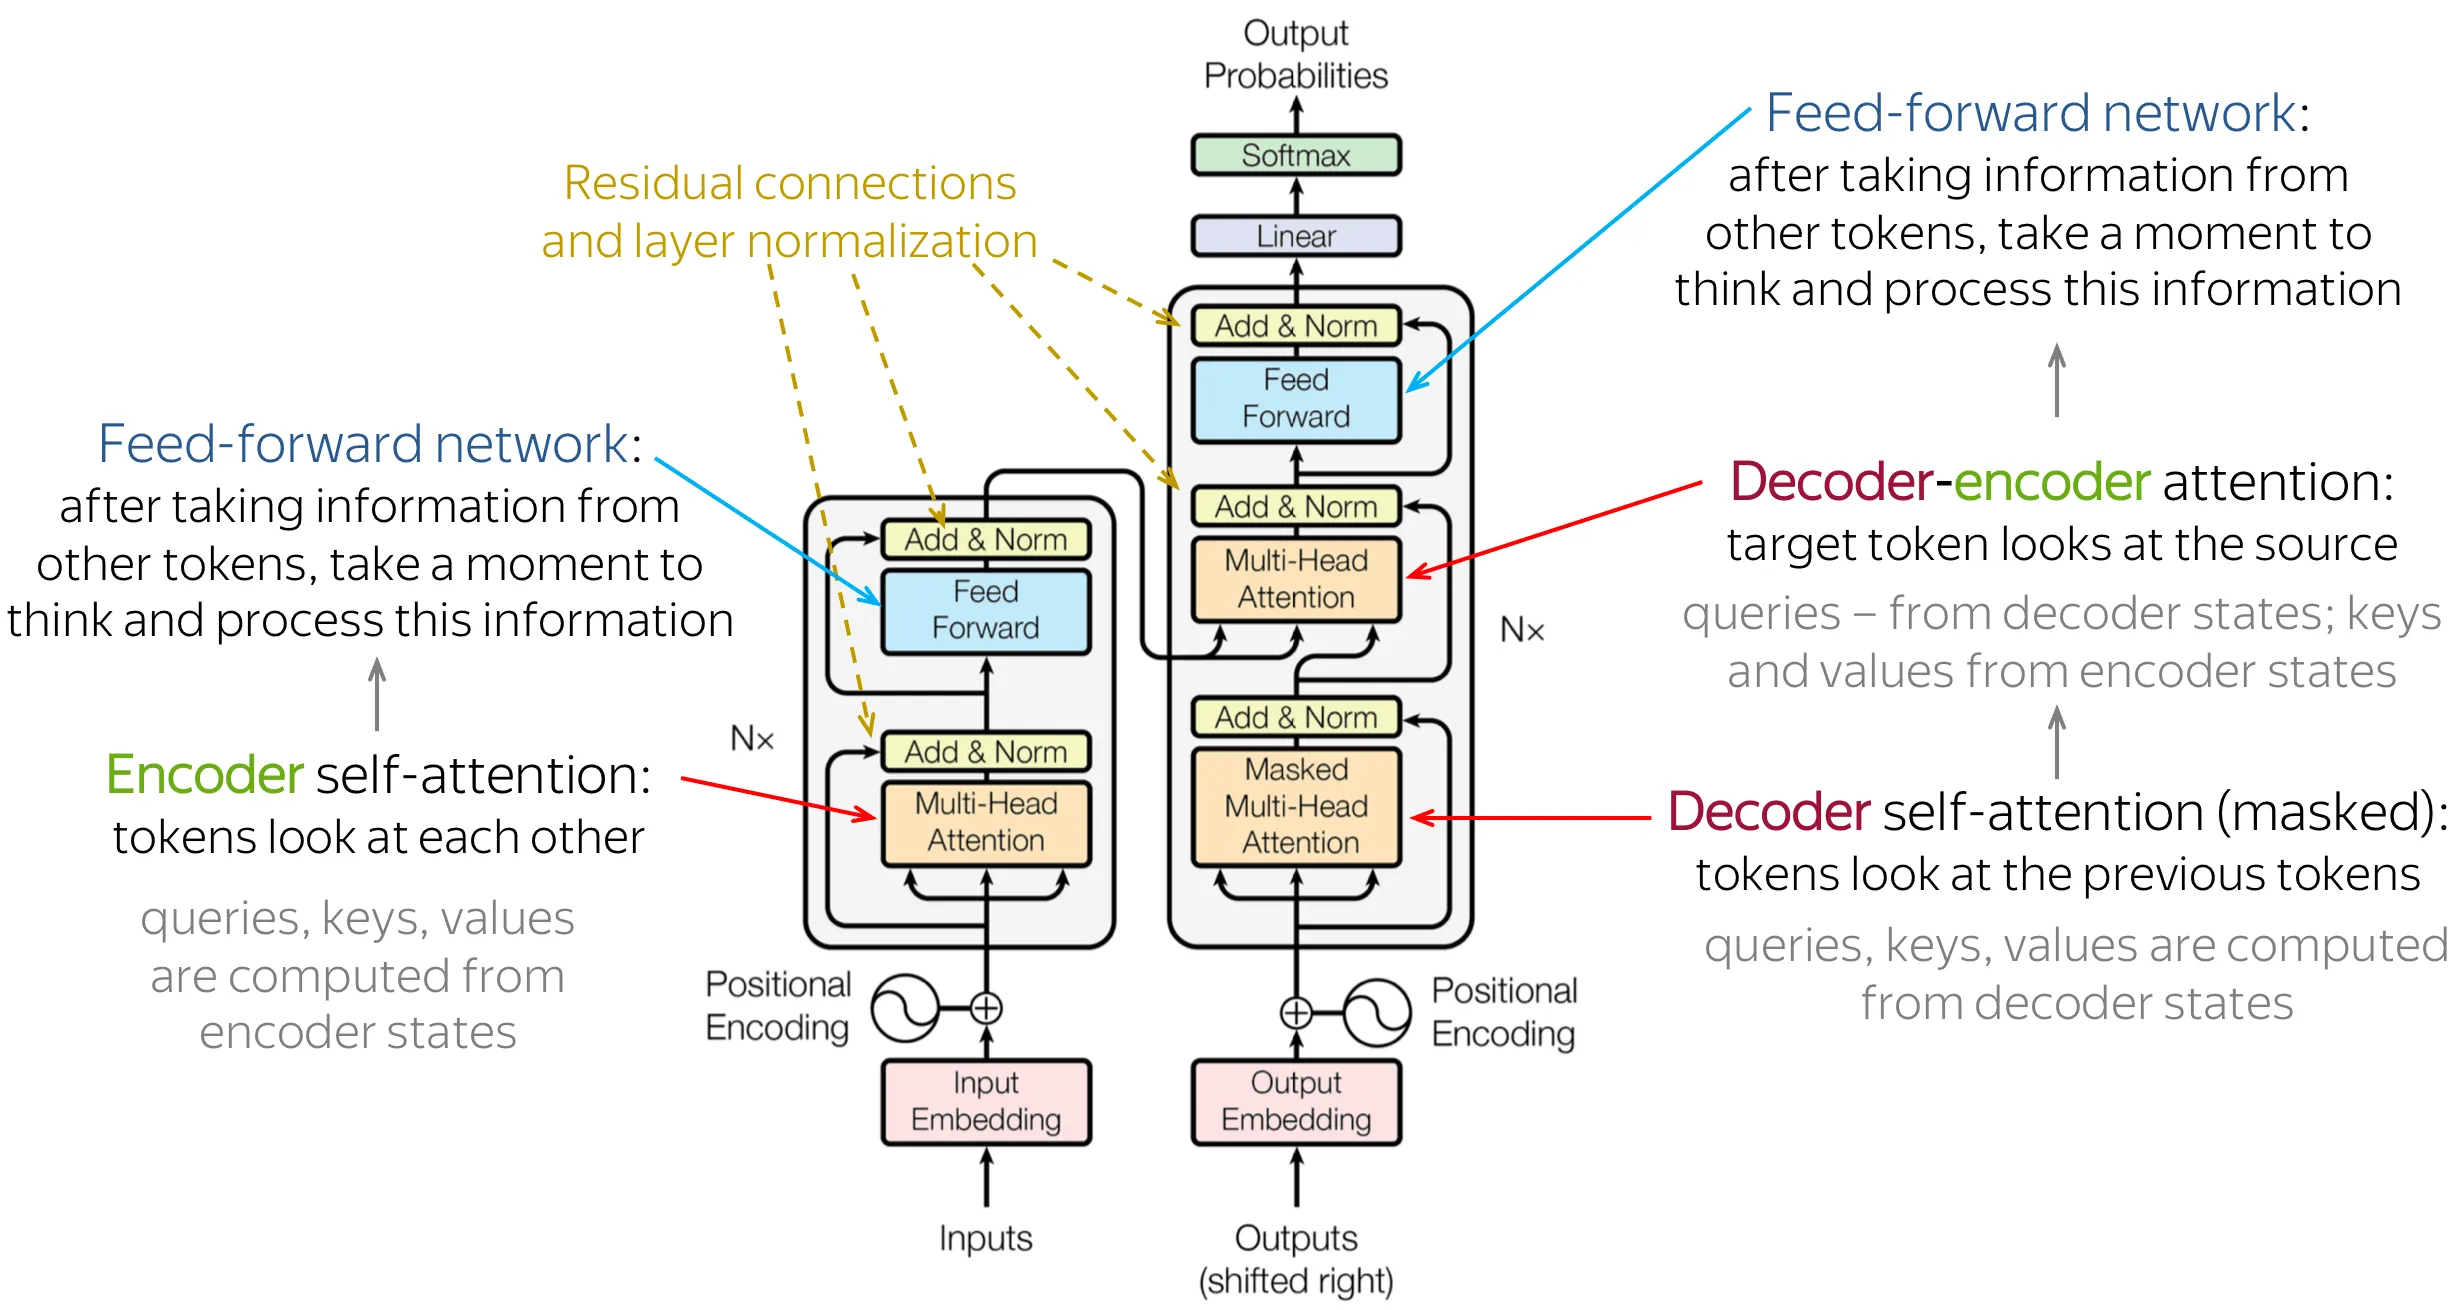
- Encoder: đọc chuỗi đầu vào và dựng biểu diễn ngữ cảnh. Mỗi lớp có một Self-Attention và một FFN; mọi token đều attend được mọi token khác (attention hai chiều)
- Decoder: sinh chuỗi đích theo kiểu autoregressive từ đầu ra Encoder. Mỗi lớp có Self-Attention bị mask nhân quả (chỉ token đã sinh), Cross-Attention (trên đầu ra Encoder), và một FFN
Thiết kế Encoder-Decoder này phục vụ dịch máy: Encoder hiểu ngôn ngữ nguồn, Decoder sinh ngôn ngữ đích.
2.2 Mô hình lớn ngày nay dùng gì: Decoder-only
Thành công của dòng GPT cho thấy một điểm hữu ích: chỉ cần Decoder là đủ. Hầu hết LLM mainstream hiện nay (GPT, LLaMA, Mistral, Qwen, DeepSeek) dùng kiến trúc Decoder-only. Encoder và Cross-Attention biến mất; còn lại Self-Attention bị mask nhân quả.
Cấu trúc tổng thể gồm ba giai đoạn: lớp đầu vào, chồng N Decoder Block, lớp đầu ra:
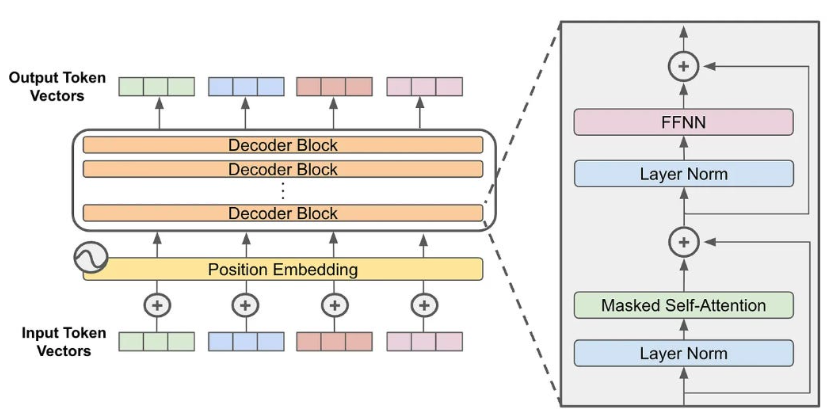
Lõi mô hình là chồng N Decoder Block ở giữa. Mỗi Block cùng cấu trúc và có hai submodule:
- Masked Self-Attention: mỗi token gom thông tin từ các token trước đó (mục 3)
- FFN: phép biến đổi phi tuyến áp riêng cho từng token (mục 4)
Mỗi submodule đi trước bởi LayerNorm (mục 6) và đi sau bởi residual connection cộng lại đầu vào submodule (mục 6). Thông tin vị trí được bơm qua RoPE trong lúc tính Attention (mục 5).
Bạn có thể thắc mắc vì sao Decoder block trong setup Decoder-only khác Decoder block trong Encoder-Decoder. Đó là khác biệt Pre-Norm vs Post-Norm sẽ nói sau.
2.3 Ba biến thể kiến trúc
| Kiến trúc | Mô hình đại diện | Pattern Attention | Dùng điển hình |
|---|---|---|---|
| Encoder-only | BERT, RoBERTa | Hai chiều (mọi token thấy mọi token) | Phân loại văn bản, NER, trích xuất thông tin |
| Encoder-Decoder | T5, BART, Transformer gốc | Encoder hai chiều + Decoder nhân quả + Cross-Attention | Dịch, tóm tắt, Seq2Seq |
| Decoder-only | GPT, LLaMA, Mistral, Qwen | Attention nhân quả (mỗi token chỉ thấy token trước) | Sinh văn bản, chat, sinh code |
Decoder-only trở thành lựa chọn mainstream của mô hình lớn vì hai lý do chính:
- Một mục tiêu huấn luyện duy nhất: mọi bài toán đều có thể đúc thành “đoán token tiếp theo”; không cần kiến trúc khác cho từng task
- Đơn giản về kỹ thuật: một hình dạng Block; quản lý KV Cache và chiến lược song song lúc suy luận cũng đơn giản hơn
Phần còn lại của bài này nói về kiến trúc Decoder-only, cấu trúc kỹ sư AI Infra gặp nhiều nhất.
3. Self-Attention
Self-Attention là lõi của Transformer, cũng là module ngốn nhiều compute và bộ nhớ nhất. Hầu hết tối ưu AI Infra nặng (FlashAttention, KV Cache, tensor parallelism) đều xoay quanh nó.
3.1 Trực giác: Attention làm gì
Bắt đầu từ một bài toán ngôn ngữ thực:
Câu A: The bank of the river. (bờ sông) Câu B: Money in the bank. (ngân hàng)
Cùng từ “bank” nhưng nghĩa khác nhau. Hệ dịch máy quyết định thế nào? Nó nhìn các từ khác: ở A, “river” được trọng số cao nhất; ở B, “money” được. Cơ chế để mỗi từ attend các từ khác rồi gom nghĩa theo trọng số liên quan chính là Self-Attention.
Nói thẳng: Attention để mọi từ trong câu “nhìn” mọi từ khác, rồi gom thông tin theo mức attention, để mỗi từ có nghĩa mới đã hòa ngữ cảnh.
Đẩy analog thêm bằng tìm kiếm. Khi tra “apple” trong bách khoa, bạn lập một query (Query): “quả táo là gì?”, quét tiêu đề (Key) từng trang để xem liên quan, rồi kết hợp nội dung (Value) các trang liên quan theo mức liên quan. Attention làm đúng vậy:
- Query (Q): thứ tôi muốn tra: thông tin từ hiện tại muốn lấy
- Key (K): mục lục / tiêu đề: cách mỗi từ tự trình bày để được khớp
- Value (V): nội dung thật được truyền đi khi khớp thành công
Trong Self-Attention, mọi token trong chuỗi đóng cả ba vai cùng lúc: hỏi (sinh Q), là mục lục bị truy vấn (sinh K), và cung cấp thông tin (sinh V). Khớp Q với K cho trọng số attention; tổng có trọng của V theo các trọng số đó gom thông tin.
💡 Mẹo: Làm rõ “bank” vs “bờ sông” thời RNN nghĩa là đẩy thông tin từ trước từng bước. Self-Attention để mọi từ so với mọi từ khác trong cùng một bước, nên phụ thuộc khoảng xa không còn phai đi.
3.2 Đường tính: từ đầu vào đến đầu ra
Giả sử chuỗi dài , mỗi token là vector chiều, vậy ma trận đầu vào có shape .
Bước 1: chiếu tuyến tính ra Q, K, V
Nhân X với ba ma trận trọng số để được Query, Key và Value:
Ở đây , , mỗi đầu ra là .
, và là ma trận tham số học được, mỗi cái shape . Ba phép nhân ma trận đó là ba op GEMM, và chúng nằm trong các mục tiêu chính của việc CUDA và tensor-parallel sau này.
Bước 2: điểm attention
Dùng tích trong của Q và K để đo mức khớp giữa từng cặp token:
là ma trận ; là mức token attend token (điểm thô).
Bước 3: scale
Chia điểm cho ( là chiều mỗi head; sẽ nói sau):
Vì sao scale? Khi lớn, tích trong Q·K trở nên lớn (bạn đang cộng hạng tử), nên đầu vào softmax lệch mạnh. Softmax rất nhạy với giá trị lớn: một khi khoảng cách tăng, đầu ra phân cực gần one-hot, gradient sụp về không, huấn luyện đứng. Chia kéo phương sai về gần 1 để softmax nằm trong vùng gradient lành hơn.
Bước 4: Softmax
Softmax từng hàng để điểm thô thành phân phối xác suất (mỗi hàng tổng bằng 1):
giờ là trọng số attention token gán cho token ; mỗi hàng tổng bằng 1.
Ghi chú AI Infra: Softmax trông đơn giản, nhưng trong setting hiệu năng cao cần tối ưu kỹ. Triển khai chuẩn quét mỗi hàng hai lần (một lần lấy max và tổng exp, một lần chuẩn hóa). Online Softmax gộp thành một lần quét, và FlashAttention dựng Attention đã fuse trên ý tưởng đó.
Bước 5: tổng có trọng
Nhân trọng số attention A với ma trận Value V:
Mỗi token kết thúc với vector chiều đã hòa thông tin từ các token mà nó “nên” attend.
Công thức đầy đủ (một dòng)
Bước 6: chiếu đầu ra
Cuối cùng nhân với chiếu đầu ra :
map kết quả multi-head đã concat về hidden size của mô hình (mục tiếp).
3.3 Vì sao độ phức tạp là
Bottleneck lộ thẳng từ các bước trên.
Bước then chốt là , shape , cho ma trận . Với bước đó:
- Compute: : phần tử, mỗi phần tử cần nhân-cộng
- Bộ nhớ: : phải lưu cả ma trận attention
Tương tự có shape và cũng tốn .
Vậy tổng độ phức tạp Self-Attention là , thường rút thành vì là hằng số mô hình cố định.
Điều đó nghĩa gì trên thực tế? Khi độ dài chuỗi tăng từ 2K lên 128K, compute và bộ nhớ ma trận attention tăng 4096×. Đó là lý do hỗ trợ ngữ cảnh dài khó.
Ghi chú AI Infra: Bottleneck bộ nhớ đó đúng là thứ FlashAttention được xây để xử lý. Đường chuẩn ghi cả ma trận attention ra HBM (bộ nhớ băng thông cao của GPU). FlashAttention dùng tiling cộng online softmax để mỗi bước chỉ tính một tile attention nhỏ trên SRAM on-chip rồi bỏ; ma trận đầy đủ không bao giờ quay lại HBM. Bộ nhớ phụ giảm từ xuống , và lưu lượng HBM giảm từ xuống ( là kích thước SRAM; nhỏ hơn nhiều so với ). Vẫn còn tăng theo , nhưng hằng số giảm mạnh. Compute không đổi; lưu lượng bộ nhớ giảm mạnh. Đó là ý tưởng cốt lõi của tối ưu memory-aware.
3.4 Multi-Head Attention: vì sao nhiều head
Mô tả trên là Attention một head. Transformer thật dùng Multi-Head Attention (MHA): cắt Q, K, V theo chiều feature thành nhiều “head”, chạy Attention độc lập từng head, rồi concat kết quả.
Nói thường: một head có thể theo một kiểu quan hệ (ví dụ phụ thuộc cú pháp); nhiều head theo nhiều quan hệ cùng lúc (cú pháp, ngữ nghĩa, vị trí, v.v.), giống vài người nhìn cùng bài toán từ góc khác rồi ghép lại.
Cụ thể, nếu hidden size mô hình là và số head là , mỗi head có chiều .
Định nghĩa toán (chiếu độc lập từng head): chặt chẽ, mỗi head có ma trận chiếu học được riêng , và tính:
Vì ma trận chiếu khác nhau theo head, 32 head học 32 không gian biểu diễn khác nhau từ cùng đầu vào . Chúng không chỉ là cắt một thành 32 mảnh. Đó là lý do thật multi-head bắt được nhiều pattern quan hệ.
Góc kỹ thuật (một GEMM lớn): trên thực tế, để GPU tính của mọi head trong một GEMM, 32 ma trận được concat theo cột thành một ma trận lớn:
Theo nhân ma trận theo khối, đúng bằng theo cột, nên một nhân lớn cộng một reshape bằng 32 chiếu độc lập:
Điểm then chốt: reshape không chỉ là cắt một thống nhất thành 32 lát. Nó bung kết quả của “32 chiếu head mà GEMM đã xếp cạnh nhau.” Toán nói 32 chiếu độc lập; kỹ thuật gộp chúng thành một GEMM. Hai góc nhìn tương đương.
Làm tương tự với K và V. Mỗi head tính Attention riêng:
Rồi concat 32 đầu ra head và chiếu:
Thành phần tham số của multi-head:
- : , tức tham số
- : , tham số
- : , tham số
- : , tham số
- Tổng: tham số
Ghi chú AI Infra: Cấu trúc multi-head khớp tự nhiên với tensor parallelism. 32 head có thể chia đều giữa các GPU: ví dụ 4 GPU mỗi cái lo 8 head, nên mỗi GPU chỉ cần 1/4 trọng số QKV và compute. Đó là ý tưởng cốt lõi của tensor parallelism trong Megatron-LM: cắt module Attention theo chiều head. Sau khi cắt chỉ cần một AllReduce để gom kết quả từng phần của mỗi GPU.
Biến thể bố trí head cũng quan trọng: MQA (Multi-Query Attention) chia sẻ một bộ KV cho mọi head, và GQA (Grouped-Query Attention) chia sẻ một bộ KV cho từng nhóm head. Cả hai đổi kích thước KV Cache và cách bạn cắt dưới tensor parallelism, và đều là ý tưởng trung tâm trong tối ưu suy luận.
4. Mạng feed-forward (FFN)
Attention lo “trao đổi thông tin”: các token truyền thông tin cho nhau. Chỉ trao đổi chưa đủ; mô hình còn cần xử lý sâu thông tin của từng token. Đó là việc của Feed-Forward Network (FFN).
Analog: Attention là bàn tròn mọi người trao ý; FFN là mỗi người về bàn riêng để tiêu hóa ý kiến và tự hình thành phán đoán. FFN áp phép biến đổi phi tuyến độc lập từng token, không tương tác giữa token.
4.1 Cấu trúc: hai lớp tuyến tính + một activation
FFN chuẩn đơn giản: mở rộng rồi nén, với activation phi tuyến ở giữa:
Trong đó:
- : , mở từ lên (thường )
- Activation: đưa vào phi tuyến
- : , nén từ về
Với ví dụ :
Lưu ý: mô hình thật như LLaMA dùng activation SwiGLU (nói bên dưới). Chiều trung gian là chứ không phải thuần, để tổng số tham số gần như không đổi sau khi thêm gate.
4.2 Số tham số: vì sao FFN chiếm phần lớn kích thước mô hình
Đếm cho một Transformer Block:
| Module | Ma trận tham số | Số tham số |
|---|---|---|
| Attention | ||
| FFN (chuẩn) | ||
| FFN (SwiGLU) |
Xấp xỉ, FFN có khoảng 2× tham số so với Attention. Trong một Transformer Block đầy đủ, FFN chiếm khoảng 2/3 tham số.
Tỷ lệ đó có hệ quả kỹ thuật trực tiếp:
Ghi chú AI Infra: Vì FFN giữ phần lớn tham số, cách bạn cắt nó dưới tensor parallelism quyết định chi phí giao tiếp. Megatron-LM cắt theo cột và theo hàng để kết quả trung gian không cần AllReduce, chỉ AllReduce một lần ở cuối. Cách cắt đó tận dụng hình dạng mở-rồi-nén của FFN. Trong mô hình Mixture-of-Experts (MoE), FFN còn bị cắt thành nhiều “expert”, thêm Expert Parallelism như một chiều song song nữa.
4.3 Tiến hóa activation: ReLU → GELU → SwiGLU
Activation trông như chi tiết nhỏ, nhưng lựa chọn ảnh hưởng ổn định huấn luyện và chất lượng cuối.
ReLU (Rectified Linear Unit)
Activation kinh điển: đơn giản và nhanh. Vấn đề: đầu vào âm thành đúng 0, nên neuron đó có thể “chết” vĩnh viễn và mất thông tin.
GELU (Gaussian Error Linear Unit)
với là CDF của phân phối chuẩn tắc.
Trực giác: GELU không hard on/off như ReLU. Nó cho “xác suất đi qua” mượt theo biên độ đầu vào: giá trị lớn dễ đi qua hơn, giá trị nhỏ dễ bị nén hơn, nhưng không về đúng không. Dòng GPT và BERT đều dùng GELU.
SwiGLU (Swish-Gated Linear Unit)
với , là sigmoid, và là nhân từng phần tử.
SwiGLU là lựa chọn mainstream trong mô hình lớn ngày nay (LLaMA, Mistral, và các model khác). Nó thêm cơ chế gating: một ma trận gate riêng điều khiển bao nhiêu thông tin đi qua, thay vì áp cùng activation cho mọi chiều. Giá là thêm một ma trận (FFN từ hai ma trận thành ba: , , ), nhưng thí nghiệm cho chất lượng tốt hơn.
Ghi chú AI Infra: Bố cục ba ma trận của SwiGLU (, , ) khác FFN chuẩn hai ma trận, nên fusion CUDA kernel và cắt tensor-parallel cần xử lý riêng. Ví dụ và có thể fuse thành một GEMM để tăng mức dùng GPU.
5. Positional encoding
5.1 Vì sao Transformer cần thông tin vị trí
Dễ bỏ qua mà vẫn rất quan trọng.
Nhìn lại Self-Attention: chấm điểm mọi cặp token, rồi các điểm đó trọng số hóa tổng trên V. Chú ý rằng quá trình hoàn toàn không quan tâm thứ tự token.
Thí nghiệm tư duy: xáo ba token trong “mèo đuổi chó” thành “chó mèo đuổi”. Chỉ cần giá trị Q, K, V giữ nguyên, kết quả Attention giống hệt. Về toán, Attention equivariant với hoán vị trên chuỗi đầu vào: bạn xáo đầu vào thế nào, đầu ra xáo tương ứng, và mỗi token vẫn gom cùng thông tin.
Ngôn ngữ rõ ràng có thứ tự. “Mèo đuổi chó” và “chó đuổi mèo” nghĩa khác nhau. Vì vậy phải bơm thông tin vị trí vào Transformer bằng cách nào đó.
5.2 Sinusoidal positional encoding: paper gốc
“Attention Is All You Need” đề xuất một scheme gọn: sinh vector encoding duy nhất cho mỗi vị trí bằng sine/cosine ở các tần số khác nhau, và cộng thẳng vào token embedding.
với là vị trí của token trong chuỗi (), và là chỉ số chiều.
Trực giác: mỗi chiều là một đồng hồ ở “tần số” khác nhau. Chiều tần thấp đổi chậm (tách vị trí xa); chiều tần cao đổi nhanh (tách vị trí gần). Giống mã hóa thời gian bằng năm-tháng-ngày-giờ-phút-giây: “năm” đổi chậm nhất nhưng tách khoảng lớn, “giây” đổi nhanh nhất nhưng chỉ tách khoảng nhỏ. Ghép lại, mọi vị trí có timestamp riêng.
Ưu:
- Không tham số học được; độ dài encoding về lý thuyết có thể kéo dài
- Vị trí tương đối có thể khôi phục qua biến đổi tuyến tính (công thức cộng sine/cosine)
Hạn:
- Vị trí bị “cộng” vào embedding, nên có thể bị pha loãng qua nhiều lớp sâu
- Khó ngoại suy tốt vượt độ dài thấy lúc huấn luyện
5.3 RoPE (rotary positional embedding): lựa chọn mainstream hiện nay
RoPE (Rotary Position Embedding) là scheme vị trí mà hầu hết mô hình lớn mainstream dùng (LLaMA, Mistral, Qwen, DeepSeek, và các model khác).
Ý tưởng cốt lõi: không bơm vị trí ở lớp embedding. Thay vào đó, khi tính Attention, mã hóa vị trí bằng cách xoay vector Q và K.
Cụ thể, coi mỗi hai chiều kề nhau của Q và K là tọa độ trên mặt phẳng 2D, rồi xoay vector 2D đó một góc phụ thuộc vị trí token:
với là tham số tần số tương tự scheme sinusoidal. K được xoay cùng cách.
Tính chất then chốt: sau xoay, tích trong Q·K chỉ phụ thuộc hiệu vị trí tương đối của hai token, không phụ thuộc vị trí tuyệt đối. Có thể chứng minh:
Vậy Attention tự nhiên mã hóa vị trí tương đối, khớp với hiểu ngôn ngữ (“quan hệ giữa từ 3 và từ 5” quan trọng hơn “vị trí tuyệt đối của từ 3 và từ 5”).
Vì sao RoPE thành mainstream:
- Positional encoding tương đối; xử lý đầu vào độ dài biến thiên một cách tự nhiên
- Không tham số thêm
- Tương thích với linear Attention và các biến thể liên quan
- Ngoại suy tốt hơn sinusoidal (với NTK-aware và các phương pháp nội suy khác bạn có thể kéo dài ngữ cảnh)
Ghi chú AI Infra: Phép xoay của RoPE (bản chất nhân-cộng từng phần tử) rẻ mỗi lần gọi nhưng gọi thường xuyên, nên thường được fuse vào kernel Attention thay vì launch kernel riêng. Trong setting ngữ cảnh dài, tinh chỉnh tham số tần số của RoPE (NTK-aware Scaling, YaRN, v.v.) ảnh hưởng trực tiếp độ dài chuỗi tối đa mô hình hỗ trợ, và gắn với quản lý KV Cache cùng lập kế hoạch bộ nhớ.
6. LayerNorm và residual connection
6.1 Residual connection: giữ đường gradient thông
Residual connection đến từ ResNet và cực kỳ đơn giản:
với SubLayer có thể là lớp Attention hoặc lớp FFN.
Trực giác: chỉ học phần delta trên thông tin gốc
Đọc residual như: đầu ra = thông tin gốc + thay đổi đã học. Ví dụ:
Giả sử = “con mèo nằm trên bàn”, và Attention học = “nhấn mạnh quan hệ giữa ‘mèo’ và ‘bàn’”. Khi đó:
nghĩa là: giữ câu gốc, và tăng cường quan hệ ngữ nghĩa.
Vì sao thiết kế vậy?
1️⃣ Sửa huấn luyện khó trong mạng sâu
Transformer thường có hàng chục lớp (LLaMA-2 có 32; GPT-4 được đồn hơn trăm). Không có residual, đường tín hiệu là . Lúc backprop gradient là chuỗi nhân dài và có thể teo về không (vanishing gradients), nên mạng sâu huấn luyện kém.
Có residual đường trở thành , và gradient có thể đi tắt:
Nhờ hạng đồng nhất , gradient không thành , huấn luyện ổn định hơn. Residual cho một “đường cao tốc”: gradient chảy thẳng về lớp nông theo đường residual, không bị biến đổi trung gian ảnh hưởng.
2️⃣ Làm map đồng nhất dễ học hơn
Lý tưởng, nếu một lớp không cần biến đổi, học là đủ và đầu ra là . Mạng có thể bỏ qua lớp không dùng mà không phải vật lộn học một phép biến đổi đồng nhất.
3️⃣ Thông tin không bị mất
Không residual, mỗi lớp “ghi đè” thông tin gốc. Có residual, thông tin gốc được giữ và truyền lớp này sang lớp khác. Điều đó rất quan trọng với NLP: nội dung ngữ nghĩa của token không được biến mất qua các phép biến đổi liên tiếp.
6.2 LayerNorm: chuẩn hóa giúp ổn định huấn luyện
LayerNorm (Layer Normalization) chuẩn hóa vector feature của mỗi token: trừ trung bình, chia độ lệch chuẩn, rồi khôi phục khả năng biểu diễn bằng scale và bias học được:
với và tính theo chiều feature (), và là hằng số nhỏ chống chia cho không (ví dụ ).
Trực giác: LayerNorm là bộ điều hòa tín hiệu: dù biên độ tuyệt đối đầu vào dao động thế nào, nó kéo tín hiệu về khoảng chuẩn để không chiều nào quá lớn hay quá nhỏ cho tính toán sau.
6.3 Pre-Norm vs Post-Norm
LayerNorm đặt trước hay sau sublayer trông như lựa chọn nhỏ nhưng ảnh hưởng lớn.
Post-Norm (paper gốc)
Làm sublayer và cộng residual trước, rồi mới chuẩn hóa.
Pre-Norm (mainstream trong mô hình lớn ngày nay)
Chuẩn hóa trước, rồi chạy sublayer, rồi cộng residual.
Khác biệt then chốt là đường residual có đi qua LayerNorm hay không:
- Trong Post-Norm, LayerNorm nằm trên đường residual, nên gradient backprop bị “điều chỉnh” bởi đạo hàm của LayerNorm
- Trong Pre-Norm, đường residual là passthrough sạch, nên gradient chảy ngược không bị mất
Vì sao mô hình lớn chủ yếu dùng Pre-Norm:
| Chiều | Post-Norm | Pre-Norm |
|---|---|---|
| Ổn định huấn luyện | Mô hình sâu dễ nổ gradient; cần warmup LR cẩn thận | Luồng gradient ổn định hơn; ít nhạy siêu tham số |
| Chất lượng cuối | Lý thuyết hơi tốt hơn (nếu huấn luyện ổn) | Hơi thấp hơn, nhưng khoảng cách nhỏ |
| Thân thiện kỹ thuật | Cần nhiều kinh nghiệm tinh chỉnh | ”Chạy được ngay”; tốt hơn cho huấn luyện quy mô lớn |
Trong kỹ thuật thực tế, một khi mô hình tới hàng tỷ tham số, ổn định huấn luyện quan trọng hơn nhiều so với khoảng cách chất lượng lý thuyết 0.x%. Một lần huấn luyện có thể tốn hàng triệu đô; mọi rủi ro loss nhảy hoặc phân kỳ đều không chấp nhận được. Vì vậy Pre-Norm thành mặc định.
Ghi chú AI Infra: LayerNorm không nặng về FLOPs, nhưng nặng đọc/ghi: hai lần quét toàn bộ vector feature (một lần mean/variance, một lần chuẩn hóa), truy cập HBM thường xuyên. Trong tối ưu CUDA, LayerNorm thường được fuse với op lân cận (ví dụ Residual Add + LayerNorm thành một kernel) để giảm lưu lượng HBM. Một số mô hình lớn còn dùng RMSNorm (bỏ trừ trung bình; chỉ chuẩn hóa theo phương sai) để đơn giản hóa phép tính thêm.
7. Một Transformer Decoder Block đầy đủ
Ta đã tháo Self-Attention, FFN, positional encoding, LayerNorm và residual. Giờ ghép lại và nhìn một Transformer Decoder Block hoàn chỉnh (xem hình trước).
7.1 Luồng dữ liệu
Lấy setup Pre-Norm Decoder-only mainstream, dữ liệu đi qua một Block như sau:
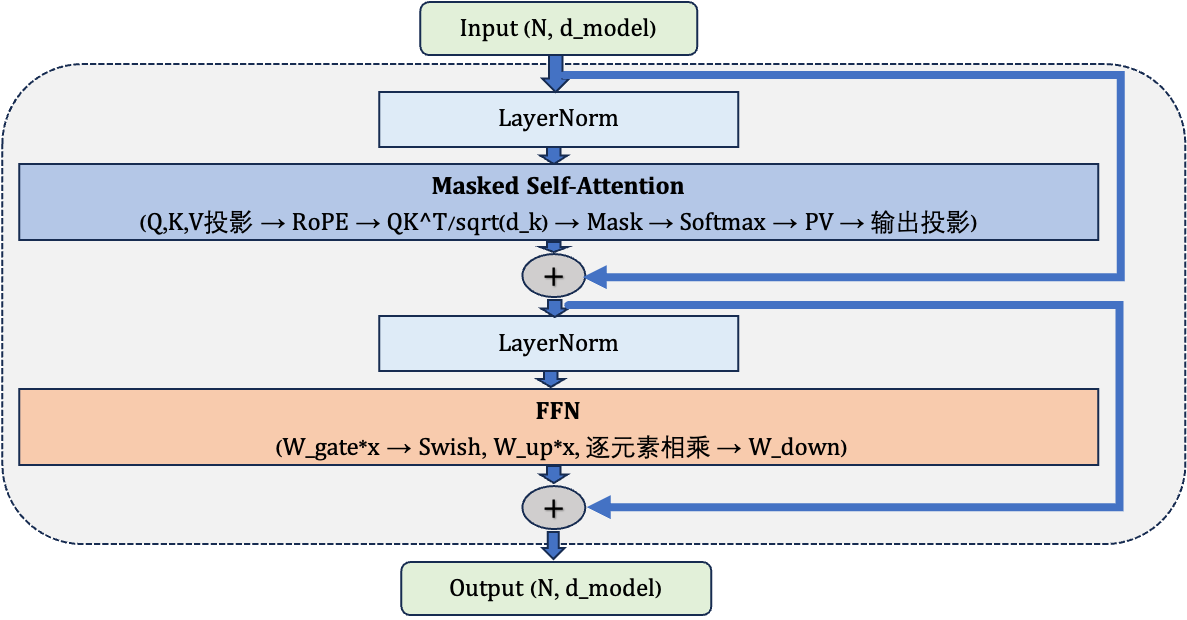
Chú ý Self-Attention Masked: trong Decoder, mỗi token chỉ được thấy chính nó và các token trước; không được nhìn trước. Việc đó làm bằng cách cộng một mask tam giác trên vào ma trận điểm attention: vị trí tương lai nhận , và sau softmax trọng số của chúng thành 0.
7.2 Theo dõi chiều
Theo dõi shape tensor với config của LLaMA-2-7B:
- hidden_dim () = 4096
- num_heads () = 32
- head_dim () = 4096 / 32 = 128
- ffn_intermediate_dim = 11008 (chiều trung gian SwiGLU)
- độ dài chuỗi = 2048 (ví dụ)
- batch_size = 1 (đơn giản hóa; bỏ chiều batch)
Input:                     (2048, 4096)

── LayerNorm ──
LayerNorm(Input):          (2048, 4096)       # shape unchanged

── Masked Self-Attention ──
Q = LN(x) * W_Q:          (2048, 4096) x (4096, 4096) = (2048, 4096)
  → reshape:              (2048, 32, 128)     # 32 heads, 128 dims each
K = LN(x) * W_K:          (2048, 4096) → (2048, 32, 128)
V = LN(x) * W_V:          (2048, 4096) → (2048, 32, 128)

Apply RoPE to Q, K:       shape unchanged; rotate each head's 128 dims

# Each head computes Attention independently (head_i as example):
S_i = Q_i * K_i^T:        (2048, 128) x (128, 2048) = (2048, 2048)
S_i = S_i / sqrt(128):    (2048, 2048)         # scale
S_i = S_i + mask:         (2048, 2048)         # causal mask
A_i = softmax(S_i):       (2048, 2048)         # each row sums to 1
O_i = A_i * V_i:          (2048, 2048) x (2048, 128) = (2048, 128)

# Concatenate 32 head outputs:
O = concat(O_1,...,O_32):  (2048, 4096)
Output = O * W_O:          (2048, 4096) x (4096, 4096) = (2048, 4096)

── Residual Add ──
h = Input + Output:        (2048, 4096)

── LayerNorm ──
LayerNorm(h):              (2048, 4096)

── FFN (SwiGLU) ──
gate = LN(h) * W_gate:    (2048, 4096) x (4096, 11008) = (2048, 11008)
up   = LN(h) * W_up:      (2048, 4096) x (4096, 11008) = (2048, 11008)
mid  = Swish(gate) * up:   (2048, 11008)       # element-wise multiply
down = mid * W_down:       (2048, 11008) x (11008, 4096) = (2048, 4096)

── Residual Add ──
Output = h + down:         (2048, 4096)
Từ đầu đến cuối shape dữ liệu giữ . Tính chất đó quan trọng: Block xếp như gạch; đầu ra một Block là đầu vào Block tiếp theo với chiều hoàn toàn tương thích.
7.3 Đếm tay tham số: tham số LLaMA-2-7B nằm đâu
Cho config:
- num_heads = 32, head_dim = 128
- ffn_intermediate_dim = 11008
- num_layers = 32
- vocab_size = 32000
Tham số trong một Decoder Block:
| Module | Ma trận tham số | Số tham số |
|---|---|---|
| Attention | 16,777,216 | |
| Attention | 16,777,216 | |
| Attention | 16,777,216 | |
| Attention | 16,777,216 | |
| FFN | 45,088,768 | |
| FFN | 45,088,768 | |
| FFN | 45,088,768 | |
| LayerNorm x 2 | mỗi cái 4096 | 16,384 |
| Tổng mỗi Block | ~201M |
Tham số cho cả mô hình:
| Thành phần | Cách tính | Số tham số |
|---|---|---|
| Token Embedding | vocab_size = | ~131M |
| 32 Decoder Block | ~6,432M | |
| LayerNorm cuối | ~8K | |
| Output head (LM Head) | vocab_size = | ~131M |
| Tổng | ~6,738M ≈ 6.7B |
Lưu ý: LLaMA-2 giữ trọng số Token Embedding và LM Head tách riêng (không weight tying), nên 6.7B đã gồm hai bản 131M. Nếu chia sẻ trọng số như GPT-2, bạn trừ một 131M và về gần 6.6B. Nhãn chính thức “7B” là làm tròn xấp xỉ.
Từ phân bổ tham số:
- FFN khoảng 67% (135M / 201M mỗi lớp)
- Attention khoảng 33% (67M / 201M mỗi lớp)
- Embedding chiếm phần nhỏ (131M / 6738M ≈ 2%)
Ghi chú AI Infra: Đếm tay được các tham số này là nền của lập kế hoạch bộ nhớ. Dưới huấn luyện mixed precision + Adam (cách đếm paper ZeRO, tổng 16Ψ Bytes/param):
- Trọng số FP16: 6.7B × 2 Bytes = ~13.4 GB
- Gradient FP16: 6.7B × 2 Bytes = ~13.4 GB
- Trạng thái Adam FP32 (trọng số master FP32 + moment thứ nhất m + moment thứ hai v, 12 Bytes/param): 6.7B × 12 Bytes = ~80.4 GB
- Tổng: 6.7B × 16 Bytes ≈ ~107 GB
Đó là vì sao một A100 80GB đơn không train nổi mô hình 7B: chỉ bộ nhớ tĩnh đã tràn, và với lưu Activation bạn gần như luôn cần ZeRO (cắt trạng thái optimizer / gradient / tham số) để hoàn tất huấn luyện.
8. Từ Transformer đến LLM: sinh autoregressive
Đến đây ta có cấu trúc nội bộ Transformer. Mô hình đã huấn luyện sinh văn bản thế nào? Mục này nói Transformer hoạt động lúc suy luận ra sao, gắn trực tiếp với tối ưu suy luận.
8.1 Sinh autoregressive: từng token một
Sinh văn bản của large language model (LLM) là autoregressive: mỗi bước, cho mọi token đến hiện tại, đoán token tiếp theo có khả năng cao nhất.
User input: "The core of AI"
Step 1: "The core of AI"  → model predicts next token → " is"
Step 2: "The core of AI is" → model predicts next token → " Transformer"
Step 3: "The core of AI is Transformer" → model predicts next token → " architecture"
...
until <EOS> or max length
Mỗi lần “đoán” là một forward pass đầy đủ của mọi token hiện tại qua Transformer. Đầu ra lớp cuối đi qua LM Head (lớp tuyến tính ) thành vector kích thước vocab, rồi softmax cho phân phối trên token, và bạn sample token tiếp theo.
Sinh từng token một có vấn đề hiệu năng nghiêm trọng: mỗi token mới tính lại K và V trong Attention cho mọi token lịch sử. Nếu độ dài chuỗi là , sinh token tốn tổng , vì Attention mỗi bước là và .
Điều đó dẫn tới tối ưu trung tâm trong suy luận LLM: KV Cache.
8.2 Prefill và Decode
Suy luận LLM thực ra có hai pha đặc tính rất khác nhau:
Prefill
Xử lý toàn bộ prompt của user. Mọi token đầu vào tính song song được; một forward pass sinh K và V cho mọi token rồi cache chúng.
Input: "Please explain what attention is" (assume 10 tokens)
→ 10 tokens enter the Transformer in parallel
→ each layer computes Q, K, V and caches K, V
→ one forward pass completes
→ emit the first generated token
Matmul của Prefill có chiều batch lớn ( token cùng lúc). Đó là workload Compute Bound kinh điển. Độ trễ của nó quyết định TTFT (Time To First Token).
Decode
Sinh token đầu ra từng cái một. Mỗi bước chỉ có Q của một token mới attend mọi K lịch sử; K và V của token mới được append vào cache.
Step 1: 1 new token's Q × 10 historical K → Attention → emit "at"
Step 2: 1 new token's Q × 11 historical K → Attention → emit "ten"
...
Decode mỗi bước chỉ có compute của một token. Matmul co thành nhân ma trận-vector; compute của GPU hầu như ngồi không, và phần lớn thời gian dành để chuyển dữ liệu KV Cache từ HBM. Đó là workload Memory Bound kinh điển. Độ trễ của nó quyết định TPOT (Time Per Output Token).
Ghi chú AI Infra: Prefill là Compute Bound và Decode là Memory Bound. Hai pha có bottleneck ngược nhau, dẫn tới thiết kế hệ thống tách Prefill/Decode (DistServe, Splitwise, và các hệ khác) đặt hai loại request lên các pool GPU khác nhau và tối ưu riêng từng bên.
8.3 KV Cache đến từ đâu
Ý tưởng KV Cache đơn giản: K và V đã tính rồi không cần tính lại.
Trong Decode, mỗi token mới cần Q của token đó chấm với K của mọi token lịch sử. Không có cache, mỗi bước chạy lại chiếu QKV trên mọi token lịch sử. Những chiếu đó đã làm ở bước trước; tính lại là lãng phí thuần.
KV Cache lưu K và V của mỗi lớp từ mỗi bước trong bộ nhớ GPU. Lúc Decode token mới chỉ tính Q, K, V của chính nó; K và V mới được append vào cache; Attention dùng toàn bộ K và V đã cache.
Không KV Cache (tính lại mọi KV mỗi bước): Bước tính lại QKV cho cả token, chi phí ; tổng .
Có KV Cache (chỉ KV của token mới): Bước tính QKV cho 1 token mới (), và Attention chấm 1 Q với K đã cache (); tổng .
KV Cache kéo tổng chi phí chiếu QKV từ xuống , với giá là bộ nhớ thêm cho K và V của mọi lớp và mọi token.
Chi phí bộ nhớ KV Cache:
Với LLaMA-2-7B:
- Mỗi token bạn cache: 2 (K và V) × 32 (lớp) × 32 (head) × 128 (head_dim) = 262,144 phần tử
- Ở FP16, 2 Bytes mỗi phần tử → KV Cache mỗi token = 512 KB
- Độ dài chuỗi 4096 → KV Cache mỗi request = 4096 × 512 KB = 2 GB
- batch_size = 16 → tổng KV Cache = 16 × 2 GB = 32 GB
32 GB KV Cache đã chiếm 40% một GPU 80 GB, cộng 13.4 GB trọng số mô hình, nên gần như không còn chỗ cho overhead khác. Đó là vì sao quản lý KV Cache là chủ đề trung tâm trong tối ưu suy luận. Các kỹ thuật như PagedAttention (phân trang kiểu bộ nhớ ảo), lượng tử hóa KV Cache (lưu ở độ chính xác thấp hơn), và GQA (ít head KV hơn) đều tấn công “kẻ sát nhân bộ nhớ” này.
Ghi chú AI Infra: KV Cache là tài nguyên cần quản lý cẩn thận nhất trong triển khai suy luận. Các bài toán kỹ thuật nó tạo ra gồm phân mảnh bộ nhớ (request khác nhau có độ dài chuỗi khác nhau, nên kích thước KV Cache khác nhau), tăng trưởng động (KV Cache cứ lớn dần trong Decode), và chia sẻ giữa nhiều request (Prefix Cache khi system prompt trùng). Đổi mới cốt lõi trong các engine như PagedAttention của vLLM và RadixAttention của SGLang, về gốc, là quản lý KV Cache hiệu quả hơn.
📝 Tóm tắt
Đây lại là cấu trúc Transformer Decoder Block đầy đủ, cộng cách mỗi module gắn với chủ đề AI Infra sau này:
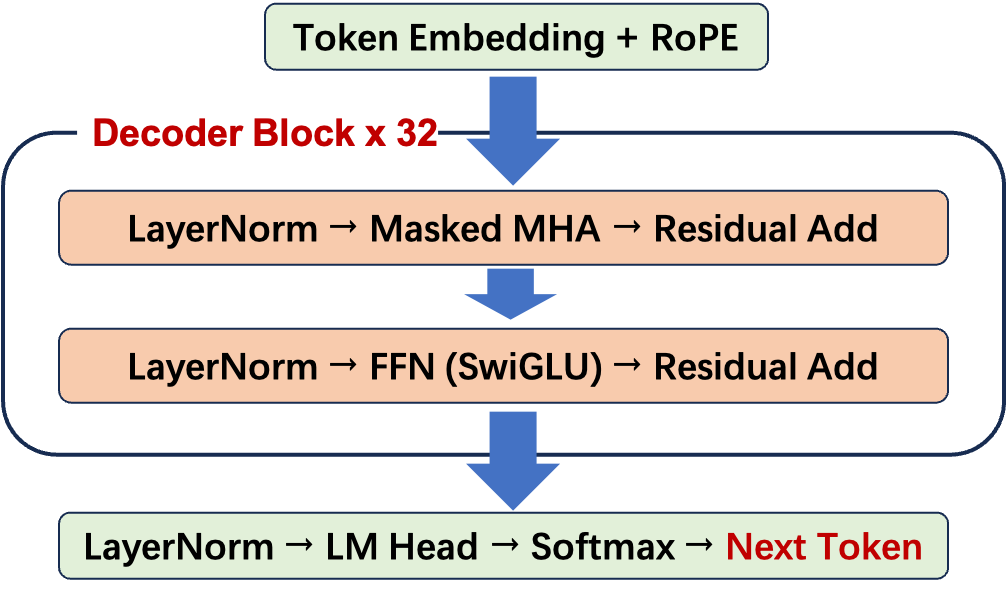
| Module | Phép tính cốt lõi | Liên kết AI Infra sau này |
|---|---|---|
| Self-Attention | , Softmax, PV | FlashAttention (CUDA), KV Cache (suy luận), tensor parallel theo head |
| Multi-Head | Head độc lập rồi concat | Điểm cắt tensor parallel (TP), GQA/MQA (suy luận) |
| FFN (SwiGLU) | Ba matmul lớn | Phần lớn tham số, điểm cắt TP khác, expert parallel MoE |
| LayerNorm | Chuẩn hóa mean/variance | Kernel fusion, đơn giản hóa RMSNorm |
| Residual | Cộng từng phần tử | Fuse với LayerNorm, phân tích luồng gradient |
| Positional encoding (RoPE) | Xoay Q/K | Fuse vào kernel Attention, mở rộng ngữ cảnh dài |
| KV Cache | Cache K, V lịch sử | PagedAttention, lượng tử hóa KV, Prefix Cache |
| Sinh autoregressive | Prefill + Decode | Tách Prefill/Decode, Speculative Decoding |
Học kiến trúc Transformer không phải đích cuối; đó là điểm xuất phát. Một khi bạn biết đối tượng tối ưu trông thế nào, các kỹ thuật AI Infra sau này không còn lơ lửng. FlashAttention tấn công vấn đề bộ nhớ ở mục 3.3, tensor parallelism cắt bố cục multi-head ở 3.4 và ma trận FFN ở 4.2, và quản lý KV Cache xử lý chi phí bộ nhớ ở 8.3.
🎯 Danh sách tự kiểm
Sau khi đọc bài này, kiểm xem bạn thật sự hiểu kiến trúc Transformer chưa:
- Không nhìn ghi chú, vẽ một Decoder Block đầy đủ trên bảng (Masked Self-Attention → Add & Norm → FFN → Add & Norm) và ghi chiều đầu vào/đầu ra mỗi bước
- Giải thích khác biệt giữa Encoder-Decoder, Encoder-only và Decoder-only, và vì sao mô hình lớn chủ yếu dùng Decoder-only
- Giải thích Q, K và V mỗi cái nghĩa gì, và ý nghĩa vật lý của mọi phần tử trong ma trận điểm attention
- Viết thuộc công thức Attention đầy đủ , và giải thích vì sao chia
- Suy ra độ phức tạp của Self-Attention, và giải thích điều đó dẫn tới FlashAttention thế nào
- Giải thích vì sao Multi-Head Attention khớp với cắt tensor-parallel, và GQA cải thiện MHA cho KV Cache thế nào
- Đếm tay tổng tham số LLaMA-2-7B (sai số trong 20%), và nêu tỷ lệ tham số FFN vs Attention
- Giải thích Prefill và Decode khác nhau thế nào về tính chất compute (Compute Bound vs Memory Bound), và KV Cache đến từ đâu
- Ước lượng bộ nhớ KV Cache cho một config cho trước (ví dụ mô hình 7B, độ dài chuỗi 4096, batch_size=16 ≈ 32 GB)
📚 Tài liệu tham khảo
Papers
- Attention Is All You Need (Vaswani et al., 2017): https://arxiv.org/abs/1706.03762 — paper Transformer gốc; bắt buộc đọc
- RoFormer: Enhanced Transformer with Rotary Position Embedding (Su et al., 2021): https://arxiv.org/abs/2104.09864 — positional encoding xoay RoPE
- GLU Variants Improve Transformer (Shazeer, 2020): https://arxiv.org/abs/2002.05202 — SwiGLU và các activation có cổng khác
- LLaMA: Open and Efficient Foundation Language Models (Touvron et al., 2023): https://arxiv.org/abs/2302.13971 — kiến trúc mô hình LLaMA
- LLaMA 2: Open Foundation and Fine-Tuned Chat Models (Touvron et al., 2023): https://arxiv.org/abs/2307.09288 — báo cáo kỹ thuật LLaMA-2
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness (Dao et al., 2022): https://arxiv.org/abs/2205.14135 — tối ưu Attention memory-aware
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints (Ainslie et al., 2023): https://arxiv.org/abs/2305.13245 — Grouped-Query Attention
Tutorials và blog
- The Illustrated Transformer (Jay Alammar): https://jalammar.github.io/illustrated-transformer/ — giới thiệu Transformer có minh họa
- Andrej Karpathy: Let’s build GPT from scratch: https://www.youtube.com/watch?v=kCc8FmEb1nY — viết GPT từ đầu; nhìn từng module ở mức code
- 3Blue1Brown: But what is a GPT: https://www.youtube.com/watch?v=wjZofJX0v4M — góc nhìn trực giác về Transformer
- The Annotated Transformer (Harvard NLP): https://nlp.seas.harvard.edu/annotated-transformer/ — paper từng dòng kèm PyTorch