7.1 Giới thiệu framework lập trình Triton
Bài này giới thiệu mô hình lập trình Block-level của Triton và đi qua cú pháp Triton cơ bản qua toán tử Fused Softmax chính thức
Bài này dùng hiện thực Fused Softmax chính thức để giới thiệu mô hình lập trình và cú pháp cơ bản của Triton. Khác với CUDA, nơi bạn thường viết logic tính toán theo góc nhìn của từng thread, Triton để bạn mô tả các thao tác load, compute và store theo tile (khối dữ liệu), còn phần lớn chi tiết ở mức thread và warp thì để compiler lo.
Softmax là toán tử phổ biến trong deep learning và large model, có hiện thực trong các framework như PyTorch và TensorFlow. Ở đây ta hiện thực Softmax theo hàng bằng Triton, rồi so với naive_softmax ghép từ nhiều thao tác PyTorch và với torch.sofrmax gốc, để xem fusion toán tử giảm bao nhiêu traffic bộ nhớ của tensor trung gian và overhead khởi chạy kernel.
📑 Mục lục
- 1. Mô hình lập trình Triton
- 2. Hiện thực Torch Softmax
- 3. Cú pháp Triton cơ bản
- 4. Hiện thực Triton Softmax
- 5. So sánh hiệu năng
- Tóm tắt
- Checklist tự kiểm
- Tài liệu tham khảo
1-Mô hình lập trình Triton
Trước khi nói về mô hình lập trình Triton, hãy nhớ lại cách ta từng viết toán tử CUDA.
Lấy Softmax làm ví dụ: ta thường viết logic tính từ góc nhìn của một thread, như đoạn reduce warp-sum dưới đây:
// Sum reduce trong một warp
__device__ __forceinline__ float warpReduceSum(float val){
    for(int i = 1 ; i < 32 ; i <<= 1)
        val += __shfl_xor_sync(0xffffffff, val ,i) ;
    return val ;
}

__device__ __forceinline__ float blockReduceSum(float val){
    __shared__ float smem[32] ;

    int lane_ID = threadIdx.x % 32 ;
    int warp_ID = threadIdx.x / 32 ;

    val = warpReduceSum(val) ;
    if(lane_ID == 0) smem[warp_ID] = val ;
    __syncthreads() ;

    val = (lane_ID < blockDim.x / 32) ? smem[lane_ID] : 0.0f ;
    if(warp_ID == 0) val = warpReduceSum(val) ;

    __shared__ float block_res ;
    if(threadIdx.x == 0) block_res = val ;
    __syncthreads() ;
    return block_res ;
}
Mỗi thread trước hết hoàn tất reduce trong warp bằng shuffle, rồi từng warp ghi kết quả cục bộ vào shared memory, và warp đầu tiên hoàn tất reduce cấp block. Bạn phải tự xử lý giao tiếp giữa các thread, shared memory và đồng bộ. Phong cách CUDA đó giúp kiểm soát bộ nhớ và dữ liệu rất tinh, nhưng cũng làm hiện thực và debug khó hơn. Triton gánh bớt phần việc lằng nhằng đó và để compiler lo phần lớn chi tiết hiện thực.
Triton do Philippe Tillet, H. T. Kung và David Cox đề xuất lần đầu năm 2019, nhằm cung cấp cách lập trình GPU cho toán tử deep learning ở mức cao hơn CUDA mà vẫn giữ hiệu năng tốt. Năm 2021, OpenAI phát hành Triton 1.0 dựa trên Python và tiếp tục đẩy mạnh phát triển.
Khác với mô hình SIMT của CUDA lấy thread và warp làm trung tâm, Triton dùng mô hình lập trình xoay quanh tile (khối dữ liệu). Bạn chủ yếu mô tả khối dữ liệu mà một Triton program instance cần xử lý, cùng các thao tác load, compute và store trên khối đó, mà không còn quản lý tường minh hành vi của từng CUDA thread. Sau đó compiler ánh xạ các thao tác cấp khối sang thread và warp cụ thể, rồi tối ưu coalesced memory access, phân bổ shared memory, đồng bộ thread cần thiết và tổ chức lệnh theo pattern truy cập. SM nào chạy block nào, và khi nào phát lệnh của một warp, vẫn do bộ lập lịch phần cứng GPU quyết định. Compiler cũng không đảm bảo mọi pattern truy cập đều coalesce tốt.
Mục tiêu của Triton không phải che hoàn toàn tính song song GPU, mà là đưa một lớp trừu tượng phù hợp hơn giữa biểu diễn thuật toán và phần cứng: bạn vẫn phải chọn cách chia khối cho toán tử, program grid và cấu trúc thuật toán tổng thể, nhưng có thể giao phần lớn chi tiết hiện thực cấp thread cho compiler. Như vậy vừa giảm độ khó khi viết và debug toán tử GPU tùy chỉnh, vừa cố gắng giữ hiệu năng gần với CUDA viết tay.
2-Hiện thực toán tử Torch Softmax
Xét ma trận đầu vào , trong đó và lần lượt là số hàng và số cột. Softmax được tính trên từng hàng:
Ở đây là phần tử hàng , cột , còn là chỉ số độc lập dùng cho tổng ở mẫu số. Khi tính thực tế, trước hết trừ đi max của mỗi hàng , được dạng ổn định số hơn và tương đương về mặt toán:
naive_softmax dưới đây dùng bước ổn định đó:
import torch

def naive_softmax(x) :

    x_max = x.max(dim=1)[0]

    z = x - x_max[:, None]

    numerator = torch.exp(z)

    denominator = numerator.sum(dim=1)

    ret = numerator / denominator[:, None]

    return ret

M, N = 10, 10
x = torch.rand(size=(M, N,), dtype=torch.float32, device='cuda')
y_torch = naive_softmax(x)
3-Cú pháp Triton cơ bản
Hầu hết thao tác trong Triton kernel không chỉ xử lý một scalar mà là cả một khối dữ liệu. Khi đọc code Triton, có thể phân tích theo thứ tự sau:
- Dùng tl.program_id để xác định vùng dữ liệu mà program hiện tại phụ trách;
- Dùng tl.arange để tạo offset phần tử bên trong một khối dữ liệu;
- Qua phép toán con trỏ để được một tập địa chỉ bộ nhớ;
- Dùng tl.load để nạp dữ liệu thành tensor Triton;
- Thực hiện phép toán từng phần tử, reduce hoặc nhân ma trận trên tensor;
- Dùng tl.store để ghi kết quả về bộ nhớ thiết bị.
Lưu ý quan trọng: trong Triton kernel không dùng được cấu trúc dữ liệu Python gốc (như list, dict, …) hay thao tác PyTorch (như torch.max, torch.relu, …) . Các phần dưới đây giới thiệu một số cú pháp cơ bản thường dùng trong Triton kernel:
tl.program_id
tl.program_id trả về chỉ số của program instance hiện tại trên một trục của launch grid, vai trò tương tự blockIdx trong CUDA:
# Launch grid của Triton tối đa ba chiều, nên axis nhận 0, 1 hoặc 2
# Tương tự blockIdx.x / blockIdx.y / blockIdx.z của CUDA
pid = tl.program_id(axis=0)
tl.num_programs
tl.num_programs(axis) trả về số program trên trục đó của launch grid, tương tự gridDim của CUDA:
# Tương tự, axis nhận 0, 1 hoặc 2
# Khớp với gridDim.x / gridDim.y / gridDim.z của CUDA
num_programs = tl.num_programs(axis=0)
tl.arange
tl.arange(start, end) dùng để tạo chỉ số logic liên tiếp:
offsets = tl.arange(0, BLOCK_SIZE)
BLOCK_SIZE thường là lũy thừa của 2 được truyền vào qua tl.constexpr.
tl.range
tl.range dùng tương tự iterator range của Python gốc, thường gặp trong vòng lặp:
@triton.jit
def kernel(M, num_stages):
    for idx in tl.range(0, M, num_stages=num_stages) :
        ...
Tham số num_stages là độ sâu software pipeline; xem ví dụ cụ thể ở phần hiện thực Triton Softmax sau.
tl.load
tl.load đọc dữ liệu từ bộ nhớ thiết bị theo một con trỏ hoặc một tập con trỏ:
values = tl.load(ptrs)
Nếu ptrs là tensor con trỏ hình dạng [BLOCK_SIZE], values trả về cũng cùng hình dạng.
Với vị trí có thể vượt biên, dùng mask để che:
values = tl.load(
    ptrs,
    mask=offsets < n_elements,
    other=0.0,
)
Ở vị trí mask=False, code không truy cập bộ nhớ tương ứng mà dùng other để điền giá trị trả về. Nếu đã dùng mask, thường nên chỉ định other tường minh. Nếu không, giá trị trả về ở vị trí bị che là không xác định và có thể làm hỏng tính toán sau.
tl.store
tl.store ghi scalar hoặc tensor Triton vào các vị trí bộ nhớ chỉ định, cũng có thể dùng mask để tránh ghi vượt biên:
tl.store(output_ptrs, output, mask=mask)
tl.where
tl.where(condition, x, y) chọn kết quả từng phần tử theo điều kiện:
output = tl.where(condition, x, y)
Ngữ nghĩa giống: output[i] = x[i] if condition[i] else y[i]. Một ví dụ phổ biến là ReLU:
output = tl.where(x > 0.0, x, 0.0)
Lưu ý đặc biệt: cả hai nhánh x và y của tl.where đều được tính. Nó chỉ chọn kết quả cuối theo điều kiện, không ngăn tính toán hay truy cập bộ nhớ ở nhánh nào. Ví dụ:
# Nhánh không an toàn: có thể chia cho 0
result = tl.where(denominator != 0, numerator / denominator, 0.0)

# Nhánh an toàn
safe_denominator = tl.where(denominator != 0, denominator, 1.0)
result = numerator / safe_denominator
result = tl.where(denominator != 0, result, 0.0)
Vì vậy tl.where phù hợp để biểu diễn lựa chọn từng phần tử, nhưng đừng hiểu nó như câu lệnh control flow có thể bỏ qua một nhánh.
tl.dot
Triton cung cấp nhiều hàm toán từng phần tử kiểu NumPy và PyTorch, ví dụ:
y = tl.exp(x)
y = tl.log(x)
y = tl.sqrt(x)
y = tl.abs(x)
y = tl.maximum(x, 0.0)
y = tl.dot(x, y)
tl.dot tính nhân ma trận của hai khối dữ liệu 2D hoặc 3D. Trong GEMM kernel, tl.dot nhân và cộng dồn theo từng tile trên chiều :
# Tạo tensor toàn 0 với shape và dtype chỉ định
accumulator = tl.zeros(
    (BLOCK_SIZE_M, BLOCK_SIZE_N),
    dtype=tl.float32,
)

for k in range(0, K, BLOCK_SIZE_K):
    a = tl.load(a_ptrs, mask=a_mask, other=0.0)
    b = tl.load(b_ptrs, mask=b_mask, other=0.0)

    accumulator = tl.dot(a, b, accumulator)

    a_ptrs += BLOCK_SIZE_K * stride_ak
    b_ptrs += BLOCK_SIZE_K * stride_bk
Tham số accumulator cộng kết quả nhân ma trận lần này vào tensor đã có.
4-Hiện thực toán tử Triton Softmax
Triton kernel khởi chạy nhiều program instance trên grid. Có thể ví một program instance với một CUDA thread block: nhiều thread/warp phối hợp xử lý một hoặc nhiều khối dữ liệu.
Giống CUDA kernel, Triton cũng cần khai báo hàm kernel; Triton định nghĩa kernel bằng @triton.jit. Ba khối code sau nối lại thành hàm _softmax đầy đủ; hai đoạn sau chữ ký hàm đều thuộc thân hàm:
import triton
import triton.language as tl
from triton.runtime import driver

# Khai báo đây là một Triton kernel
@triton.jit
def _softmax(
    input_ptr,                    # con trỏ đầu của ma trận đầu vào
    output_ptr,                   # con trỏ đầu của ma trận đầu ra
    input_row_stride,             # khoảng cách giữa điểm bắt đầu hai hàng kề nhau của ma trận đầu vào
    output_row_stride,            # khoảng cách giữa điểm bắt đầu hai hàng kề nhau của ma trận đầu ra
    n_rows,                       # số hàng của ma trận
    n_cols,                       # số cột của ma trận
    BLOCK_SIZE: tl.constexpr,     # số phần tử logic mỗi vòng lặp; hằng số compile-time
    num_stages: tl.constexpr      # độ sâu software pipeline truyền cho tl.range
) :
Ở đây BLOCK_SIZE là số phần tử logic mà mỗi vòng lặp xử lý trong ví dụ này. tl.constexpr nghĩa là giá trị đã biết lúc biên dịch, nên compiler có thể xác định shape tensor và sinh code chuyên biệt. Có thể ví với hằng số compile-time của C++.
Trong ví dụ bài này, một program xử lý Softmax của nhiều hàng bằng vòng lặp, nên cần lấy id của program hiện tại và số program đã khởi chạy:
    # Một Triton program tương tự một CUDA thread block
    # tl.program_id(0) giống blockIdx.x; axis=0/1/2 tương ứng trục x/y/z của grid
    row_start = tl.program_id(axis=0)

    # Giống gridDim.x của CUDA: số program trên trục 0 của grid
    row_step = tl.num_programs(axis=0)
Giả sử khởi chạy program. Program mang số lần lượt xử lý các hàng cho đến khi chỉ số hàng đạt , mỗi vòng lặp chỉ tính một hàng.
Với mỗi hàng, trước hết tính con trỏ của từng cột, rồi tl.load dữ liệu, hoàn tất reduce và phép toán từng phần tử, cuối cùng tl.store kết quả:
    # Bước nhảy là row_step; row_idx là chỉ số hàng mà program hiện tại đang xử lý
    for row_idx in tl.range(row_start, n_rows, row_step, num_stages=num_stages) :
        # Con trỏ đầu của hàng đang xử lý
        row_start_ptr = input_ptr + row_idx * input_row_stride

        # col_offset: [0, 1, 2, ..., BLOCK_SIZE-1]
        # Ở đây BLOCK_SIZE phải là lũy thừa của 2 đã biết lúc biên dịch
        col_offset = tl.arange(0, BLOCK_SIZE)

        # Dựng BLOCK_SIZE con trỏ vị trí logic; vị trí vượt biên được mask che phía dưới
        input_ptrs = row_start_ptr + col_offset

        # Số cột thực tế không nhất thiết là lũy thừa của 2; cần mask để giới hạn phạm vi đọc
        mask = col_offset < n_cols

        # Vị trí mask=False không đọc bộ nhớ, điền -inf; khi max hàng hữu hạn, exp của chúng bằng 0
        row = tl.load(input_ptrs, mask=mask, other=-float('inf'))

        # Tính Softmax
        row_minus_max = row - tl.max(row, axis=0)
        numerator = tl.exp(row_minus_max)
        denominator = tl.sum(numerator, axis=0)
        softmax_output = numerator / denominator

        # Con trỏ đầu hàng ghi ra
        output_row_ptr = output_ptr + row_idx * output_row_stride
        # Offset con trỏ cụ thể của từng phần tử
        output_ptrs = output_row_ptr + col_offset
        tl.store(output_ptrs, softmax_output, mask=mask)
Lưu ý: row ở đây là tensor Triton 1D dài BLOCK_SIZE, nên tl.max(row, axis=0) và tl.sum(..., axis=0) đều reduce theo vị trí cột logic của hàng hiện tại và cho ra một scalar.
tl.range(..., num_stages=num_stages) gợi ý độ sâu software pipeline cho compiler, cố gắng chồng load và compute của các vòng lặp khác nhau để tăng mức dùng tài nguyên. Độ sâu càng cao, áp lực shared memory và register càng lớn.
Giống CUDA, Triton kernel cũng cần chỉ định launch grid. Cách dưới đây theo tutorial chính thức: biên dịch trước, truy vấn mức dùng tài nguyên, rồi ước lượng số program cần khởi chạy. Program tiếp tục xử lý các hàng sau trong vòng lặp; kiểu viết này thường gọi là persistent kernel.
DEVICE = torch.cuda.current_device()
properties = driver.active.utils.get_device_properties(DEVICE)
NUM_SM = properties['multiprocessor_count']   # số SM
NUM_REGS = properties['max_num_regs']         # ngân sách dung lượng register, tính theo register 32-bit
SIZE_SMEM = properties['max_shared_mem']      # ngân sách dung lượng shared memory, đơn vị byte
WARP_SIZE = properties['warpSize']            # trên NVIDIA GPU là 32
kernels = {}

def softmax(x):
    assert x.is_cuda

    n_rows, n_cols = x.shape
    y = torch.empty_like(x)

    # Làm tròn lên lũy thừa của 2 nhỏ nhất không nhỏ hơn n_cols
    BLOCK_SIZE = triton.next_power_of_2(n_cols)
    num_warps = 8       # một program dùng 8 warp, tức 256 CUDA thread
    num_stages = 4 if SIZE_SMEM > 200000 else 2       # độ sâu pipeline
    kernel, num_programs = kernels.get(BLOCK_SIZE, (None, 0))

    if kernel is None:
        # warmup chỉ biên dịch, không thật sự chạy. Trả về đối tượng kernel đã biên dịch
        kernel = _softmax.warmup(
            y, x,
            x.stride(0), y.stride(0),
            n_rows, n_cols, BLOCK_SIZE=BLOCK_SIZE,
            num_stages=num_stages, num_warps=num_warps,
            grid=(1,))

        # Khởi tạo CUDA kernel handle để truy vấn mức dùng tài nguyên của sản phẩm biên dịch.
        kernel._init_handles()
        n_regs = kernel.n_regs
        size_smem = kernel.metadata.shared
        occupancy = NUM_REGS // (n_regs * WARP_SIZE * num_warps)
        occupancy = min(occupancy, SIZE_SMEM // size_smem)
        num_programs = NUM_SM * occupancy
        kernels[BLOCK_SIZE] = (kernel, num_programs)

    num_programs = min(num_programs, n_rows)

    # Khởi chạy Softmax kernel
    # x và y được chuyển ngầm thành địa chỉ đầu của ma trận
    kernel[(num_programs, 1, 1)](
        x,
        y,
        x.stride(0),   # hiệu địa chỉ giữa các phần tử kề nhau cùng cột
        y.stride(0),
        n_rows,
        n_cols,
    )

    return y
5-So sánh hiệu năng
Triton cung cấp hàm so sánh benchmark tiện lợi. Bằng cách chỉ định các cấu hình tham số và hiện thực benchmark khác nhau, có thể nhanh chóng đánh giá hiệu năng toán tử dưới các cách hiện thực khác nhau.
Theo bài trước, khi lượng dữ liệu đủ lớn, Softmax thường bị memory-bound. Vì vậy dưới đây dùng băng thông hiệu dụng làm thước đo thống nhất để so hai hiện thực:
trong đó là số byte mỗi phần tử; là thời gian tính bằng mili giây.
# Decorator benchmark do Triton cung cấp
@triton.testing.perf_report(
    triton.testing.Benchmark(
        x_names=['N'],                               # tham số N dưới các cấu hình khác nhau
        x_vals=[128 * i for i in range(2, 17)],      # N=256, 384, ..., 2048
        x_log=True,
        line_arg='provider',                         # chọn hiện thực tương ứng mỗi đường cong qua provider
        line_vals=['triton', 'torch'],               # hai hiện thực được đo
        line_names=['Triton', 'Torch'],              # tên các đường cong so sánh
        styles=[('blue', '-'), ('green', '-')],      # màu các đường cong so sánh
        ylabel='Effective bandwidth (GB/s)',
        plot_name='fused-softmax-performance',
        args={'M': 64},                              # cố định M = 64
    )
)
def benchmark(M, N, provider):
    # Sinh input và chạy thao tác đo trên cùng CUDA stream hiện tại
    x = torch.rand(M, N, device=DEVICE, dtype=torch.float32)

    # Lần lượt trả về median, phân vị 20% và phân vị 80% của thời gian
    quantiles = [0.5, 0.2, 0.8]

    # So với hiện thực torch gốc
    if provider == 'torch':
        ms, min_ms, max_ms = triton.testing.do_bench(
            lambda: torch.softmax(x, axis=-1),
            quantiles=quantiles)

    # Đo toán tử Triton Softmax
    if provider == 'triton':
        ms, min_ms, max_ms = triton.testing.do_bench(
            lambda: softmax(x),
            quantiles=quantiles)

    # Tính GB/s theo cùng số byte đọc/ghi hiệu dụng
    gbps = lambda ms: 2 * x.numel() * x.element_size() / ms * 1e-6
    return gbps(ms), gbps(max_ms), gbps(min_ms)

if __name__ == '__main__':
    torch.manual_seed(0)
    # Đồng thời phủ kích thước nhỏ, số cột không phải lũy thừa của 2, và các shape khác dưới cùng BLOCK_SIZE
    for M, N in [(1, 1), (128, 256), (129, 255), (1823, 781)]:
        x = torch.randn(M, N, device=DEVICE, dtype=torch.float32)
        y_torch = naive_softmax(x)
        y_triton = softmax(x)
        torch.testing.assert_close(y_triton, y_torch, rtol=1e-5, atol=1e-7)
    print('Correctness checks passed.')

    # So băng thông hiệu dụng của Triton với Torch
    benchmark.run(print_data=True, show_plots=True)
Hàm do_bench sẽ warmup rồi đo lặp lại. Khi đặt quantiles=[0.5, 0.2, 0.8], kết quả trả về lần lượt là median, phân vị thứ 20 và phân vị thứ 80 của thời gian.
Kết quả chạy được như sau:
the max error is 1.862645149230957e-09
fused-softmax-performance:
         N      Triton      Torch
0    256.0   18.285714   6.736842
1    384.0   27.428571   9.142857
2    512.0   42.666665  12.190476
3    640.0   53.333331  15.238095
4    768.0   54.857142  17.454545
5    896.0   63.999999  18.666666
6   1024.0   73.142856  20.480001
7   1152.0   82.285713  21.735849
8   1280.0  106.666663  24.615385
9   1408.0  117.333329  26.074074
10  1536.0  127.999995  26.482758
11  1664.0  104.000000  28.689654
12  1792.0  149.333328  28.000000
13  1920.0  159.999994  30.967742
14  2048.0  146.285712  30.117647
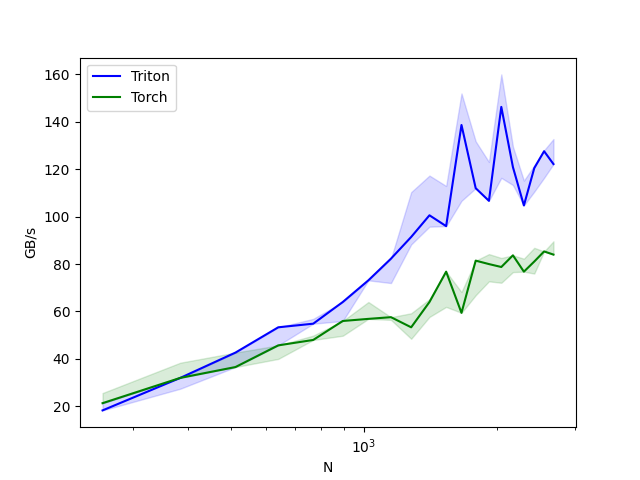
Từ kết quả trên:
- Khi lượng dữ liệu tăng, lợi thế của Triton Softmax so với phương pháp gốc của Torch càng rõ, cho thấy fusion của Triton kernel trong bộ test này thật sự cắt được overhead.
- Hiệu suất truy cập bộ nhớ của Triton cao hơn, và hiện thực toán tử cũng đơn giản hơn, dễ bảo trì hơn.
📝 Tóm tắt
Từ hiện thực cấp thread của CUDA đến biểu diễn cấp khối của Triton, nội dung cốt lõi bài này có thể gom thành ba mạch chính:
- Mô tả tính toán song song bằng khối dữ liệu: chuyển từ viết tường minh reduce, giao tiếp và đồng bộ của thread/warp sang mô tả dữ liệu và thao tác mà một program cần xử lý. Bạn vẫn phải chọn cách chia khối, grid và cách địa chỉ hóa; compiler ánh xạ phép toán cấp khối sang thread và warp.
- Dùng cú pháp cơ bản để viết toán tử đúng: phân công hàng ma trận bằng
tl.program_id,tl.num_programsvà vòng lặp; dựng offset cột bằngtl.arange; xử lý vị trí đệm bằngmaskvà-inf; rồi hoàn tất Softmax ổn định bằngtl.max,tl.expvàtl.sum. - Giảm overhead bằng fusion, dùng đo đạc để đánh giá lợi ích: gộp nhiều thao tác vào một kernel để giảm truy cập global memory của tensor trung gian và số lần khởi chạy; đồng thời chọn quy mô khởi chạy theo mức dùng tài nguyên; sau khi kiểm tra đúng, so hiệu năng với baseline rõ ràng theo thước đo băng thông hiệu dụng.
Triton đơn giản hóa chi tiết hiện thực cấp thread; hiệu năng toán tử vẫn phụ thuộc thuật toán, bố cục dữ liệu, áp lực tài nguyên và quy mô đầu vào. Sau ví dụ này, có thể dựa vào tài liệu chính thức để tiếp tục học cộng vector, LayerNorm và nhân ma trận, rồi dần luyện các cách chia khối và tinh chỉnh phức tạp hơn.
🎯 Checklist tự kiểm
- Giải thích được tile, program và grid của Triton lần lượt nghĩa là gì, và điều kiện để ví program với CUDA thread block;
- Mô tả được quy trình hiện thực đại khái của toán tử Triton Softmax, từ xác định program_id, tính con trỏ dữ liệu, load rồi tính toán đến ghi lại bộ nhớ, hiểu code từng bước;
- Phân biệt được ý nghĩa tham số
BLOCK_SIZEtrong hai mô hình Triton và CUDA ở bài này (Triton: số phần tử dữ liệu một program xử lý; CUDA: số thread trong một block) - Hiểu được cách dùng
tl.wherevà quá trình chọn nhánh của nó; - Từ
row_start,row_stepvàtl.range, liệt kê được chỉ số hàng mà mỗi program thực sự xử lý; - Hiểu được vì sao phải truyền
input_row_stride, và cách tính địa chỉ trong Triton kernel; - Hiểu được cách tính động
num_programstrong quá trình khởi chạy Triton kernel; - Giải thích được vì sao số cột được đệm lên lũy thừa của 2, và vì sao cả load lẫn store đều cần mask;
- Giải thích được vì sao khi lượng dữ liệu tăng, các cách hiện thực Softmax khác nhau xuất hiện chênh lệch hiệu suất, và hiểu bottleneck tối ưu nằm ở đâu;
- Thử dùng Triton hiện thực các toán tử khác (LayerNorm, GEMM, …) và so sánh với hiện thực Torch gốc;