3.7 Phân tích đầy đủ Transformer Decoder Block
Đơn vị tính toán cốt lõi của mô hình ngôn ngữ lớn là Transformer Decoder Block
Đơn vị tính toán cốt lõi của mô hình ngôn ngữ lớn là Transformer Decoder Block. Dù bạn tối ưu CUDA kernel, huấn luyện phân tán hay triển khai suy luận, đối tượng cuối cùng vẫn là matmul, chuẩn hóa và Attention bên trong Block này. Bài này tháo Block ra hết: từ lý do lịch sử chọn Decoder-only, sang cách làm causal mask, code PyTorch đầy đủ, cách tự tính tham số và FLOPs, rồi đến thực hành lập kế hoạch VRAM. Mục tiêu sau khi đọc xong: cầm giấy bút là tính được mô hình mã nguồn mở bất kỳ “có nhét vào card nào đó không”.
📑 Mục lục
- 1. Chọn kiến trúc: vì sao Decoder-only thắng thế
- 2. Luồng dữ liệu đầy đủ của Decoder Block
- 3. Causal Mask: giải thích mặt nạ nhân quả
- 4. Triển khai PyTorch: dựng Decoder Block từ đầu
- 5. So sánh cấu hình chiều của các mô hình phổ biến
- 6. Tự tính số tham số
- 7. Ước lượng FLOPs
- 8. Lập kế hoạch VRAM chi tiết
- 9. So sánh kiến trúc các mô hình mã nguồn mở phổ biến
- Danh sách tự kiểm
- Tài liệu tham khảo
1. Chọn kiến trúc: vì sao Decoder-only thắng thế
1.1 Ba kiến trúc Transformer
Paper gốc năm 2017 “Attention Is All You Need” đề xuất kiến trúc Encoder-Decoder: Encoder hiểu đầu vào, Decoder sinh đầu ra. Sau đó tách thành ba nhánh:
| Kiến trúc | Mô hình đại diện | Đặc điểm cốt lõi | Nhiệm vụ điển hình |
|---|---|---|---|
| Encoder-only | BERT, RoBERTa | Attention hai chiều, thấy đủ ngữ cảnh | Phân loại, NER, độ tương đồng câu |
| Encoder-Decoder | T5, BART, mBART | Encoder hiểu hai chiều, Decoder sinh tự hồi quy | Dịch, tóm tắt, hỏi đáp |
| Decoder-only | GPT series, LLaMA, Mistral, Qwen | Attention nhân quả một chiều, sinh tự hồi quy | Sinh văn bản tổng quát, hội thoại, suy luận |
Ví dụ: Encoder-only như chuyên gia đọc hiểu, giỏi “hiểu” nhưng không “viết”; Encoder-Decoder như phiên dịch viên, phải hiểu hết nguyên văn rồi mới dịch từng câu; Decoder-only như diễn giả ứng khẩu, vừa nghĩ vừa nói, mỗi câu chỉ dựa trên những gì đã nói.
1.2 Vì sao Decoder-only thắng
Sang thời đại mô hình lớn, Decoder-only gần như thống trị. Không phải ngẫu nhiên; có nhiều lý do chồng lên nhau:
✅ Mục tiêu huấn luyện thống nhất. Mục tiêu của Decoder-only cực đơn giản: dự đoán token tiếp theo. Dù ngôn ngữ hay nhiệm vụ gì, tín hiệu huấn luyện vẫn một kiểu. Encoder-Decoder cần thiết kế cặp “đầu vào-đầu ra”, dựng dữ liệu phức tạp hơn. Khi có hàng nghìn tỷ token không gắn nhãn, “dự đoán từ tiếp theo” là cách dùng dữ liệu tự nhiên và hiệu quả nhất.
✅ Scale dễ hơn. Decoder-only chỉ xếp chồng một loại Block. Muốn lớn hơn thì tăng số tầng hoặc chiều ẩn. Encoder-Decoder phải scale hai thành phần và cân tỷ lệ giữa chúng, không gian tinh chỉnh lớn hơn. Nghiên cứu Scaling Laws của OpenAI cho thấy, với ngân sách tính toán cố định, hiệu quả tham số của Decoder-only gần ngang Encoder-Decoder, nhưng độ phức tạp kỹ thuật thấp hơn nhiều.
✅ Lợi thế hiệu năng suy luận. Decoder-only chỉ cần một bộ KV Cache. Encoder-Decoder phải giữ cả đầu ra Encoder và KV Cache phía Decoder. Với hội thoại ngữ cảnh dài, quản lý KV Cache đơn giản hơn nghĩa là throughput hệ thống cao hơn.
✅ Quan sát thực nghiệm về khả năng nổi lên. Thực tế cho thấy khi số tham số vượt một ngưỡng, Decoder-only thể hiện rõ khả năng nổi lên (emergent ability) trong few-shot và zero-shot (ví dụ suy luận chain-of-thought). Trên Encoder-only và Encoder-Decoder các khả năng này kém rõ hơn.
✳️ Tóm một câu: Ở quy mô lớn, Decoder-only lấy kiến trúc gọn nhất để đạt khả năng tổng quát tốt nhất, đồng thời thân thiện nhất với hệ thống kỹ thuật. Từ GPT-3 đến LLaMA, rồi Mistral, Qwen, DeepSeek, tất cả đi theo nhánh này.
2. Luồng dữ liệu đầy đủ của Decoder Block
Luồng dữ liệu trong một Pre-Norm Decoder-only Block có thể biểu diễn như hình dưới.
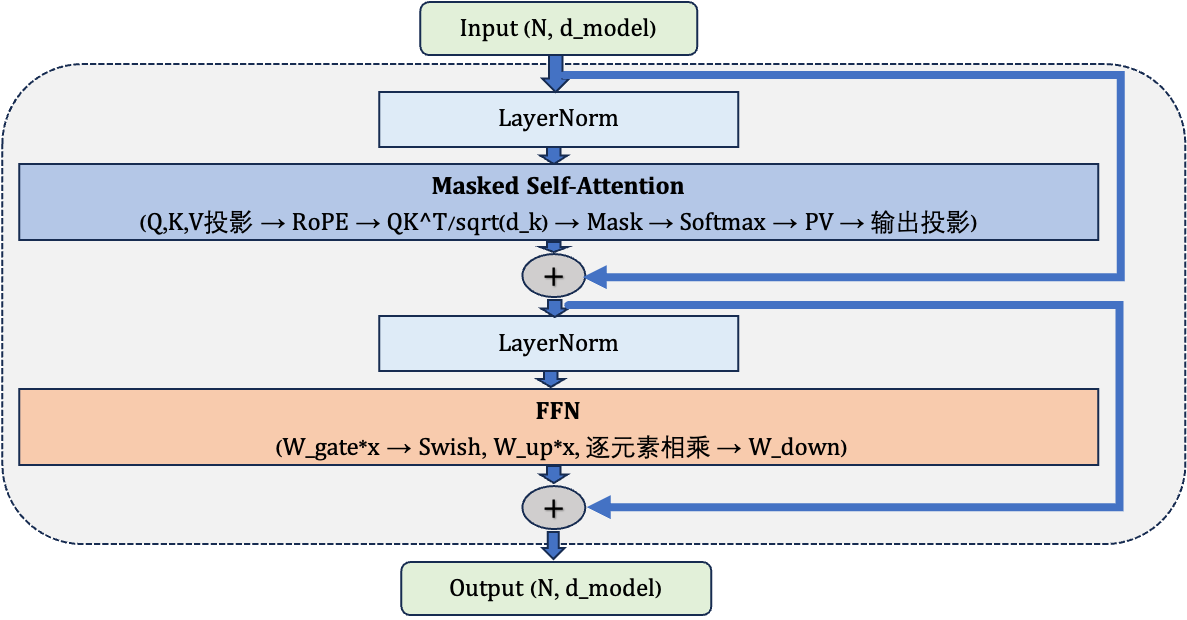
Vài chi tiết đáng chú ý:
🍎 RMSNorm thay vì LayerNorm. LLaMA và hầu hết mô hình sau dùng RMSNorm (Root Mean Square Normalization): bỏ bước trừ trung bình, chỉ giữ chia cho căn bậc hai trung bình bình phương. Tính toán đơn giản hơn, hiệu quả tương đương.
🍎 RoPE chỉ tác động lên Q và K. Mã hóa vị trí xoay làm tích vô hướng Q và K mang thông tin vị trí tương đối. V không cần xoay vì V mang “nội dung”, không phải “tín hiệu khớp vị trí”.
🍎 Đường residual của Pre-Norm sạch. Hai đường residual trong hình đều kéo thẳng từ nút Add, không qua biến đổi nào. Gradient có thể lan ngược theo residual mà không bị mất; đó là then chốt để huấn luyện mô hình sâu ổn định.
3. Causal Mask: giải thích mặt nạ nhân quả
3.1 Vì sao cần causal mask
Mục tiêu huấn luyện Decoder-only là “cho các token trước, dự đoán token tiếp theo”. Khi tính Attention của token thứ i, nó chỉ được thấy vị trí 0 đến i, không được “nhìn trộm” i+1 trở đi; nếu không bài toán dự đoán thành “thi mở sách”, mô hình chẳng học được gì.
Ràng buộc này hợp lý với sinh ngôn ngữ tự nhiên: khi nói chữ thứ năm, bạn thật sự chưa biết chữ thứ sáu. Mô hình phải tuân cùng thứ tự nhân quả.
Lúc huấn luyện, để hiệu quả, ta đưa cả chuỗi vào mô hình một lần và tính song song (không đưa từng token). Tính song song nghĩa là Attention của mọi token được tính cùng lúc; nếu không hạn chế, mỗi token sẽ “thấy” cả chuỗi. Causal Mask dùng để vừa tính song song vừa buộc “chỉ nhìn quá khứ”.
3.2 Minh họa ma trận mask
Giả sử độ dài chuỗi là 5. Ma trận điểm Attention S có shape (5, 5). S[i][j] là điểm attention thô của token i với token j. Causal mask yêu cầu: khi j > i (j đứng sau i), S[i][j] phải bị che.
Ma trận mask M trông như sau (0 = giữ, -inf = che):
Token:   t0    t1    t2    t3    t4
t0  [  0   -inf  -inf  -inf  -inf ]
t1  [  0     0   -inf  -inf  -inf ]
t2  [  0     0     0   -inf  -inf ]
t3  [  0     0     0     0   -inf ]
t4  [  0     0     0     0     0  ]
Cộng M vào S xong, các vị trí bị che thành âm vô cùng. Softmax tiếp theo: , trọng số attention ở đó thành không.
Cách nhìn khác: vị trí nào “nhìn được” (1 = thấy, 0 = không thấy):
Token:   t0   t1   t2   t3   t4
t0  [  1    0    0    0    0  ]    t0 chỉ thấy chính nó
t1  [  1    1    0    0    0  ]    t1 thấy t0 và chính nó
t2  [  1    1    1    0    0  ]    t2 thấy t0, t1 và chính nó
t3  [  1    1    1    1    0  ]    t3 thấy tất cả phía trước và chính nó
t4  [  1    1    1    1    1  ]    t4 thấy tất cả
Đây là ma trận tam giác dưới, nên causal mask còn gọi là “lower-triangular mask” hoặc “upper-triangular mask” (tùy bạn nói vùng giữ hay vùng che).
3.3 Cách triển khai
Ở mức code, causal mask rất gọn:
import torch

def create_causal_mask(seq_len, device='cuda'):
    """Tạo causal mask: vùng tam giác trên là -inf, còn lại là 0"""
    # torch.triu lấy tam giác trên; diagonal=1 bắt đầu từ một hàng trên đường chéo chính
    mask = torch.triu(
        torch.full((seq_len, seq_len), float('-inf'), device=device),
        diagonal=1
    )
    return mask

# Ví dụ: seq_len = 4
# tensor([[  0., -inf, -inf, -inf],
#         [  0.,   0., -inf, -inf],
#         [  0.,   0.,   0., -inf],
#         [  0.,   0.,   0.,   0.]])
Khi dùng, cộng thẳng vào điểm Attention:
scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(d_k)
scores = scores + create_causal_mask(seq_len, device=scores.device)
attn_weights = torch.softmax(scores, dim=-1)
Trong triển khai hiệu năng cao (như FlashAttention), causal mask không được dựng thành ma trận N×N rồi cộng. Trong quá trình tính theo tile, kiểm tra chỉ số để bỏ vùng tam giác trên không cần tính, vừa tiết kiệm VRAM vừa giảm tính toán vô ích.
4. Triển khai PyTorch: dựng Decoder Block từ đầu
Dưới đây là một Transformer Decoder Block đầy đủ, chạy được, gồm Pre-Norm (RMSNorm), Masked Multi-Head Attention (có RoPE), SwiGLU FFN và residual.
import torch
import torch.nn as nn
import torch.nn.functional as F
import math

class RMSNorm(nn.Module):
    """RMSNorm: chỉ chuẩn hóa theo RMS, bỏ bước trừ trung bình"""

    def __init__(self, d_model: int, eps: float = 1e-6):
        super().__init__()
        self.eps = eps
        self.weight = nn.Parameter(torch.ones(d_model))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # x: (batch, seq_len, d_model)
        rms = torch.sqrt(x.pow(2).mean(dim=-1, keepdim=True) + self.eps)
        return x / rms * self.weight

def precompute_rope_freqs(d_k: int, max_seq_len: int, theta: float = 10000.0):
    """Tiền tính tần số xoay của RoPE"""
    # Tần số: theta_i = 1 / (theta ^ (2i / d_k)), i = 0, 1, ..., d_k/2 - 1
    freqs = 1.0 / (theta ** (torch.arange(0, d_k, 2).float() / d_k))
    # Chỉ số vị trí: 0, 1, ..., max_seq_len - 1
    positions = torch.arange(max_seq_len).float()
    # Tích ngoài: (max_seq_len, d_k // 2)
    angles = torch.outer(positions, freqs)
    # Trả về cos và sin, đều shape (max_seq_len, d_k // 2)
    return torch.cos(angles), torch.sin(angles)

def apply_rope(x: torch.Tensor, cos: torch.Tensor, sin: torch.Tensor):
    """
    Áp mã hóa vị trí xoay lên Q hoặc K
    x: (batch, seq_len, num_heads, d_k)
    cos, sin: (seq_len, d_k // 2)
    """
    seq_len = x.shape[1]
    cos = cos[:seq_len].unsqueeze(0).unsqueeze(2)  # (1, seq, 1, d_k//2)
    sin = sin[:seq_len].unsqueeze(0).unsqueeze(2)

    # Tách chiều cuối của x thành hai nửa
    x1 = x[..., : x.shape[-1] // 2]
    x2 = x[..., x.shape[-1] // 2 :]

    # Công thức xoay: (x1 * cos - x2 * sin, x1 * sin + x2 * cos)
    rotated = torch.cat([x1 * cos - x2 * sin, x1 * sin + x2 * cos], dim=-1)
    return rotated

class MaskedMultiHeadAttention(nn.Module):
    """Multi-head attention có causal mask"""

    def __init__(self, d_model: int, num_heads: int):
        super().__init__()
        assert d_model % num_heads == 0
        self.d_model = d_model
        self.num_heads = num_heads
        self.d_k = d_model // num_heads

        self.W_Q = nn.Linear(d_model, d_model, bias=False)
        self.W_K = nn.Linear(d_model, d_model, bias=False)
        self.W_V = nn.Linear(d_model, d_model, bias=False)
        self.W_O = nn.Linear(d_model, d_model, bias=False)

    def forward(self, x: torch.Tensor, rope_cos: torch.Tensor,
                rope_sin: torch.Tensor) -> torch.Tensor:
        batch, seq_len, _ = x.shape

        # Chiếu tuyến tính
        Q = self.W_Q(x)  # (batch, seq, d_model)
        K = self.W_K(x)
        V = self.W_V(x)

        # Tách multi-head: (batch, seq, num_heads, d_k)
        Q = Q.view(batch, seq_len, self.num_heads, self.d_k)
        K = K.view(batch, seq_len, self.num_heads, self.d_k)
        V = V.view(batch, seq_len, self.num_heads, self.d_k)

        # Áp RoPE (chỉ Q và K)
        Q = apply_rope(Q, rope_cos, rope_sin)
        K = apply_rope(K, rope_cos, rope_sin)

        # Đổi trục thành (batch, num_heads, seq, d_k) để matmul theo batch
        Q = Q.transpose(1, 2)
        K = K.transpose(1, 2)
        V = V.transpose(1, 2)

        # Điểm attention: (batch, num_heads, seq, seq)
        scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)

        # Causal mask
        causal_mask = torch.triu(
            torch.full((seq_len, seq_len), float('-inf'), device=x.device),
            diagonal=1
        )
        scores = scores + causal_mask.unsqueeze(0).unsqueeze(0)

        # Softmax + tổng có trọng số
        attn_weights = F.softmax(scores, dim=-1)
        output = torch.matmul(attn_weights, V)  # (batch, heads, seq, d_k)

        # Ghép head: (batch, seq, d_model)
        output = output.transpose(1, 2).contiguous().view(batch, seq_len, -1)

        # Chiếu đầu ra
        return self.W_O(output)

class SwiGLUFFN(nn.Module):
    """FFN SwiGLU: ba lớp tuyến tính + kích hoạt có cổng"""

    def __init__(self, d_model: int, ffn_dim: int):
        super().__init__()
        self.W_gate = nn.Linear(d_model, ffn_dim, bias=False)
        self.W_up = nn.Linear(d_model, ffn_dim, bias=False)
        self.W_down = nn.Linear(ffn_dim, d_model, bias=False)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # nhánh gate: kích hoạt bằng SiLU (= Swish với beta=1)
        gate = F.silu(self.W_gate(x))    # (batch, seq, ffn_dim)
        # nhánh up: biến đổi tuyến tính, không kích hoạt
        up = self.W_up(x)                # (batch, seq, ffn_dim)
        # nhân cổng + giảm chiều
        return self.W_down(gate * up)    # (batch, seq, d_model)

class TransformerDecoderBlock(nn.Module):
    """Transformer Decoder Block Pre-Norm đầy đủ"""

    def __init__(self, d_model: int, num_heads: int, ffn_dim: int,
                 norm_eps: float = 1e-6):
        super().__init__()
        self.norm1 = RMSNorm(d_model, eps=norm_eps)
        self.attn = MaskedMultiHeadAttention(d_model, num_heads)
        self.norm2 = RMSNorm(d_model, eps=norm_eps)
        self.ffn = SwiGLUFFN(d_model, ffn_dim)

    def forward(self, x: torch.Tensor, rope_cos: torch.Tensor,
                rope_sin: torch.Tensor) -> torch.Tensor:
        # Sublayer 1: RMSNorm -> Masked MHA -> residual
        h = x + self.attn(self.norm1(x), rope_cos, rope_sin)
        # Sublayer 2: RMSNorm -> SwiGLU FFN -> residual
        out = h + self.ffn(self.norm2(h))
        return out

# ---------- Kiểm tra: khởi tạo với cấu hình LLaMA-2-7B ----------
if __name__ == "__main__":
    d_model = 4096
    num_heads = 32
    ffn_dim = 11008
    max_seq_len = 4096
    d_k = d_model // num_heads  # 128

    block = TransformerDecoderBlock(d_model, num_heads, ffn_dim)

    # Tiền tính RoPE
    rope_cos, rope_sin = precompute_rope_freqs(d_k, max_seq_len)

    # Đầu vào giả: batch=2, seq_len=128
    x = torch.randn(2, 128, d_model)
    output = block(x, rope_cos, rope_sin)

    print(f"Input shape:  {x.shape}")       # (2, 128, 4096)
    print(f"Output shape: {output.shape}")   # (2, 128, 4096)

    # Đếm tham số
    total_params = sum(p.numel() for p in block.parameters())
    print(f"Single block params: {total_params:,}")  # ~201M
Vài điểm then chốt trong code:
- RMSNorm chỉ có một tham số học được
weight(tức ), không có bias. Nó tính RMS trên vector đặc trưng của mỗi token rồi chuẩn hóa. - RoPE được tiền tính, không thêm tham số học được. Chỉ xoay Q và K; V giữ nguyên.
- SwiGLU FFN có ba ma trận trọng số. Đầu ra qua SiLU rồi nhân từng phần tử với đầu ra (cơ chế cổng), cuối cùng giảm chiều.
- Residual trong
forwardcủa Block là phép cộng đơn giản:h = x + self.attn(self.norm1(x), ...).
5. So sánh cấu hình chiều của các mô hình phổ biến
Các mô hình khác quy mô về bản chất cùng một cấu trúc Decoder Block, chỉ khác cấu hình chiều. Bảng dưới tóm các tham số then chốt của vài mô hình mang tính mốc:
| Mô hình | max_seq_len | |||||||
|---|---|---|---|---|---|---|---|---|
| LLaMA-2-7B | 4096 | 32 | 32 (MHA) | 128 | 32 | 11008 | 32000 | 4096 |
| LLaMA-2-13B | 5120 | 40 | 40 (MHA) | 128 | 40 | 13824 | 32000 | 4096 |
| LLaMA-2-70B | 8192 | 64 | 8 (GQA) | 128 | 80 | 28672 | 32000 | 4096 |
| GPT-3 175B | 12288 | 96 | 96 (MHA) | 128 | 96 | 49152 | 50257 | 2048 |
| Mistral-7B | 4096 | 32 | 8 (GQA) | 128 | 32 | 14336 | 32000 | 32768 |
Vài quy luật đáng chú ý:
🍎 (chiều mỗi head) gần như cố định 128. Dù mô hình lớn thế nào, mỗi head attention vẫn xử lý 128 chiều. Khi mô hình lớn hơn, tăng số head () và số tầng (), không tăng chiều từng head. 128 chiều đã đủ để mỗi head bắt một kiểu attention có nghĩa.
🍎 Tỷ lệ với . Transformer chuẩn dùng . Với SwiGLU, để giữ tổng tham số gần như cũ (ba ma trận thay vì hai), thường lấy , rồi làm tròn lên số thuận tiện. Ví dụ LLaMA-2-7B: , làm tròn 11008 (bội của 256, thuận GPU alignment). Mistral-7B dùng lớn hơn một chút vì chủ đích chọn FFN lớn hơn.
🍎 GQA xuất hiện. LLaMA-2-70B và Mistral-7B dùng Grouped-Query Attention: số KV head ít hơn Q head. LLaMA-2-70B dùng 8 KV head phục vụ 64 Q head (mỗi nhóm 8 Q head chia sẻ một bộ KV), cắt KV Cache xuống còn 1/8 so với MHA, giảm mạnh VRAM lúc suy luận.
6. Tự tính số tham số
Tự tính được số tham số là kỹ năng cơ bản của kỹ sư AI Infra. Biết số tham số mới ước được VRAM, chi phí giao tiếp và chi phí huấn luyện.
6.1 Suy ra công thức chung
Một Decoder-only chuẩn gồm các phần:
(1) ❇️ Lớp Token Embedding
Ánh xạ token ID thành vector:
trong đó là kích thước từ vựng, là .
(2) ❇️ Một Decoder Block
Với Block dùng MHA (mỗi head có KV riêng) và SwiGLU FFN:
Phần Attention gồm bốn ma trận chiếu (không bias):
Vì sao ? , , , mỗi cái là ma trận , mỗi cái tham số.
Nếu dùng GQA (số KV head , số Q head , chiều mỗi head ):
Phần SwiGLU FFN gồm ba ma trận (không bias):
trong đó là chiều trung gian của FFN.
Phần RMSNorm (hai cái, mỗi cái tham số):
Tổng một Block:
(3) ❇️ RMSNorm cuối + đầu ra (LM Head)
Hạng đầu là tham số RMSNorm cuối; hạng hai là LM Head (ánh xạ sang ).
(4) ❇️ Tổng tham số mô hình
trong đó là số tầng. Nếu Embedding và LM Head chia sẻ trọng số (Weight Tying), trừ đi một .
6.2 Tính chi tiết: ví dụ LLaMA-2-7B
Nhắc cấu hình: , , , , ,
🍓 Tham số Attention (một Block):
| Ma trận | Shape | Tham số |
|---|---|---|
| 4096 x 4096 | 16,777,216 | |
| 4096 x 4096 | 16,777,216 | |
| 4096 x 4096 | 16,777,216 | |
| 4096 x 4096 | 16,777,216 | |
| Cộng Attention | 67,108,864 (67.1M) |
Kiểm tra:
🍓 Tham số FFN (một Block):
| Ma trận | Shape | Tham số |
|---|---|---|
| 4096 x 11008 | 45,088,768 | |
| 4096 x 11008 | 45,088,768 | |
| 11008 x 4096 | 45,088,768 | |
| Cộng FFN | 135,266,304 (135.3M) |
Kiểm tra:
🍓 Tham số RMSNorm (một Block):
🍓 Tổng một Block:
= 202,383,360 (~202M)
Tỷ lệ FFN = 135.3M / 202.4M = 66.8%, tỷ lệ Attention = 67.1M / 202.4M = 33.2%
🍓 Cả mô hình:
| Thành phần | Cách tính | Tham số |
|---|---|---|
| Token Embedding | 131,072,000 | |
| 32 tầng Block | 6,476,267,520 | |
| RMSNorm cuối | 4096 | 4,096 |
| LM Head | 131,072,000 | |
| Tổng | 6,738,415,616 (~6.74B) |
LLaMA-2 giữ Embedding và LM Head là hai bộ trọng số độc lập (không chia sẻ), nên 6.74B đã gồm hai lần 131M, khớp số công bố. Nếu chia sẻ trọng số thì trừ 131M, khoảng 6.61B. Nhãn chính thức “7B” là giá trị xấp xỉ.
6.3 Bài tập: số tham số LLaMA-2-13B
Cấu hình: , , , , ,
Bạn có thể tự tính trước rồi đối chiếu đáp án dưới:
Một Block:
- Attention: (104.9M)
- FFN: (212.3M)
- RMSNorm:
- Tổng một Block: (~317M)
Cả mô hình:
- Embedding:
- 40 tầng Block:
- RMSNorm cuối:
- LM Head:
- Tổng: (~13.0B)
Khớp nhãn chính thức 13B.
6.4 Kỹ thuật Weight Tying
Nhiều mô hình để Token Embedding và LM Head chia sẻ cùng một ma trận trọng số. Kỹ thuật này gọi là Weight Tying, Press và Wolf đề xuất năm 2017.
Trực giác: Embedding “ánh xạ token ID thành vector ngữ nghĩa” (rời rạc → liên tục); LM Head “ánh xạ vector ngữ nghĩa về xác suất token” (liên tục → rời rạc). Hai phép gần như nghịch đảo, dùng chung ma trận (một chiều xuôi, một chiều chuyển vị) là hợp lý.
Lợi ích của Weight Tying:
- Tiết kiệm tham số: với , , tiết kiệm 131M tham số, khoảng 2% của mô hình 7B
- Hiệu ứng chính quy hóa: chia sẻ trọng số như một ràng buộc ẩn, ngăn không gian Embedding và không gian đầu ra “trôi” khỏi nhau
- Giảm VRAM: bớt lưu một ma trận
GPT-2 dùng Weight Tying; series LLaMA-2 thì không (tie_word_embeddings: false trong cấu hình HuggingFace). Có dùng hay không phụ thuộc tỷ lệ kích thước từ vựng so với mô hình. Khi từ vựng nhỏ so với mô hình (32000 vs 7B), tỷ lệ tiết kiệm tham số nhỏ, nhưng hiệu ứng chính quy hóa vẫn có ý nghĩa.
7. Ước lượng FLOPs
Biết số tham số để tính VRAM; biết FLOPs để ước thời gian huấn luyện và mức tận dụng phần cứng.
7.1 FLOPs của phép nhân ma trận
Nền tảng ước lượng FLOPs là nhân ma trận. Với :
- Ma trận kết quả có phần tử
- Mỗi phần tử cần phép nhân và phép cộng
- Tổng FLOPs khoảng (nhân và cộng mỗi cái tính một phép dấu phẩy động)
7.2 FLOPs của một lần lan truyền xuôi
Với Transformer tham số, xử lý chuỗi dài , FLOPs lan truyền xuôi xấp xỉ:
Đó là quy tắc kinh nghiệm "". Trực giác: phần lớn tính toán là nhân ma trận; mỗi tham số trong lan truyền xuôi tham gia đúng một lần nhân ma trận, đóng góp khoảng 2 FLOPs (một nhân một cộng), rồi nhân với token trong chuỗi.
Chính xác hơn, chỉ tính FLOPs của lớp tuyến tính (GEMM), bỏ qua và trong Attention (phần này tỷ lệ với bình phương độ dài chuỗi). Công thức đầy đủ hơn:
Hạng hai là FLOPs Attention (mỗi tầng mỗi head có hai nhân ma trận , mỗi cái , tổng ). Khi ngắn (ví dụ 2048), hạng hai nhỏ hơn nhiều hạng một, "" là xấp xỉ tốt. Khi rất dài (như 128K), FLOPs Attention có thể gần bằng hoặc vượt lớp tuyến tính.
7.3 FLOPs huấn luyện vs suy luận
✳️ FLOPs lúc huấn luyện
Huấn luyện gồm lan truyền xuôi và ngược. Theo kinh nghiệm, lan truyền ngược khoảng gấp đôi xuôi (cần gradient theo trọng số và theo đầu vào). Vì vậy:
Cho cả quá trình huấn luyện trên token:
Ví dụ: LLaMA-2-7B huấn luyện trên 2 nghìn tỷ token:
- FLOPs
Dùng 1000 card A100 (đỉnh BF16 312 TFLOPS mỗi card, giả sử MFU=50%):
- Công suất hữu hiệu FLOPS
- Thời gian huấn luyện giây ≈ 6 ngày
Khớp thứ tự độ lớn thời gian huấn luyện công bố.
✳️ FLOPs lúc suy luận
Suy luận chỉ có lan truyền xuôi, khoảng FLOPs mỗi token. Điểm đặc biệt của Decode: mỗi bước chỉ xử lý 1 token, nhân ma trận thoái hóa thành nhân ma trận-vector (GEMV); GPU gần như không đầy tải tính toán, nút thắt là băng thông VRAM chứ không phải đỉnh FLOPS. Vì vậy tối ưu suy luận quan tâm băng thông bộ nhớ (Memory Bound) hơn là đỉnh tính toán.
7.4 Ví dụ ước lượng
Suy luận LLaMA-2-7B trên A100-80GB:
- FLOPs Decode một token GFLOPs
- Đỉnh FP16 của A100 TFLOPS
- Về lý thuyết chỉ cần
Thực tế Decode một token khoảng 10-20ms. Vì sao lệch hàng trăm lần? Decode là Memory Bound: phải chuyển toàn bộ trọng số mô hình từ HBM (13.4 GB FP16). Băng thông HBM của A100 là 2 TB/s; chỉ chuyển trọng số đã mất 13.4 GB / 2 TB/s = 6.7ms. Cộng thêm chuyển KV Cache và overhead khác, 10-20ms là hợp lý.
8. Lập kế hoạch VRAM chi tiết
Lập kế hoạch VRAM là bài thực hành phổ biến nhất trong AI Infra: cho một mô hình và một (hoặc nhiều) GPU, phán xem có nhét được không; nếu không thì làm gì.
8.1 VRAM trọng số mô hình
VRAM trọng số phụ thuộc số tham số và độ chính xác lưu trữ:
| Định dạng | Byte mỗi tham số | Trọng số 7B | Trọng số 13B | Trọng số 70B |
|---|---|---|---|---|
| FP32 | 4 Bytes | 26.8 GB | 52.0 GB | 280.0 GB |
| FP16 / BF16 | 2 Bytes | 13.4 GB | 26.0 GB | 140.0 GB |
| INT8 | 1 Byte | 6.7 GB | 13.0 GB | 70.0 GB |
| INT4 | 0.5 Bytes | 3.35 GB | 6.5 GB | 35.0 GB |
Công thức: VRAM = số_tham_số × byte_mỗi_tham_số
FP16 và BF16 đều là số thực 16 bit, chiếm cùng VRAM. BF16 có nhiều bit số mũ hơn (8 so với 5 của FP16), phạm vi lớn hơn, huấn luyện ít tràn hơn; hiện là lựa chọn mainstream khi huấn luyện.
8.2 VRAM trạng thái huấn luyện: bốn thành phần chính
Huấn luyện cần VRAM lớn hơn nhiều so với chỉ lưu trọng số. Lấy huấn luyện độ chính xác hỗn hợp (trọng số BF16 + optimizer FP32) làm ví dụ:
(1) Trọng số mô hình: 2 Bytes/param
Lúc huấn luyện lưu BF16, tức Bytes ( là số tham số).
(2) Gradient: 2 Bytes/param
Gradient cùng shape với trọng số, lưu BF16, Bytes.
(3) Trạng thái optimizer: tùy optimizer
Đây là phần ăn VRAM lớn. Với Adam/AdamW phổ biến nhất, cần giữ ba thứ:
- Bản sao tham số FP32 (Master Weights): Bytes. Vì sao cần bản FP32? BF16 chỉ khoảng 3-4 chữ số có nghĩa; khi lr × gradient rất nhỏ (ví dụ 1e-5), độ chính xác BF16 không biểu diễn được bước cập nhật nhỏ đó và bị làm tròn mất. FP32 khoảng 7 chữ số có nghĩa, bắt được các cập nhật nhỏ.
- Mô-men bậc một (First Moment, m): Bytes. Adam giữ trung bình động mũ của gradient để ước trung bình gradient.
- Mô-men bậc hai (Second Moment, v): Bytes. Adam giữ trung bình động mũ của bình phương gradient để ước phương sai, phục vụ learning rate thích ứng.
Tổng trạng thái optimizer: = Bytes.
Khi người ta nói “Adam cần VRAM gấp 4 lần số tham số”, ý là khoảng ≈ thêm 3-4 lần so với trọng số+gradient; riêng trạng thái optimizer đã gấp 6 lần trọng số BF16 .
(4) Activation Memory (VRAM giá trị kích hoạt)
Giá trị kích hoạt trung gian lúc lan truyền xuôi phải giữ lại cho lan truyền ngược. VRAM kích hoạt tỷ lệ với batch_size và độ dài chuỗi. Công thức ước thô:
trong đó là độ dài chuỗi, là batch_size, là , là số tầng, là hằng số (khoảng 10-14, tùy có dùng Activation Checkpointing hay không).
Với LLaMA-2-7B, seq_len=2048, batch_size=4, không dùng Activation Checkpointing:
- Ước thô Bytes (BF16)
- GB
Dùng Activation Checkpointing (chỉ lưu đầu vào mỗi tầng, lúc ngược tính lại giá trị trung gian) có thể giảm VRAM kích hoạt xuống khoảng 1/3 đến 1/5, đổi lại tăng khoảng 33% tính toán.
✳️ Tổng hợp VRAM huấn luyện (LLaMA-2-7B, 6.7B tham số):
| Thành phần | Cách tính | VRAM |
|---|---|---|
| Trọng số mô hình BF16 | 13.4 GB | |
| Gradient BF16 | 13.4 GB | |
| Master Weights FP32 | 26.8 GB | |
| Mô-men bậc một Adam (FP32) | 26.8 GB | |
| Mô-men bậc hai Adam (FP32) | 26.8 GB | |
| Tổng tĩnh | 107.2 GB | |
| Activation (ước) | batch=4, seq=2048 | ~25.8 GB |
| Tổng cộng | ~133 GB |
133 GB đã vượt VRAM một A100-80GB. Đó là lý do huấn luyện mô hình 7B trông không lớn nhưng thực tế vẫn cần huấn luyện phân tán (ZeRO, tensor parallelism, v.v.) mới chạy được.
8.3 VRAM suy luận: trọng số + KV Cache
Suy luận không cần gradient và trạng thái optimizer, nhu cầu VRAM đơn giản hơn nhiều:
(1) Trọng số mô hình
Ví dụ suy luận FP16: 6.7B × 2 = 13.4 GB
(2) KV Cache
Mỗi token ở mỗi tầng cần cache một vector K và một vector V:
Với LLaMA-2-7B (MHA, ):
- Một token: Bytes = 512 KB
- seq_len = 4096: KB = 2 GB
- batch_size = 16: GB = 32 GB
✳️ Tổng hợp VRAM suy luận:
| Thành phần | LLaMA-2-7B (FP16) | LLaMA-2-7B (INT4) |
|---|---|---|
| Trọng số mô hình | 13.4 GB | 3.35 GB |
| KV Cache (seq=4096, batch=16) | 32 GB | 32 GB (KV thường vẫn FP16) |
| Overhead khác (framework, buffer) | ~1 GB | ~1 GB |
| Tổng | ~46.4 GB | ~36.4 GB |
Lưu ý: dù trọng số lượng hóa INT4, KV Cache thường vẫn FP16 vì lượng hóa KV ảnh hưởng độ chính xác mạnh. Những năm gần đây có nghiên cứu lượng hóa KV Cache (như KIVI, KVQuant), nén KV xuống INT4 thậm chí INT2, nhưng cần hiệu chuẩn và đánh giá độ chính xác thêm.
8.4 Case lập kế hoạch đầy đủ
Tình huống: triển khai suy luận LLaMA-2-13B trên một A100-80GB, mục tiêu batch_size=8, độ dài chuỗi tối đa 4096. Có nhét được không?
Bước 1, tính trọng số mô hình:
- 13B tham số × 2 Bytes (FP16) = 26 GB
Bước 2, tính KV Cache:
- Cấu hình LLaMA-2-13B: , (MHA),
- KV mỗi token: Bytes = 800 KB
- seq=4096, batch=8: GB
Bước 3, cộng overhead framework:
- CUDA context + buffer framework + không gian tạm ≈ 2 GB
Bước 4, tổng:
- 26 + 25.6 + 2 = 53.6 GB
✳️ Kết luận: 53.6 GB < 80 GB, nhét được, còn khoảng 26 GB dư.
Nếu muốn tăng batch_size lên 16?
- KV Cache gấp đôi: GB
- Tổng: GB
Rất sát trần 80 GB, gần như không còn dư; chạy thực tế dễ OOM. Khi đó có thể:
- Lượng hóa trọng số INT8: GB, tổng 66.2 GB, khả thi
- Dùng mô hình GQA (như Mistral) để giảm KV Cache
- Lượng hóa KV Cache
- Giảm độ dài chuỗi tối đa
Đó là giá trị thực của lập kế hoạch VRAM: không đoán “chắc chạy được”, mà tính chính xác từng khoản, tìm nút thắt, chọn chiến lược tối ưu phù hợp.
9. So sánh kiến trúc các mô hình mã nguồn mở phổ biến
Cuối cùng, một bảng so sánh lựa chọn kiến trúc của các LLM mã nguồn mở phổ biến hiện nay để có cái nhìn tổng thể:
| Đặc điểm | LLaMA-2 | LLaMA-3 | Mistral-7B | Qwen-2.5 | DeepSeek-V3 |
|---|---|---|---|---|---|
| Kiểu Attention | MHA (7B/13B) / GQA (70B) | GQA | GQA | GQA | MLA (Multi-head Latent Attention) |
| Số KV head (hạng 7B) | 32 (MHA) | 8 | 8 | 4 | — (MLA nén KV) |
| Mã hóa vị trí | RoPE | RoPE | RoPE | RoPE | RoPE |
| Chuẩn hóa | RMSNorm (Pre-Norm) | RMSNorm (Pre-Norm) | RMSNorm (Pre-Norm) | RMSNorm (Pre-Norm) | RMSNorm (Pre-Norm) |
| Kiểu FFN | SwiGLU | SwiGLU | SwiGLU | SwiGLU | SwiGLU + MoE |
| Có MoE? | Không | Không | Bản Mixtral có | Một số bản có | Có (256 expert, Top-8) |
| Kích thước từ vựng | 32000 | 128256 | 32000 | 151936 | 129280 |
| Ngữ cảnh tối đa | 4096 | 8192 (mở rộng được) | 32768 (Sliding Window) | 32768+ | 128K+ |
| Thiết kế đặc biệt | — | Từ vựng lớn hơn, ngữ cảnh dài hơn | Sliding Window Attention | Mở rộng theo nhu cầu | Kết hợp MLA + MoE |
Vài xu hướng then chốt:
GQA trở thành chuẩn. Từ MHA của LLaMA-2 đến hầu hết mô hình sau dùng GQA; động lực chính là giảm VRAM KV Cache lúc suy luận. Số KV head từ 32 xuống 8 thậm chí 4, KV Cache giảm 4-8 lần.
Từ vựng tiếp tục lớn. Từ 32000 của LLaMA-2 lên 128256 của LLaMA-3: từ vựng lớn hơn nghĩa là hỗ trợ đa ngôn ngữ tốt hơn và hiệu quả token cao hơn (cùng văn bản dùng ít token hơn), nhưng cũng tăng tham số lớp Embedding.
MoE trỗi dậy. DeepSeek-V3 và Mixtral dùng mixture-of-experts: tổng tham số lớn hơn nhưng tham số kích hoạt ít hơn (mỗi token chỉ kích hoạt vài expert) để nâng chất lượng. Điều đó mang thách thức kỹ thuật mới cho huấn luyện và suy luận phân tán (Expert Parallelism, cân bằng tải, v.v.).
Đổi mới MLA. Multi-head Latent Attention của DeepSeek-V3 chiếu KV xuống không gian tiềm ẩn chiều thấp rồi khôi phục, giữ năng lực mô hình đồng thời nén mạnh KV Cache; đây là bước phát triển tiếp theo của ý tưởng GQA.
🎯 Danh sách tự kiểm
Sau bài này, kiểm các khả năng sau:
- Giải thích được vì sao Decoder-only thắng trong thời đại mô hình lớn, nêu ít nhất ba lý do
- Vẽ được trên bảng trắng sơ đồ luồng dữ liệu Decoder Block đầy đủ, ghi vị trí và thứ tự RMSNorm, Masked MHA, SwiGLU FFN, residual
- Vẽ được ma trận causal mask (cho độ dài chuỗi ), giải thích vai trò ở tam giác trên
- Tự tính được số tham số LLaMA-2-7B và 13B (sai số không quá 5%), nói rõ tỷ lệ tham số FFN và Attention
- Dùng công thức "" ước FLOPs huấn luyện, "" ước FLOPs suy luận
- Tính được VRAM trọng số của mô hình cho trước ở FP16, INT8, INT4
- Tính được Adam cần bao nhiêu VRAM, và giải thích vì sao cần Master Weights FP32
- Cho cấu hình mô hình và loại GPU, hoàn thành lập kế hoạch VRAM đầy đủ (trọng số + KV Cache, hoặc trọng số + gradient + optimizer + Activation), phán được có nhét được không
📚 Tài liệu tham khảo
Paper
- Attention Is All You Need (Vaswani et al., 2017): https://arxiv.org/abs/1706.03762 — Paper gốc Transformer
- LLaMA 2: Open Foundation and Fine-Tuned Chat Models (Touvron et al., 2023): https://arxiv.org/abs/2307.09288 — Báo cáo kỹ thuật LLaMA-2
- Mistral 7B (Jiang et al., 2023): https://arxiv.org/abs/2310.06825 — Kiến trúc Mistral và Sliding Window Attention
- GLU Variants Improve Transformer (Shazeer, 2020): https://arxiv.org/abs/2002.05202 — Hàm kích hoạt SwiGLU
- Using the Output Embedding to Improve Language Models (Press & Wolf, 2017): https://arxiv.org/abs/1608.05859 — Kỹ thuật Weight Tying
- Scaling Laws for Neural Language Models (Kaplan et al., 2020): https://arxiv.org/abs/2001.08361 — Quy luật scale quy mô và hiệu năng
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models (Rajbhandari et al., 2020): https://arxiv.org/abs/1910.02054 — Tối ưu VRAM ZeRO
- DeepSeek-V3 Technical Report (DeepSeek-AI, 2024): https://arxiv.org/abs/2412.19437 — Kiến trúc MLA + MoE
Tutorial và blog
- The Illustrated Transformer (Jay Alammar): https://jalammar.github.io/illustrated-transformer/
- Transformer Math 101 (EleutherAI): https://blog.eleuther.ai/transformer-math/ — Suy diễn chi tiết tham số và FLOPs
- LLM Training: FSDP vs DeepSpeed (Hugging Face): https://huggingface.co/docs/transformers/main/en/perf_train_gpu_many