Cơ bản về GPU: từ kiến trúc phần cứng đến tính toán AI
Hiểu có hệ thống kiến trúc phần cứng GPU, mô hình lập trình CUDA, phân cấp bộ nhớ và đơn vị tính toán, làm nền vững để học sâu AI Infra
GPU là “động cơ” của kỷ nguyên mô hình lớn. Train một LLM trăm tỷ tham số có thể cần hàng nghìn GPU chạy hàng tháng, còn throughput và độ trễ của dịch vụ suy luận cũng phụ thuộc trực tiếp vào hiệu quả tận dụng GPU. Với kỹ sư AI Infra, hiểu GPU không phải môn tự chọn mà là nền phần cứng cho mọi tối ưu sau này (kernel, song song, scheduling).
Bài này xuất phát từ những câu hỏi cơ bản nhất: vì sao GPU phù hợp tính toán AI? Bên trong nó trông thế nào? Chương trình chạy trên đó ra sao? Mục tiêu là dựng một khung nhận thức GPU tương đối đầy đủ.
Mục lục
- 1. CPU vs GPU: vì sao deep learning chọn GPU
- 2. Phân tích kiến trúc phần cứng GPU
- 3. Phân cấp bộ nhớ và băng thông
- 4. Tensor Core: động cơ cốt lõi của tăng tốc AI
- 5. Mô hình lập trình CUDA
- 6. Các chỉ số hiệu năng GPU then chốt
- 7. So sánh ngang các GPU AI phổ biến
- 8. Quản lý bộ nhớ: thách thức cốt lõi của AI Infra
- 9. Liên kết đa card: từ một máy đến cụm
- Tóm tắt
- Checklist tự kiểm
- Tài liệu tham khảo
1. CPU vs GPU: vì sao deep learning chọn GPU
Cách tốt nhất để thấy giá trị của GPU là đặt nó cạnh CPU.
Hình dung bạn phải chấm 10.000 bài trắc nghiệm. Cách của CPU là thuê một giáo viên giàu kinh nghiệm: nhanh, xử lý được dạng khó, nhưng mỗi lần chỉ chấm một bài. Cách của GPU là thuê 10.000 người làm thời vụ, mỗi người chỉ biết đối đáp án, nhưng tất cả làm cùng lúc; một giây là xong hết.
Đó là khác biệt cốt lõi giữa hướng độ trễ (latency-oriented) và hướng throughput (throughput-oriented).
1.1 Khác biệt căn bản về triết lý kiến trúc
| 📊 Chiều so sánh | CPU | GPU |
|---|---|---|
| Mục tiêu thiết kế | Độ trễ thấp cho tác vụ phức tạp | Throughput cao cho nhiều tác vụ đơn giản |
| Số nhân | Vài đến vài chục “nhân lớn” | Hàng nghìn đến hàng vạn “nhân nhỏ” |
| Năng lực mỗi nhân | Mạnh (nhánh phức tạp, thực thi lệch thứ tự) | Yếu (ALU đơn giản, thực thi theo thứ tự) |
| Tỷ lệ cache | Phần lớn diện tích chip | Một phần nhỏ diện tích chip |
| Logic điều khiển | Phức tạp (OoO, bộ dự đoán nhánh) | Đơn giản (nhiều nhân chia sẻ điều khiển) |
| Băng thông bộ nhớ | Thấp hơn (DDR5 ~100 GB/s) | Rất cao (HBM3 ~3 TB/s) |
| Tác vụ phù hợp | Logic tuần tự, hệ điều hành, dịch vụ mạng | Nhân ma trận, data parallel, đồ họa |
1.2 Vì sao deep learning vốn hợp GPU
Cốt lõi tính toán của deep learning là gì? Xuống tầng đáy, đó là lượng lớn phép nhân ma trận và phép từng phần tử:
- Forward: mỗi lớp là , bản chất là nhân ma trận
- Backward: tính gradient vẫn là nhân ma trận ()
- Attention: , cốt lõi vẫn là nhân ma trận
Các phép này có hai đặc điểm then chốt:
- Độ song song dữ liệu cực cao: tính từng phần tử trong ma trận độc lập với nhau, phân cho các nhân tính khác nhau một cách tự nhiên
- Mẫu tính toán đều: không cần nhánh phức tạp; mọi thread chạy cùng một lệnh
Đó đúng là thế mạnh của GPU: hàng nghìn nhân đơn giản làm cùng lúc, throughput vượt xa CPU.
💡 Gợi ý: Một H100 đạt khoảng 989 TFLOPS FP16, trong khi CPU server cao cấp (như Intel Xeon w9-3595X) thường chỉ quanh vài TFLOPS FP16. Chênh lệch hơn hai bậc độ lớn.
2. Phân tích kiến trúc phần cứng GPU
Đã biết vì sao GPU nhanh, hãy xem bên trong nó trông thế nào. Lấy NVIDIA GPU làm ví dụ, từ ngoài vào trong có thể chia thành ba tầng:
2.1 Phân cấp GPC → TPC → SM
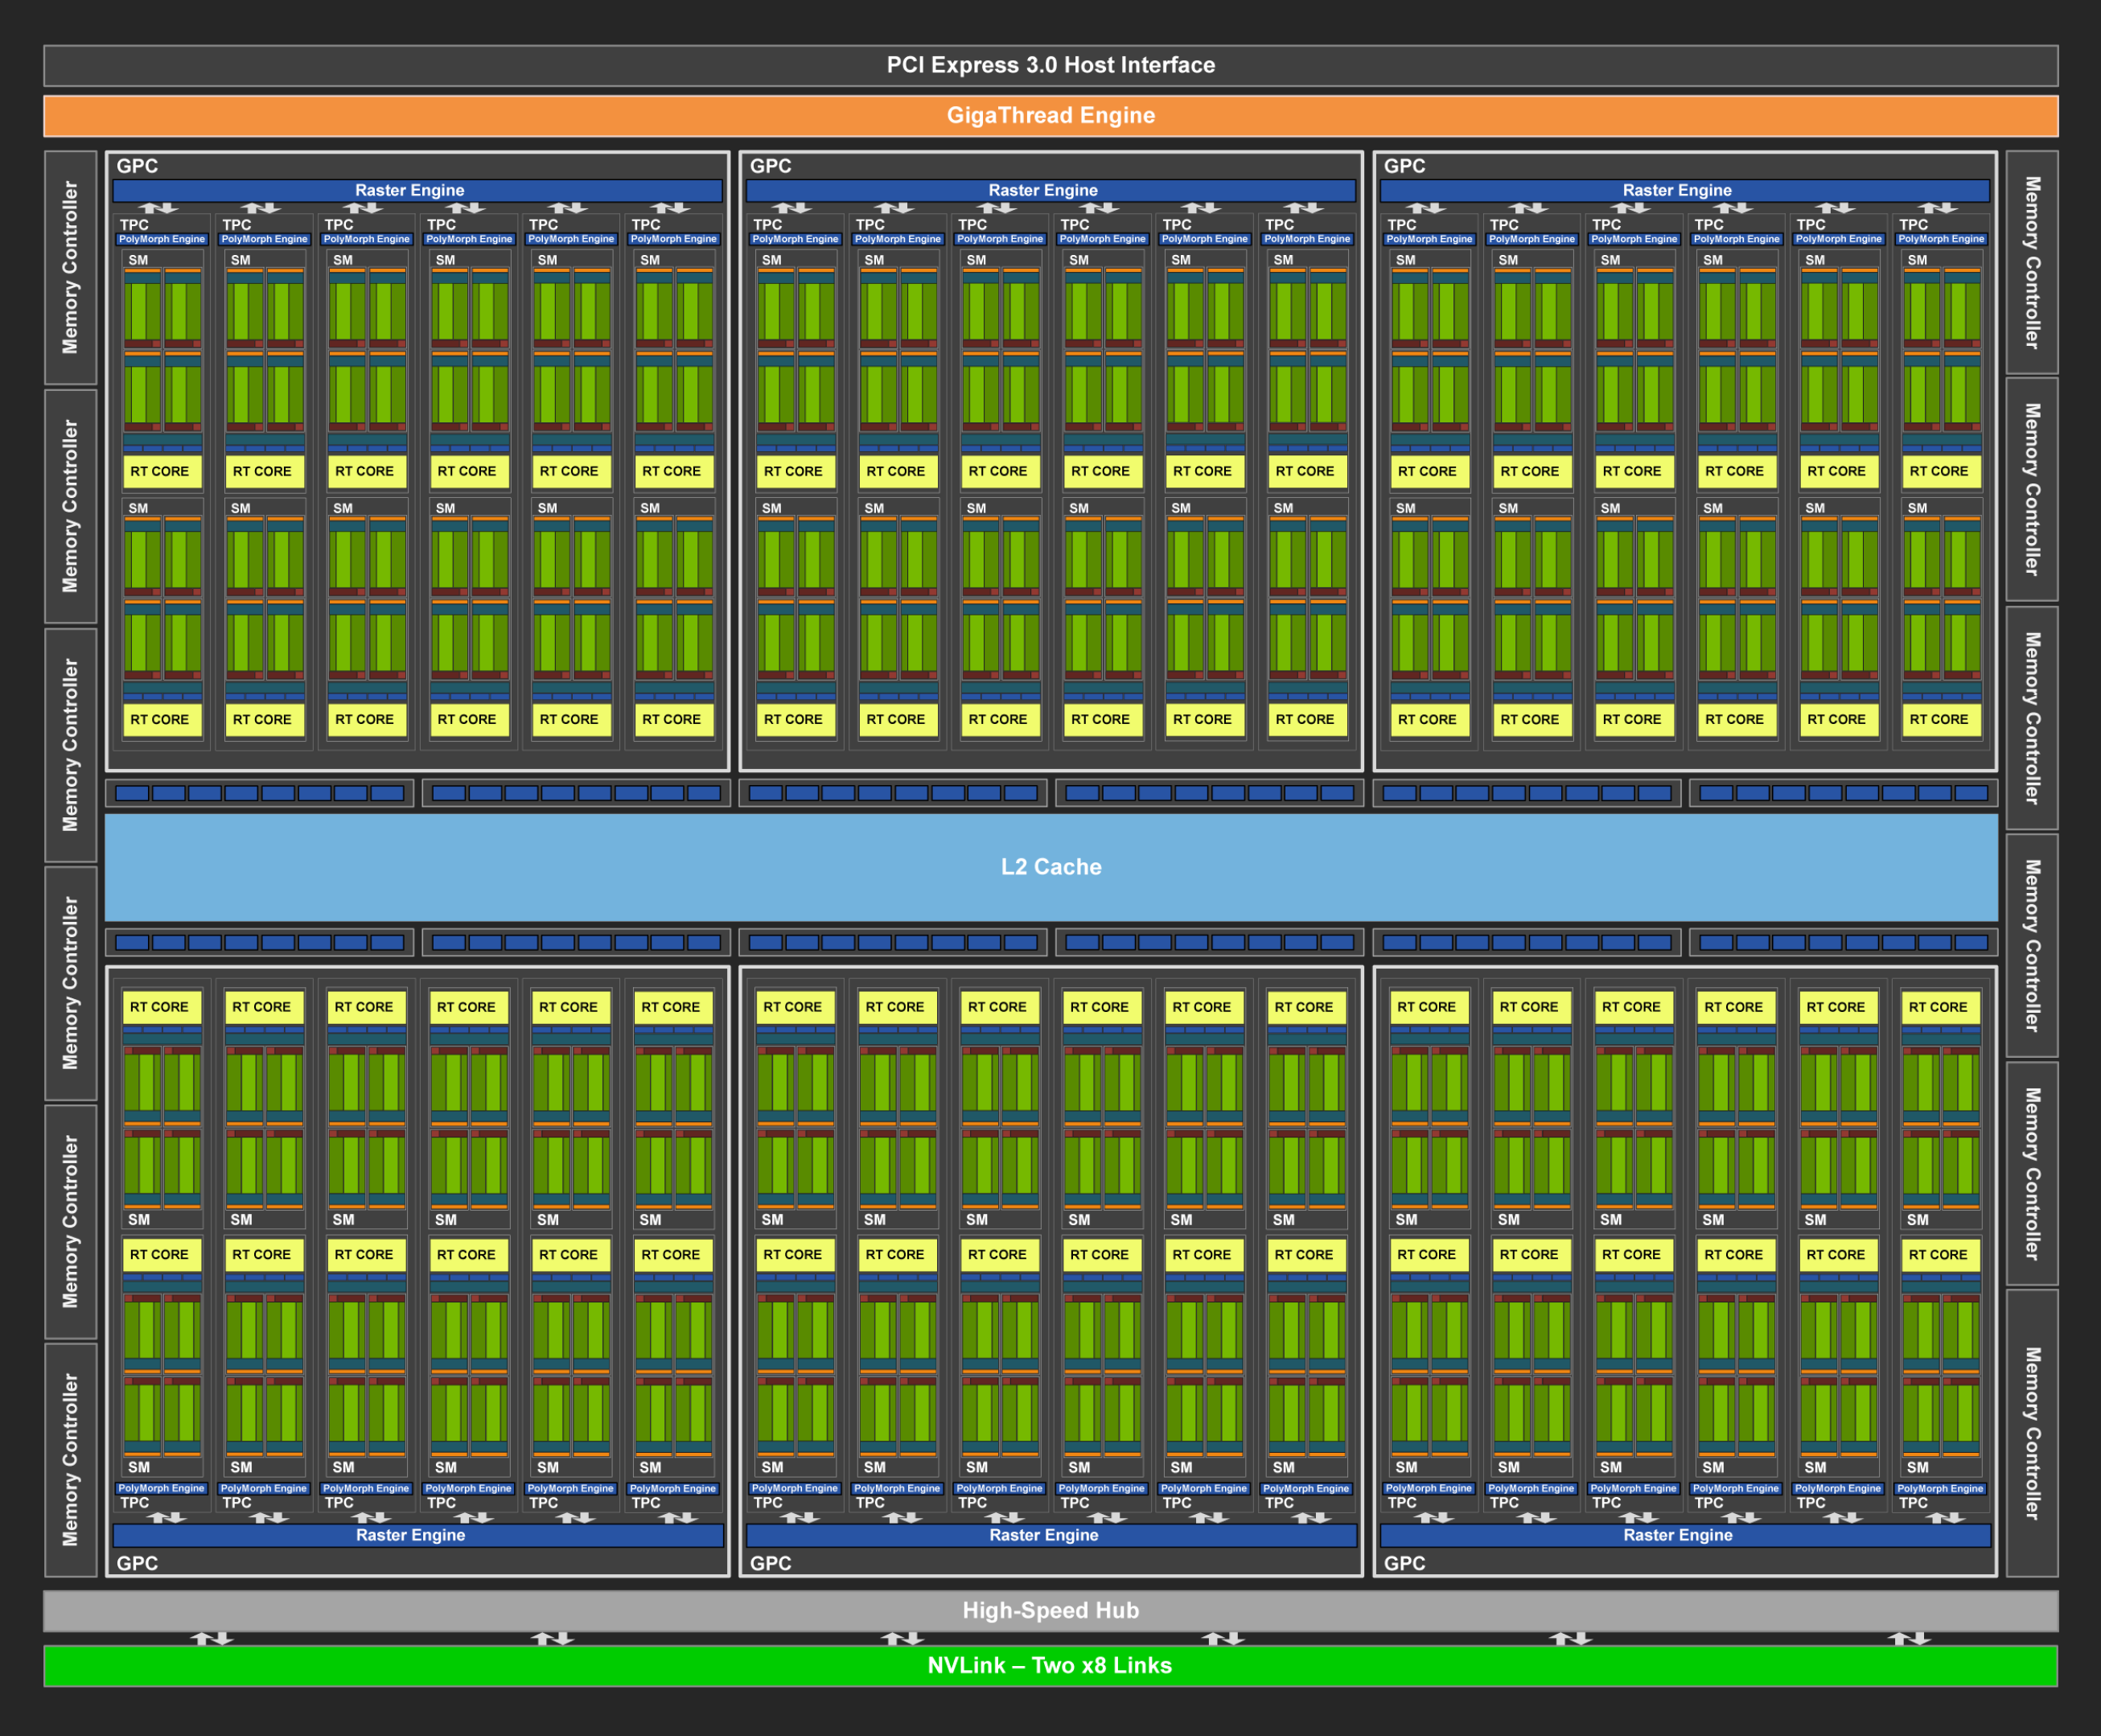
Nhân tính toán của NVIDIA GPU được tổ chức theo tầng, giống sơ đồ tổ chức của một công ty lớn:
Chip GPU
├── GPC (Graphics Processing Cluster)  ← "đơn vị kinh doanh"
│   ├── TPC (Texture Processing Cluster)  ← "phòng ban"
│   │   ├── SM (Streaming Multiprocessor)  ← "nhóm"; đơn vị scheduling cơ bản của GPU
│   │   │   ├── CUDA Core × N  ← "nhân viên"; tính FP32/INT32
│   │   │   ├── Tensor Core × M  ← "chuyên gia"; tính ma trận
│   │   │   ├── SFU (Special Function Unit)  ← sin/cos/exp và tương tự
│   │   │   ├── Register File  ← thanh ghi (lưu trữ nhanh nhất)
│   │   │   ├── Shared Memory  ← bộ nhớ chia sẻ mọi thread trong SM
│   │   │   └── L1 Cache
│   │   └── SM ...
│   └── TPC ...
├── GPC ...
├── L2 Cache (chia sẻ toàn cục)
└── Memory Controller → HBM (bộ nhớ thiết bị)
2.2 SM: đơn vị scheduling cơ bản của GPU
SM (Streaming Multiprocessor) là chìa khóa để hiểu kiến trúc GPU. Mọi scheduling và thực thi thread đều diễn ra ở tầng SM.
Lấy SM của H100 làm ví dụ, mỗi SM chứa:
| 🔧 Thành phần | Số lượng | Vai trò |
|---|---|---|
| CUDA Core (FP32) | 128 | Phép số thực và số nguyên |
| Tensor Core (thế hệ 4) | 4 | Nhân-cộng ma trận (MMA) |
| Load/Store Unit | 32 | Đọc/ghi bộ nhớ |
| SFU | 16 | Hàm siêu việt (sin, cos, exp, …) |
| Warp Scheduler | 4 | Mỗi chu kỳ schedule 4 warp |
| Register File | 256 KB | Thanh ghi riêng của từng thread |
| Shared Memory / L1 Cache | 228 KB (cấu hình được) | Lưu trữ tốc độ cao chia sẻ trong SM |
📌 Điểm then chốt: SM là độ hạt nhỏ nhất khi phân bổ tài nguyên. Khi bạn viết CUDA kernel, một Thread Block được schedule lên một SM. Thanh ghi, shared memory và các tài nguyên khác trong SM được mọi Thread Block trên SM đó chia nhau.
2.3 Warp: đơn vị thực thi nhỏ nhất của GPU
GPU không chạy từng thread một, mà theo đơn vị warp (bó thread): 32 thread khóa bước chạy cùng một lệnh. Giống đội quân đi đều: 32 người nghe một khẩu lệnh, bước cùng một chân.
Warp (32 thread)
├── Thread 0:  thực thi add r1, r2, r3
├── Thread 1:  thực thi add r1, r2, r3  (cùng lệnh, dữ liệu khác)
├── Thread 2:  thực thi add r1, r2, r3
├── ...
└── Thread 31: thực thi add r1, r2, r3
Mô hình thực thi này gọi là SIMT (Single Instruction, Multiple Threads), phần mở rộng SIMD của NVIDIA.
⚠️ Lưu ý: Nếu các thread trong warp gặp nhánh (if-else), các thread đi nhánh khác nhau bị mask, một phần thread sẽ chạy không. Đó là warp divergence, sát thủ hiệu năng cần tránh triệt để khi lập trình GPU.
3. Phân cấp bộ nhớ và băng thông
GPU tính nhanh đến đâu, nếu dữ liệu “không kịp đổ vào” cũng vô ích. Trong tải AI, băng thông bộ nhớ thường trở thành nút thắt trước cả FLOPS. Đó là lý do giới AI Infra có câu “Memory is the new compute”.
3.1 Kim tự tháp phân cấp lưu trữ GPU
Phân cấp lưu trữ của GPU giống CPU: càng gần nhân tính thì càng nhanh, dung lượng càng nhỏ. Bảng dưới lấy H100 SXM làm ví dụ; băng thông là giá trị tổng hợp cả card:
| 📊 Tầng | Dung lượng | Băng thông | Độ trễ | Phạm vi | Ghi chú |
|---|---|---|---|---|---|
| Register (thanh ghi) | ~255 mỗi thread | — | ~0 cycle | Riêng một thread | Nhanh nhất; dung lượng rất hạn |
| Shared Memory | ~228 KB mỗi SM | ~31 TB/s | ~30 cycle | Mọi thread trong SM | Cache “kiểu L1” do lập trình viên quản lý tường minh |
| L1 Cache | Chia sẻ với Shared Memory | Cộng với Shared Memory ~31 TB/s | ~30 cycle | Trong SM | Phần cứng tự quản lý |
| L2 Cache | ~50 MB mỗi card | ~9.45 TB/s | ~200 cycle | Toàn cục | Mọi SM chia sẻ |
| HBM (bộ nhớ thiết bị) | 80 GB | 3.35 TB/s | ~600 cycle | Toàn cục | Kho chính; băng thông quyết định trần throughput |
Ghi chú về băng thông:
- Shared Memory ~31 TB/s là ước lượng lý thuyết: 32 bank mỗi SM × 4 B/cycle = 128 B/cycle, tức 132 SM × 128 B × 1.83 GHz ≈ 31 TB/s, với giả định không có bank conflict.
- L1 và Shared Memory là cùng một khối SRAM vật lý, chia sẻ băng thông. Con số 30.92 TB/s trong bài TileLang là gộp cả hai; không xem là băng thông riêng của L1.
- 9.45 TB/s của L2 lấy từ Table 2, Appendix D của bài TileLang. Giá trị đo L2 lệch khá nhiều tùy phương pháp; ở đây chỉ dùng làm tham chiếu bậc độ lớn.
- 3.35 TB/s của HBM3 là đỉnh lý thuyết NVIDIA công bố.
3.2 HBM: bộ nhớ băng thông cao
GDDR truyền thống giống đường một làn: tốc độ truyền hữu hạn. HBM (High Bandwidth Memory) xếp chồng hàng nghìn làn, nối thẳng với chip GPU qua silicon interposer, nhân băng thông lên nhiều lần.
| 📊 Loại bộ nhớ | GPU đại diện | Băng thông | Dung lượng |
|---|---|---|---|
| GDDR6X | RTX 4090 | 1,008 GB/s | 24 GB |
| HBM2e | A100 | 2,039 GB/s | 80 GB |
| HBM3 | H100 | 3,350 GB/s | 80 GB |
| HBM3e | B200 | 8,000 GB/s | 192 GB |
💡 Gợi ý: Từ A100 đến B200, băng thông bộ nhớ tăng gần 4 lần. Điều này quan trọng với suy luận LLM: giai đoạn decode là tác vụ memory-bound điển hình; băng thông tăng gấp đôi thì throughput lý thuyết gần như cũng gấp đôi.
3.3 Mô hình Roofline: điểm cân bằng giữa FLOPS và băng thông
Để phán một tác vụ là compute-bound (bị giới hạn bởi FLOPS) hay memory-bound (bị giới hạn bởi băng thông), dùng chỉ số cường độ số học (arithmetic intensity):
Khi cường độ số học thấp hơn tỷ lệ ops:byte của GPU (FLOPS / băng thông), tác vụ là memory-bound; ngược lại là compute-bound.
Với H100 SXM:
- FLOPS FP16: 989 TFLOPS
- Băng thông HBM3: 3,350 GB/s
- Tỷ lệ ops:byte = FLOPs/Byte
Nghĩa là: mỗi lần kernel đọc 1 byte từ bộ nhớ thiết bị, cần thực hiện ít nhất 295 phép FP16 mới “no” được FLOPS. Nếu không, GPU sẽ ngồi chờ dữ liệu.
📌 Điểm then chốt: Hầu hết kernel deep learning (đặc biệt Attention, LayerNorm, hàm kích hoạt, …) có cường độ số học thấp hơn 295 rất nhiều. Đó là lý do FlashAttention, kernel fusion và các kỹ thuật tối ưu tương tự quan trọng đến vậy: ý tưởng cốt lõi là giảm truy cập bộ nhớ và nâng cường độ số học.
4. Tensor Core: động cơ cốt lõi của tăng tốc AI
CUDA Core thực thi lệnh số học vô hướng. Lấy đơn vị thực thi hỗ trợ một FP32 FMA (fused multiply-add) mỗi chu kỳ làm ví dụ: đỉnh throughput là 2 FLOPs mỗi chu kỳ. Tensor Core là đơn vị chuyên nhân-cộng ma trận; mỗi chu kỳ có thể hoàn thành nhiều phép nhân-cộng vô hướng tương đương. Throughput cụ thể phụ thuộc kiến trúc, độ chính xác đầu vào, độ chính xác tích lũy và có dùng structured sparsity hay không.
4.1 Nguyên lý hoạt động
Phép cơ bản của Tensor Core là nhân-cộng ma trận (MMA, Matrix Multiply-Accumulate):
Trong đó , , , là các ma trận kích thước nhỏ (kích thước cụ thể phụ thuộc độ chính xác và thế hệ kiến trúc).
Lấy lệnh PTX mma.sync.aligned.m16n8k16.row.col.f32.f16.f16.f32 làm ví dụ, là kích thước ma trận logic :
- Ma trận A: hình 16 × 16, FP16.
- Ma trận B: hình 16 × 8, FP16.
- Ma trận C và D: hình 16 × 8, FP32, dùng để tích lũy và xuất.
- Một MMA đầy đủ có khối lượng tính FLOPs, với quy ước một phép nhân-cộng vô hướng = 2 FLOPs.
Hình dạng lệnh không bằng throughput mỗi chu kỳ của một Tensor Core. mma.sync trên được cả warp phối hợp thực thi; 4096 FLOPs là tổng của thao tác cấp warp đó. Không nhân thêm 32, cũng không xem đó là lượng một Tensor Core hoàn thành trong một chu kỳ. PTX mô tả ngữ nghĩa lệnh; throughput và độ trễ phần cứng phải tra tài liệu kiến trúc đích, không suy ra chỉ từ . NVIDIA PTX ISA: mma
4.2 Tiến hóa các định dạng độ chính xác
Các định dạng khác nhau đánh đổi khác nhau giữa FLOPS, độ chính xác và chiếm dụng bộ nhớ:
| 📊 Độ chính xác | Độ rộng bit | Dải động | Tensor Core hỗ trợ lần đầu | Ứng dụng điển hình |
|---|---|---|---|---|
| FP32 | 32 bit | Cao | — | Độ chính xác chuẩn, tích lũy loss |
| TF32 | 19 bit | Giống FP32 | Ampere (A100) | Train (đường FP32 mặc định trên Ampere) |
| FP16 | 16 bit | Hẹp hơn | Volta (V100) | Train mixed precision (cần loss scaling) |
| BF16 | 16 bit | Giống FP32 | Ampere (A100) | Train mixed precision (khuyến nghị; không cần loss scaling) |
| FP8 (E4M3/E5M2) | 8 bit | Tùy chọn | Hopper (H100) | Train + suy luận |
| INT8 | 8 bit | Số nguyên | Turing (T4) | Lượng tử hóa suy luận |
| FP4 | 4 bit | Rất hẹp | Blackwell (B200) | Lượng tử hóa suy luận |
💡 Gợi ý: BF16 và FP16 đều 16 bit, nhưng BF16 giữ 8 bit số mũ giống FP32 nên dải động lớn hơn, train ít tràn hơn. Train mô hình lớn hiện đại gần như luôn dùng BF16 chứ không phải FP16.
4.3 Hệ số nhân FLOPS của Tensor Core
Đỉnh của các đường tính khác nhau lệch rất lớn. Với H100 SXM, bảng dưới thống nhất theo quy ước dense; các hàng Tensor Core dùng tích lũy FP32:
| 📊 Đường tính | Đỉnh lý thuyết (khoảng) |
|---|---|
| CUDA Core, FP32 FMA | 67 TFLOPS |
| Tensor Core, đầu vào TF32 | 495 TFLOPS |
| Tensor Core, đầu vào FP16 / BF16 | 989 TFLOPS |
| Tensor Core, đầu vào FP8 | 1,979 TFLOPS |
Đây là đỉnh phần cứng theo độ chính xác và đường thực thi khác nhau, không phải hệ số tăng tốc ứng dụng. Đặc biệt TF32 không có độ chính xác mantissa đầy đủ như FP32. Các số Tensor Core có dấu sao trên trang sản phẩm NVIDIA H100 đã gồm tăng tốc thưa; bảng trên chia 2 để lấy giá trị dense gần đúng. Thông số NVIDIA H100 và chú thích sparsity
📌 Điểm then chốt: Để kích hoạt tăng tốc Tensor Core, chiều ma trận phải thỏa yêu cầu căn chỉnh (thường là bội của 8 hoặc 16). Trong thực tế, nếu hidden_size của mô hình không phải bội của 8, Tensor Core có thể không được tận dụng hết.
5. Mô hình lập trình CUDA
CUDA là khung lập trình tính toán song song của NVIDIA, là cầu nối giữa “thuật toán phần mềm” và “thực thi phần cứng”. Dù bạn hàng ngày dùng PyTorch chứ ít khi viết CUDA trực tiếp, hiểu mô hình lập trình này vẫn giúp nắm được chuyện gì diễn ra phía dưới.
5.1 Phân cấp thread: Grid → Block → Thread
Chương trình CUDA chạy trên GPU theo đơn vị kernel. Thread của kernel được tổ chức ba tầng:
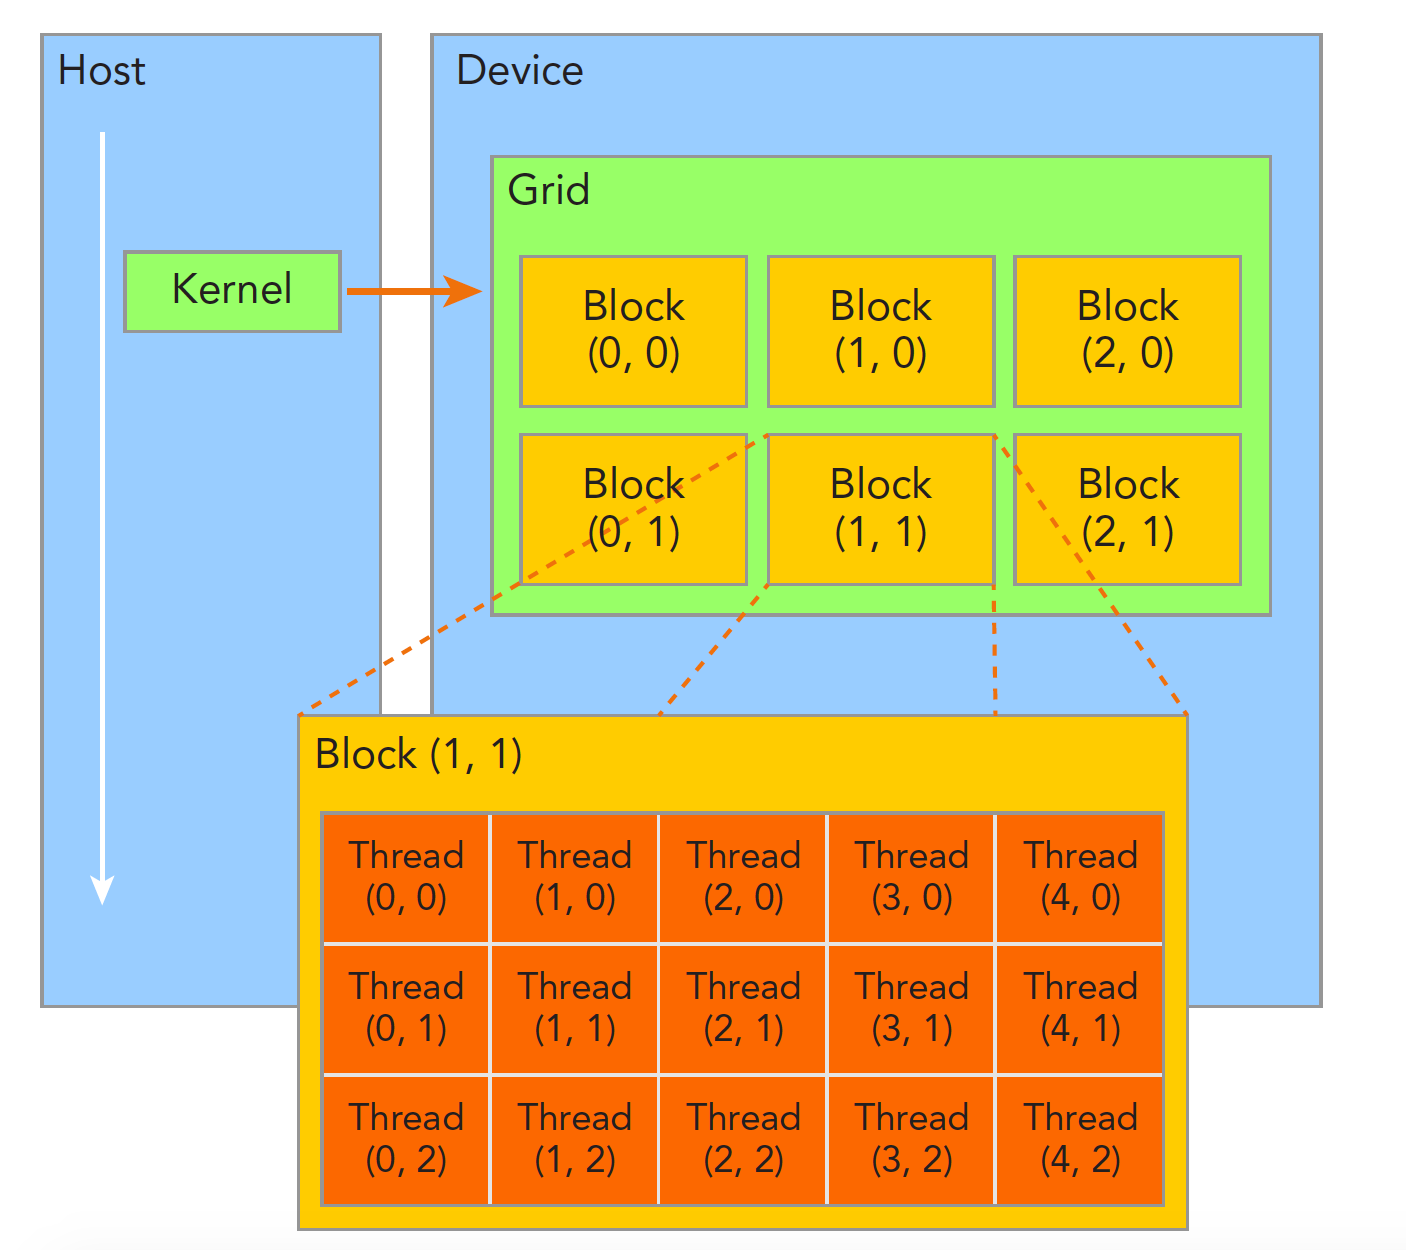
| 📊 Tầng | Ý nghĩa | Ánh xạ phần cứng |
|---|---|---|
| Grid | Mọi thread của một lần launch kernel | Toàn GPU |
| Block (khối thread) | Một nhóm thread phối hợp (tối đa 1024) | Được schedule lên một SM |
| Thread | Đơn vị thực thi nhỏ nhất | CUDA Core |
| Warp (bó thread) | 32 thread liên tiếp (nhóm ẩn) | Warp Scheduler trong SM |
5.2 Một ví dụ CUDA kernel đơn giản
Kernel cộng vector sau đây thể hiện mô hình lập trình CUDA cơ bản:
// Kernel cộng vector: C[i] = A[i] + B[i]
__global__ void vecAdd(float *A, float *B, float *C, int N) {
    // Chỉ số toàn cục mà thread hiện tại phụ trách
    int idx = blockIdx.x * blockDim.x + threadIdx.x;

    // Kiểm tra biên
    if (idx < N) {
        C[idx] = A[idx] + B[idx];
    }
}

// Host launch kernel
int main() {
    int N = 1000000;
    int threadsPerBlock = 256;
    int blocksPerGrid = (N + threadsPerBlock - 1) / threadsPerBlock;

    // <<<chiều Grid, chiều Block>>>
    vecAdd<<<blocksPerGrid, threadsPerBlock>>>(d_A, d_B, d_C, N);
    return 0;
}
Luồng thực thi: 📥 Host cấp phát bộ nhớ thiết bị và copy dữ liệu → ⚙️ launch kernel; GPU phân Block cho các SM → 📤 kernel xong, kết quả copy về Host.
5.3 Mô hình bộ nhớ và ánh xạ lưu trữ
Các cách khai báo biến khác nhau trong CUDA tương ứng với các kho phần cứng khác nhau:
| 📊 Loại bộ nhớ CUDA | Cách khai báo | Vị trí phần cứng | Phạm vi | Vòng đời |
|---|---|---|---|---|
| Register | Biến cục bộ | Register file của SM | Một thread | Kernel |
| Local Memory | Biến cục bộ bị spill | HBM (bộ nhớ thiết bị) | Một thread | Kernel |
| Shared Memory | __shared__ | Lưu trữ trên chip trong SM | Trong Block | Kernel |
| Global Memory | __device__ / cudaMalloc | HBM (bộ nhớ thiết bị) | Mọi thread | Ứng dụng |
| Constant Memory | __constant__ | HBM + cache | Mọi thread | Ứng dụng |
⚠️ Lưu ý: Dù tên có chữ “Local”, Local Memory thực tế nằm trên HBM, tốc độ truy cập chậm như Global Memory. Khi thiếu thanh ghi, trình biên dịch tự spill biến sang Local Memory; đó là register spilling, vấn đề hiệu năng cần cảnh giác.
5.4 Cảm nhận tính toán GPU qua PyTorch
Hầu hết kỹ sư AI Infra không viết CUDA C hàng ngày mà gọi gián tiếp qua framework như PyTorch. Hiểu CUDA phía dưới vẫn giúp viết PyTorch hiệu quả hơn:
import torch
import time

# Kiểm tra thông tin GPU
if torch.cuda.is_available():
    gpu = torch.cuda.get_device_properties(0)
    print(f"GPU: {gpu.name}")
    print(f"Số SM: {gpu.multi_processor_count}")
    print(f"Bộ nhớ: {gpu.total_memory / 1024**3:.1f} GB")

# So sánh hiệu năng nhân ma trận CPU vs GPU
N = 4096
A_cpu = torch.randn(N, N)
B_cpu = torch.randn(N, N)
A_gpu = A_cpu.cuda()
B_gpu = B_cpu.cuda()

# Warmup
torch.mm(A_gpu, B_gpu)
torch.cuda.synchronize()

# Đo thời gian
start = time.perf_counter()
C_cpu = torch.mm(A_cpu, B_cpu)
cpu_time = time.perf_counter() - start

torch.cuda.synchronize()
start = time.perf_counter()
C_gpu = torch.mm(A_gpu, B_gpu)
torch.cuda.synchronize()
gpu_time = time.perf_counter() - start

print(f"CPU: {cpu_time*1000:.2f} ms | GPU: {gpu_time*1000:.2f} ms | Tỷ lệ tăng tốc: {cpu_time/gpu_time:.1f}x")
6. Các chỉ số hiệu năng GPU then chốt
Để đánh giá khả năng tính toán AI của một GPU, cần theo dõi các chỉ số cốt lõi sau:
6.1 Bốn chỉ số cốt lõi
| 📊 Chỉ số | Ý nghĩa | Vì sao quan trọng |
|---|---|---|
| FLOPS (TFLOPS) | Số phép số thực mỗi giây | Quyết định trần của tác vụ compute-bound |
| Băng thông bộ nhớ (GB/s) | Lượng dữ liệu đọc/ghi bộ nhớ mỗi giây | Quyết định trần của tác vụ memory-bound |
| Dung lượng bộ nhớ (GB) | Tổng dữ liệu có thể lưu | Quyết định mô hình lớn đến đâu còn chạy được |
| Băng thông liên kết (GB/s) | Tốc độ giao tiếp giữa các GPU | Quyết định hiệu quả mở rộng đa card |
6.2 Công thức tính FLOPS đỉnh
Trước khi nói đỉnh lý thuyết, phải chốt mẫu GPU, đường thực thi, độ chính xác đầu vào và tích lũy, quy ước dense hay sparse, và tần số đồng hồ. Chỉ nói “FLOPS FP16” chưa đủ để xác định số; throughput FP16 của CUDA Core và Tensor Core khác nhau.
Công thức chung: số đơn vị tính × lượng phép mỗi đơn vị mỗi chu kỳ × số chu kỳ mỗi giây.
- : số SM thực sự bật trên GPU đó.
- : số đơn vị tính loại đã chọn trong mỗi SM.
- : số phép số thực mỗi đơn vị hoàn thành mỗi chu kỳ ở độ chính xác và chế độ đã chọn, đơn vị FLOPs/(đơn vị·chu kỳ).
- : tần số nhân khớp với thông số throughput đó, đơn vị Hz; kết quả là FLOP/s, chia ra TFLOPS. Không dùng tần số bộ nhớ, cũng không nhét thẳng tần số tối đa không áp dụng cho đường thực thi đó.
CUDA Core: nhân 2 là quy ước đếm FMA. Một FMA vô hướng () đếm một phép nhân cộng một phép cộng, tức 2 FLOPs; điều đó không có nghĩa mọi đơn vị mỗi chu kỳ chỉ làm đúng 2 FLOPs. Nếu một đơn vị FP32 đạt đỉnh một FMA vô hướng mỗi chu kỳ thì ; đổi sang FP16, FP64 hoặc lệnh khác thì phải tra lại thông số throughput của kiến trúc đó. Lệnh half2 có thể diễn đạt hai phần tử FP16, nhưng tốc độ phát lệnh mỗi chu kỳ vẫn phụ thuộc phần cứng; không ước chung bằng “số nhân FP16 × 2”. CUDA Programming Guide: arithmetic instruction throughput
Tensor Core: phải tính nhiều phép nhân-cộng mỗi chu kỳ. Gọi là số lần FMA vô hướng tương đương mà một Tensor Core hoàn thành mỗi chu kỳ; đỉnh dense là:
Ở đây là throughput bền của phần cứng; không thay bằng của một MMA, cũng không lấy nghịch đảo độ trễ một lệnh đơn giản. Pipeline cho phép nhiều thao tác độc lập chồng nhau. Nếu tài liệu đã cho FLOPs/chu kỳ thì của nhân-cộng đã nằm trong đó; đừng nhân thêm lần nữa.
Ví dụ tính: đỉnh Tensor Core dense của A100 với đầu vào FP16, tích lũy FP32. Whitepaper NVIDIA cho A100 có 108 SM, mỗi SM 4 Tensor Core; mỗi Tensor Core mỗi chu kỳ hoàn thành 256 phép nhân-cộng FP16, tức FLOPs. Lấy tần số Boost 1.41 GHz trên bảng thông số:
Cùng A100 đó, đường FP32 thường có 64 CUDA Core FP32 mỗi SM. Tính một FMA mỗi đơn vị mỗi chu kỳ rồi đổi đơn vị được TFLOPS. Hai con số cho thấy vì sao chỉ đếm “số nhân” hoặc chỉ nhìn độ rộng bit không đủ để so FLOPS. NVIDIA A100 Architecture Whitepaper, trang 20, 24 và bảng thông số
Tách đỉnh sparse khỏi hiệu năng đo thực. Khi A100 thỏa yêu cầu structured sparsity 2:4 và dùng lệnh Tensor Core sparse tương ứng, đỉnh tương đương dense của FP16 đạt khoảng 624 TFLOPS, gấp đôi đỉnh dense trên. Con số này đếm theo khối lượng phép của ma trận dense tương đương; ma trận dense thường hoặc các zero phân bố tùy ý không tự động nhận hệ số nhân đó. Khi đọc thông số hãng, hãy kiểm từng mục có ghi “with sparsity” hay không; đừng mặc định mọi TFLOPS đều đã gồm tăng tốc thưa. NVIDIA Ampere architecture deep dive
Throughput thực tế nên tính theo “khối lượng tính đã hoàn thành / thời gian đo”, ví dụ GEMM dense thường ước , rồi so với đỉnh cùng độ chính xác, đường thực thi và quy ước đếm. Hình dạng ma trận, truy cập bộ nhớ, hỗn hợp lệnh, độ song song và thay đổi tần số do công suất/nhiệt đều ảnh hưởng mức tận dụng; không có dải “30%~60% đỉnh” áp dụng phổ quát. Tính toán GPU là bất đồng bộ; đo thời gian còn cần đồng bộ đúng hoặc dùng CUDA Events.
7. So sánh ngang các GPU AI phổ biến
Dưới đây là so sánh thông số cốt lõi của các NVIDIA AI GPU phổ biến tính đến 2025:
| 📊 Mẫu | Kiến trúc | Số SM | Bộ nhớ | Băng thông | FLOPS FP16 | FLOPS FP8 | TDP | Công dụng điển hình |
|---|---|---|---|---|---|---|---|---|
| V100 | Volta | 80 | 32 GB HBM2 | 900 GB/s | 125 TFLOPS | — | 300W | Card train kinh điển |
| A100 SXM | Ampere | 108 | 80 GB HBM2e | 2,039 GB/s | 312 TFLOPS | — | 400W | Train + suy luận |
| H100 SXM | Hopper | 132 | 80 GB HBM3 | 3,350 GB/s | 989 TFLOPS | 1,979 TFLOPS | 700W | Train quy mô lớn |
| H200 | Hopper | 132 | 141 GB HBM3e | 4,800 GB/s | 989 TFLOPS | 1,979 TFLOPS | 700W | Suy luận chuỗi dài |
| B200 | Blackwell | 160 | 192 GB HBM3e | 8,000 GB/s | 2,250 TFLOPS | 4,500 TFLOPS | 1000W | Flagship thế hệ tiếp |
| L40S | Ada | 142 | 48 GB GDDR6 | 864 GB/s | 366 TFLOPS | — | 350W | Suy luận / đa phương tiện |
⚠️ Lưu ý: Cùng một kiến trúc có thể có hai dạng đóng gói SXM và PCIe. Bản SXM thường công suất cao hơn, tần số cao hơn và hỗ trợ NVLink, hiệu năng rõ ràng mạnh hơn bản PCIe. Khi chọn máy nhớ xác nhận kiểu đóng gói.
8. Quản lý bộ nhớ: thách thức cốt lõi của AI Infra
Khi train mô hình lớn, bộ nhớ thường là nút thắt gặp đầu tiên. Một mô hình 7B tham số (FP16) chỉ riêng tham số đã cần khoảng 14 GB; cộng trạng thái optimizer, gradient, activation thì chiếm dụng thực tế có thể gấp 4~8 lần lượng tham số.
8.1 Bộ nhớ khi train đi đâu hết
Với Adam + train mixed precision FP16, bộ nhớ mỗi tham số cần:
| 📊 Thành phần | Byte mỗi tham số | Ghi chú |
|---|---|---|
| Tham số FP16 | 2 B | Dùng cho forward / backward |
| Bản sao tham số FP32 | 4 B | Adam cần giữ FP32 master weights |
| Gradient FP32 | 4 B | Sinh ra từ backward |
| Moment bậc 1 Adam (m) | 4 B | Trung bình động mũ của gradient |
| Moment bậc 2 Adam (v) | 4 B | Trung bình động mũ của bình phương gradient |
| Tổng | 18 B | — |
Bộ nhớ cố định của mô hình 7B = GB, chưa kể activation.
8.2 Các chiến lược tối ưu bộ nhớ thường dùng
Trước cảnh thiếu bộ nhớ, lĩnh vực AI Infra đã phát triển một loạt chiến lược kinh điển:
| 📊 Chiến lược | Nguyên lý | Tiết kiệm bộ nhớ | Cái giá |
|---|---|---|---|
| Train mixed precision | Dùng FP16/BF16 cho forward/backward; FP32 cập nhật tham số | ~50% bộ nhớ tham số | Cần loss scaling (FP16) |
| Gradient accumulation | Cộng dồn gradient qua nhiều micro-batch, tương đương batch lớn | Giảm đỉnh activation | Tăng số bước train |
| Gradient checkpointing | Forward chỉ giữ một phần activation; backward tính lại | Bộ nhớ activation xuống | Tăng khoảng 33% tính toán |
| ZeRO | Phân mảnh trạng thái optimizer / gradient / tham số sang nhiều card | Giảm tuyến tính bộ nhớ mỗi card | Tăng lượng giao tiếp |
| Offloading | Đẩy một phần dữ liệu sang bộ nhớ CPU hoặc NVMe | Phá trần bộ nhớ một card | Băng thông PCIe thành nút thắt |
💡 Gợi ý: Các chiến lược này không loại trừ nhau; thực tế thường kết hợp. DeepSpeed ZeRO Stage 2 + mixed precision + gradient checkpointing là cấu hình phổ biến khi train mô hình trung–lớn (7B~70B).
9. Liên kết đa card: từ một máy đến cụm
Khi bộ nhớ và FLOPS một card không đủ, cần song song nhiều card. Băng thông và topology liên kết giữa các GPU quyết định trực tiếp hiệu quả train song song.
9.1 So sánh công nghệ liên kết
| 📊 Công nghệ liên kết | Băng thông | Kịch bản | Ghi chú |
|---|---|---|---|
| PCIe 5.0 | 128 GB/s (hai chiều) | Qua card (phổ quát) | Phổ biến nhưng băng thông thấp hơn |
| NVLink 4.0 (Hopper) | 900 GB/s (full duplex) | Liên kết GPU trong máy | Liên kết tốc độ cao chuyên dụng; H100 dùng |
| NVLink 5.0 (Blackwell) | 1,800 GB/s (full duplex) | Liên kết GPU trong máy | B200 dùng |
| NVSwitch | Nối mọi NVLink | Full mesh trong máy | Giao tiếp All-to-All full bandwidth |
| InfiniBand NDR | 400 Gb/s (50 GB/s) | Liên kết qua máy | Chuẩn của cụm quy mô lớn |
9.2 Topology đa card điển hình
Lấy DGX H100 (8 card) làm ví dụ:
- 8 H100 full-mesh qua NVSwitch; mọi cặp card có 900 GB/s
- Mỗi máy nối cụm qua 8 card mạng ConnectX-7 InfiniBand
- Giao tiếp trong máy >> giao tiếp giữa máy; chênh lệch băng thông này ảnh hưởng trực tiếp lựa chọn chiến lược song song
📌 Điểm then chốt: Khi thiết kế chiến lược train phân tán, hãy đặt chiều song song có lượng giao tiếp lớn (như tensor parallelism) trên NVLink trong máy băng thông cao, và chiều giao tiếp tương đối nhỏ (data parallel, pipeline parallel) trên InfiniBand giữa các máy.
# Xem thông tin topology GPU
nvidia-smi topo -m

# Xem trạng thái NVLink
nvidia-smi nvlink -s
📝 Tóm tắt
Bài này xuất phát từ khác biệt kiến trúc CPU và GPU, rồi lần vào cấu trúc bên trong GPU, phủ các điểm kiến thức cốt lõi sau:
- Vì sao chọn GPU: phép nhân ma trận của deep learning vốn hợp kiến trúc song song quy mô lớn của GPU
- Kiến trúc phần cứng: tổ chức tầng GPC → TPC → SM → CUDA Core / Tensor Core; warp là đơn vị scheduling nhỏ nhất
- Phân cấp bộ nhớ: kim tự tháp Register → Shared Memory → L1/L2 Cache → HBM; băng thông thường trở thành nút thắt trước FLOPS
- Tensor Core: đơn vị tăng tốc thiết kế cho nhân-cộng ma trận; các định dạng độ chính xác thấp như BF16/FP8 tiếp tục đẩy FLOPS lên
- Mô hình lập trình CUDA: tổ chức thread Grid → Block → Thread, và ánh xạ giữa loại bộ nhớ với phần cứng
- Đánh giá hiệu năng: bốn chỉ số cốt lõi FLOPS, băng thông, dung lượng bộ nhớ, băng thông liên kết
- Quản lý bộ nhớ: mixed precision, gradient accumulation, checkpointing, ZeRO và các chiến lược kinh điển khác
- Liên kết đa card: NVLink, NVSwitch, InfiniBand tạo nền giao tiếp từ trong máy đến cụm
Nắm những nền tảng này, bạn có đủ nhận thức phần cứng để đọc các bài nâng cao về lập trình CUDA, huấn luyện phân tán và tối ưu suy luận.
🎯 Checklist tự kiểm
- Nói được khác biệt cốt lõi về triết lý thiết kế kiến trúc giữa CPU và GPU
- Vẽ được phân cấp GPU (GPC → SM → CUDA Core / Tensor Core)
- Giải thích được khái niệm warp và vì sao warp divergence ảnh hưởng hiệu năng
- Nói được bậc dung lượng và tốc độ của từng tầng lưu trữ GPU (Register → Shared Memory → L2 → HBM)
- Dùng được mô hình Roofline để phán một kernel là compute-bound hay memory-bound
- Giải thích được khác biệt BF16 và FP16, và vì sao train mô hình lớn khuyến nghị BF16
- Liệt kê được từ 3 chiến lược tối ưu bộ nhớ trở lên cùng nguyên lý của chúng
- Dùng được
nvidia-smiđể xem trạng thái GPU và thông tin topology - Nói được chênh lệch bậc độ lớn về băng thông giữa NVLink và PCIe
- Ước được chiếm dụng bộ nhớ khi train mô hình 7B tham số với Adam + mixed precision FP16
📚 Tài liệu tham khảo
- NVIDIA CUDA C++ Programming Guide
- NVIDIA H100 Tensor Core GPU Architecture Whitepaper
- NVIDIA A100 Tensor Core GPU Architecture Whitepaper
- NVIDIA Blackwell Architecture Whitepaper
- Mixed Precision Training - NVIDIA Developer Blog
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models
- Roofline: An Insightful Visual Performance Model